Limits of a first impression
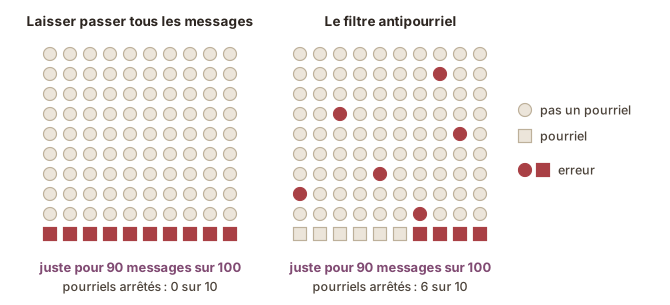
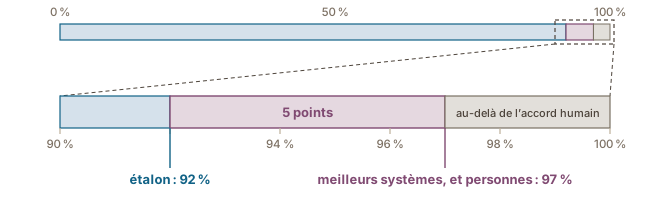
When you try out a language tool, for example a machine translation system, a spelling checker or a chatbot, the obvious way to judge it is to look at some of its results and decide whether they seem good. That first impression is useful, but it is a weak basis for a conclusion:
- it relies on the few examples you happened to try;
- it depends on your own expertise, so another person can judge the same results differently, and it does not work for a subject or a language in which your own expertise is limited;
- it cannot be compared with another person’s impression of another tool, or with your own impression of the same tool a year later.
An evaluation is a more systematic way of judging a tool. The tool is run on evaluation data chosen in advance and its output is judged by a method that is stated, so that the result can be checked, repeated and compared.
Tasks without a single correct answer
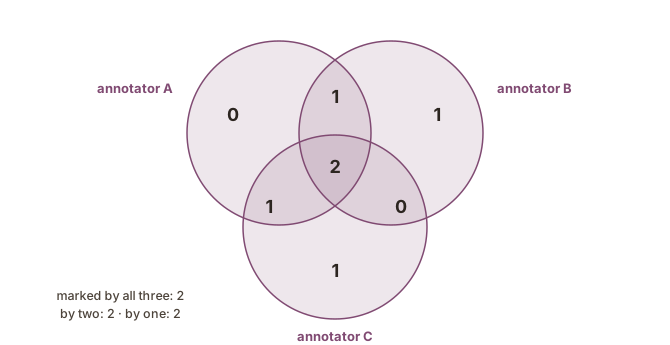
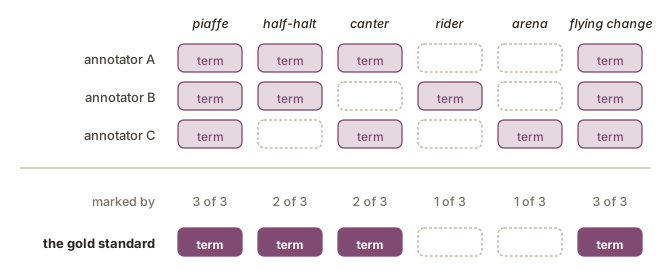
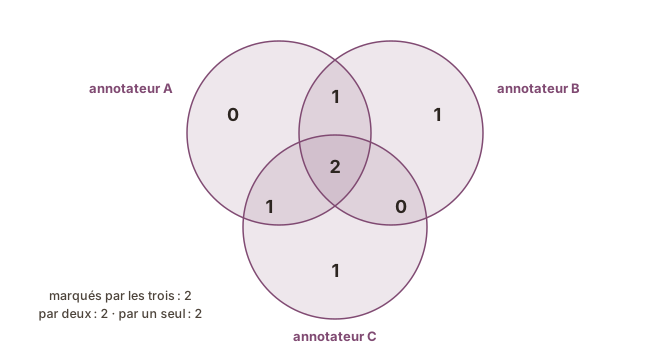
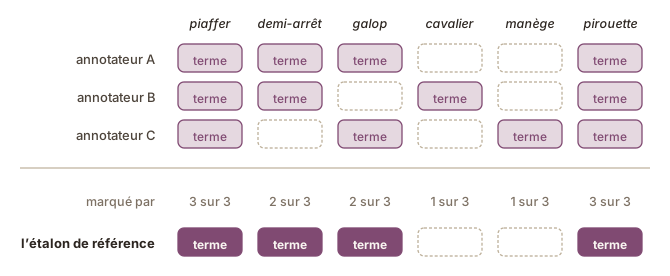
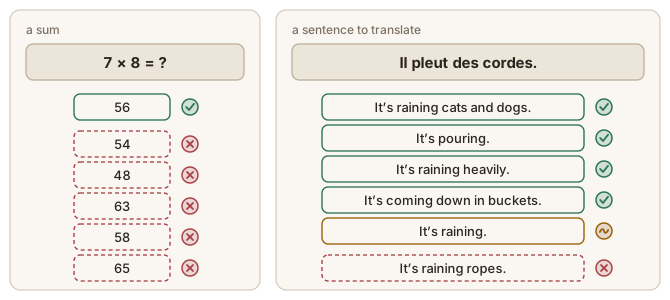
For language technology language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , a systematic evaluation is less straightforward than it seems. Many tasks in natural language processing natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. (NLP) do not have a single answer that is unquestionably correct (Basile et al., 2021). For example, a sum has one correct answer, but a sentence can be translated well in several ways (Figure 1figure 1), and two specialists who list the terms of the same text rarely produce the same list (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). An evaluation therefore has to settle what counts as correct before anything can be counted.
Evaluation data, judgement and measure
An evaluation needs three things:
- Evaluation data: the texts the system is run on, which were not used to build it (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
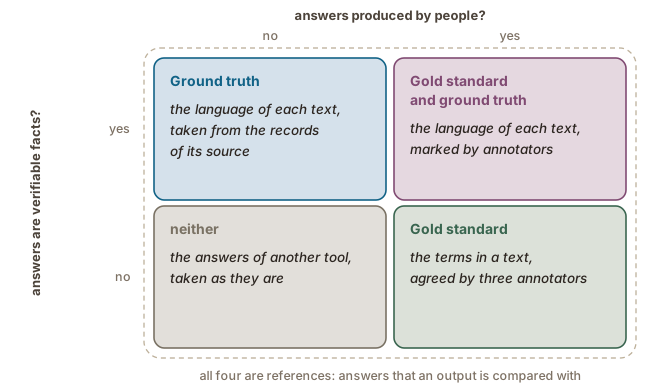
- A judgement of the output: most often a comparison with a gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , which states what the output should have been according to people (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières), but people can also judge the output directly (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
- A measure: the rule that turns the judgements into a number.
A score can only be interpreted once all three are known (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
Measures by kind of task
How the output is judged, and with which measure, depends on the kind of output a task has. The table below sets out three cases.
For tasks of the first kind, such as named entity recognition, evaluation has usually assumed that each item has one correct answer (Basile et al., 2021) (see also the Evaluating extraction and classification chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de l'extraction et de la classification, dans le module L'évaluation des technologies langagières). Tasks that produce text, such as machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , cannot be evaluated on that assumption, because many different outputs can be right (see also the Evaluating machine translation chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de la traduction automatique, dans le module L'évaluation des technologies langagières). A large language model produces text whatever the task, so its evaluation raises the same difficulty.
Sources
- Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Les limites d’une première impression
Quand vous essayez un outil langagier, par exemple un système de traduction automatique, un correcteur orthographique ou un agent conversationnel, la façon la plus évidente de le juger consiste à regarder quelques-uns de ses résultats et à décider s’ils semblent bons. Cette première impression est utile, mais c’est une base fragile pour une conclusion :
- elle dépend des quelques exemples que vous avez essayés ;
- elle dépend de votre propre expertise, de sorte qu’une autre personne peut juger les mêmes résultats autrement, et elle ne fonctionne pas pour un sujet ou une langue où votre expertise est limitée ;
- elle ne peut pas être comparée à l’impression d’une autre personne sur un autre outil, ni à votre propre impression du même outil un an plus tard.
Une évaluation est une façon plus systématique de juger un outil. L’outil fonctionne sur des données d’évaluation choisies à l’avance et sa sortie est jugée selon une méthode déclarée, de sorte que le résultat peut être vérifié, répété et comparé.
Les tâches sans réponse correcte unique
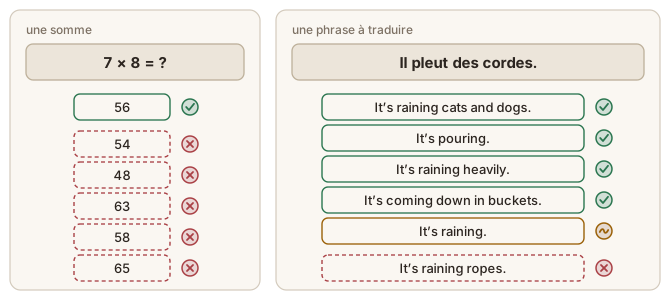
Pour les technologies langagières language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , une évaluation systématique est moins simple qu’il n’y paraît. Beaucoup de tâches du traitement automatique de la langue natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. (TAL) n’ont pas une réponse unique qui soit incontestablement correcte (Basile et al., 2021). Par exemple, une somme a une seule réponse correcte, mais une phrase peut être bien traduite de plusieurs façons (Figure 1figure 1), et deux spécialistes qui relèvent les termes d’un même texte produisent rarement la même liste (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). Une évaluation doit donc établir quelles réponses sont considérées comme correctes avant de pouvoir compter quoi que ce soit.
Données d’évaluation, jugement et mesure
Une évaluation a besoin de trois éléments :
- Des données d’évaluation : les textes sur lesquels le système fonctionne, et qui n’ont pas servi à le construire (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
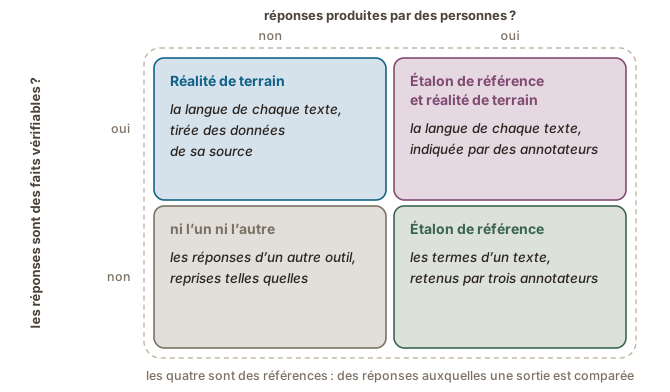
- Un jugement de la sortie : le plus souvent une comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. (angl. gold standard), qui indique quelle aurait dû être la sortie selon des personnes (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières), mais des personnes peuvent aussi juger la sortie directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
- Une mesure : la règle qui transforme les jugements en un nombre.
Un score ne peut être interprété que lorsque les trois sont connus (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
Les mesures selon le type de tâche
La façon de juger la sortie, et la mesure utilisée, dépendent du type de sortie d’une tâche. Le tableau ci-dessous présente trois cas.
Pour les tâches du premier type, comme la reconnaissance d’entités nommées, l’évaluation a généralement supposé que chaque élément a une seule réponse correcte (Basile et al., 2021) (see also the Evaluating extraction and classification chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de l'extraction et de la classification, dans le module L'évaluation des technologies langagières). Les tâches qui produisent du texte, comme la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , ne peuvent pas être évaluées à partir de cette hypothèse, parce que de nombreuses sorties différentes peuvent être correctes (see also the Evaluating machine translation chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de la traduction automatique, dans le module L'évaluation des technologies langagières). Un grand modèle de langue produit du texte quelle que soit la tâche, de sorte que son évaluation pose la même difficulté.
Sources
- Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3