Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
This teaching view only exists in French.
Extraction et classification
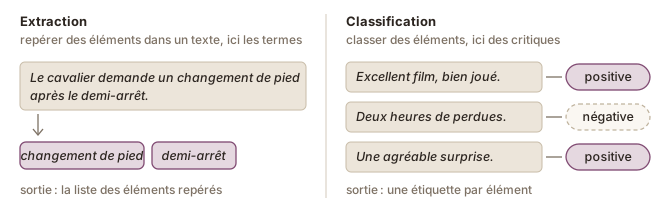
Ce chapitre porte sur deux types de système (Figure 1figure 1) :
- les systèmes qui repèrent des éléments dans un texte, comme un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. ou un système de reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- les systèmes qui classent des éléments (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), comme un filtre antipourriel, ou un système qui étiquette une critique comme positive ou négative.
De tels systèmes sont le plus souvent évalués en comparant leur sortie à un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , les réponses que des personnes ont données pour les mêmes données (see also the gold standard page) (voir aussi la page L'étalon de référence). Plusieurs mesures permettent de transformer cette comparaison en score. Ce chapitre se concentre sur trois mesures couramment utilisées ensemble : la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. et le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
Un exemple de chaque erreur
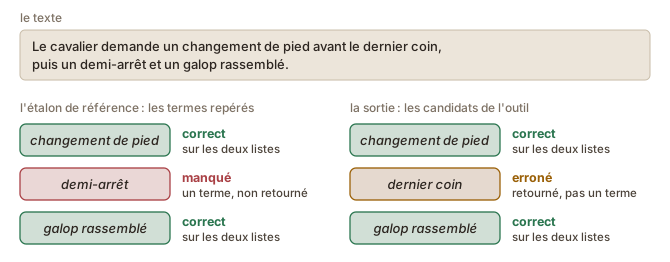
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre (Figure 2figure 2) :
- l’outil propose une liste de trois candidats : changement de pied, dernier coin et galop rassemblé ;
- l’étalon de référence est une liste de trois termes : changement de pied, demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil a aussi fait deux erreurs, de types différents :
- dernier coin a été proposé, mais ce n’est pas un terme ;
- demi-arrêt est un terme, mais il n’a pas été trouvé.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque décision correspond à l’un de quatre cas, définis dans les encadrés ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des vrais positifs, dernier coin est un faux positif et demi-arrêt est un faux négatif. Les vrais négatifs sont tout le reste du texte. La Figure 3figure 3 construit les quatre cas pour un extracteur de termes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de tableau, appelé matrice de confusion, pour un système qui classe des éléments en deux classes, comme un filtre antipourriel : un message arrêté par erreur est un faux positif, et un pourriel qui arrive dans la boîte de réception est un faux négatif.
| Dans l’étalon de référence | Absent de l’étalon de référence | |
|---|---|---|
| Trouvé par le système | vrai positif | faux positif |
| Non trouvé par le système | faux négatif | vrai négatif |
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce qui y manque.
Les vrais négatifs
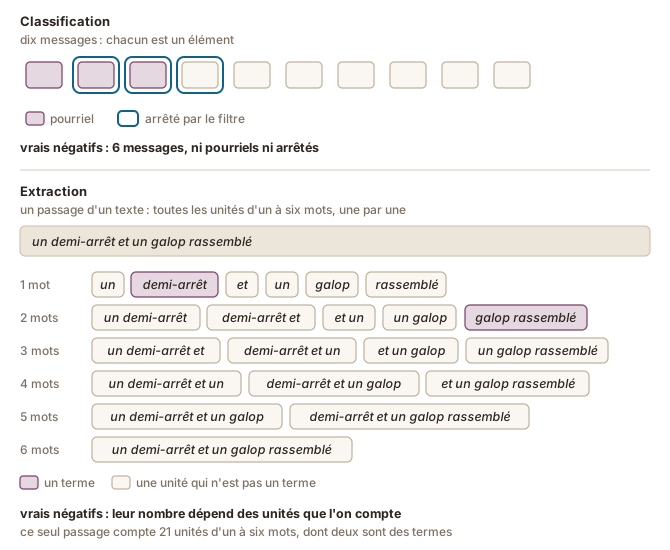
Le quatrième cas n’est pas le même pour les deux types de système (Figure 4figure 4) :
- Pour un filtre antipourriel, chaque message est un élément : les vrais négatifs, les messages qui ne sont pas des pourriels et que le filtre a laissés passer, peuvent donc être comptés.
- Pour un système qui repère des éléments dans un texte, comme un extracteur de termes, les vrais négatifs seraient chaque mot et chaque suite de mots qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en longueur et se chevauchent : leur nombre n’est donc pas bien défini (Hripcsak & Rothschild, 2005).
Les scores les plus utilisés pour les deux types de système, la précision et le rappel, se calculent à partir des trois autres cas seulement (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
Le compromis entre les deux erreurs
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste, moins il manque de termes, et plus il y a de bruit. Une évaluation indique donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Extraction et classification
Ce chapitre porte sur deux types de système (Figure 1figure 1) :
- les systèmes qui repèrent des éléments dans un texte, comme un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. ou un système de reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- les systèmes qui classent des éléments (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), comme un filtre antipourriel, ou un système qui étiquette une critique comme positive ou négative.
De tels systèmes sont le plus souvent évalués en comparant leur sortie à un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , les réponses que des personnes ont données pour les mêmes données (see also the gold standard page) (voir aussi la page L'étalon de référence). Plusieurs mesures permettent de transformer cette comparaison en score. Ce chapitre se concentre sur trois mesures couramment utilisées ensemble : la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. et le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
Un exemple de chaque erreur
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre (Figure 2figure 2) :
- l’outil propose une liste de trois candidats : changement de pied, dernier coin et galop rassemblé ;
- l’étalon de référence est une liste de trois termes : changement de pied, demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil a aussi fait deux erreurs, de types différents :
- dernier coin a été proposé, mais ce n’est pas un terme ;
- demi-arrêt est un terme, mais il n’a pas été trouvé.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque décision correspond à l’un de quatre cas, définis dans les encadrés ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des vrais positifs, dernier coin est un faux positif et demi-arrêt est un faux négatif. Les vrais négatifs sont tout le reste du texte. La Figure 3figure 3 construit les quatre cas pour un extracteur de termes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de tableau, appelé matrice de confusion, pour un système qui classe des éléments en deux classes, comme un filtre antipourriel : un message arrêté par erreur est un faux positif, et un pourriel qui arrive dans la boîte de réception est un faux négatif.
| Dans l’étalon de référence | Absent de l’étalon de référence | |
|---|---|---|
| Trouvé par le système | vrai positif | faux positif |
| Non trouvé par le système | faux négatif | vrai négatif |
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système (Figure 4figure 4) :
- Pour un filtre antipourriel, chaque message est un élément : les vrais négatifs, les messages qui ne sont pas des pourriels et que le filtre a laissés passer, peuvent donc être comptés.
- Pour un système qui repère des éléments dans un texte, comme un extracteur de termes, les vrais négatifs seraient chaque mot et chaque suite de mots qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en longueur et se chevauchent : leur nombre n’est donc pas bien défini (Hripcsak & Rothschild, 2005).
Les scores les plus utilisés pour les deux types de système, la précision et le rappel, se calculent à partir des trois autres cas seulement (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
Le compromis entre les deux erreurs
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste, moins il manque de termes, et plus il y a de bruit. Une évaluation indique donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
La précision et le rappel
Pour un système qui repère des éléments dans un texte, ou qui classe des éléments en deux classes, la comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. donne deux scores (Jurafsky & Martin, 2026). La Figure 6figure 6 montre les parties à partir desquelles ils se calculent, pour un extracteur de termes.
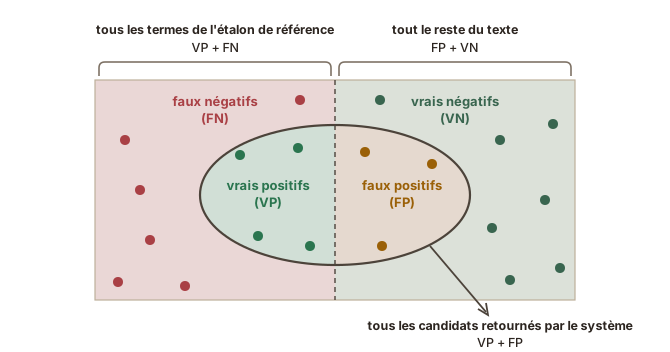
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous paraîtra peut-être plus claire que les autres :
- Précision
- sous forme de formule : précision = VP / (VP + FP) ;
- sous forme de part : les vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divisés par tout ce que le système a trouvé, pour un extracteur de termes tous ses candidats ;
- sous forme de question : de tout ce que le système a trouvé, quelle part est correcte ?
- les faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , la font baisser.
- Rappel
- sous forme de formule : rappel = VP / (VP + FN) ;
- sous forme de part : les vrais positifs divisés par tout ce que contient l’étalon de référence, pour un extracteur de termes tous ses termes ;
- sous forme de question : de tout ce que contient l’étalon de référence, quelle part le système a-t-il trouvée ?
- les faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , le font baisser.
Un exemple détaillé
Dans cet exemple, un extracteur de termes propose dix candidats pour un court texte sur le dressage, et l’étalon de référence de ce texte compte neuf termes (Figure 7figure 7).
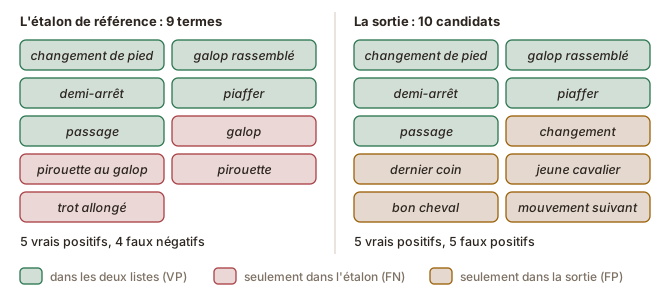
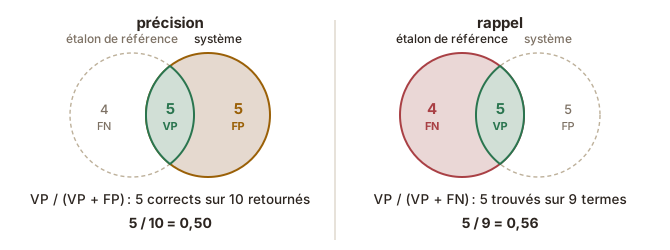
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs, 5 faux positifs et 4 faux négatifs (Figure 8figure 8) :
- précision = 5 / (5 + 5) = 0,50 ;
- rappel = 5 / (5 + 4) = 0,56.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
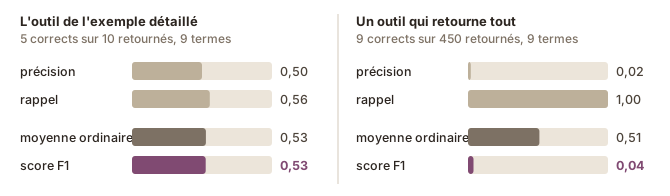
Il vaut deux fois leur produit, divisé par leur somme : F1 = 2 × précision × rappel / (précision + rappel), ici 2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus proche de la plus basse des deux valeurs que ne le serait une moyenne ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon score en ne faisant qu’une seule chose. Par exemple, si un outil proposait chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait, une précision proche de zéro et un score F1 proche de zéro (Figure 9figure 9).
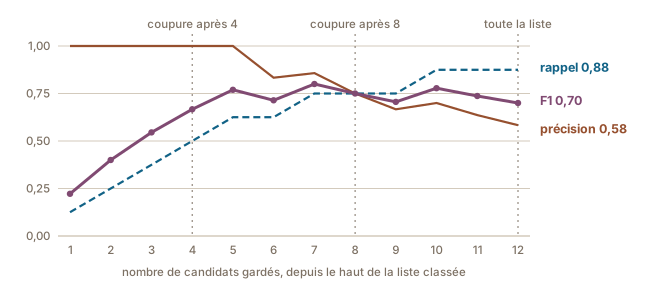
Les scores changent avec le nombre de candidats qu’un outil propose. La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des courriels en urgents, normaux et pourriels, la précision et le rappel se calculent pour chaque classe. On fait ensuite la moyenne des scores des classes (macromoyenne), ou on regroupe les décisions de toutes les classes avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente pèse le plus sur le résultat (Jurafsky & Martin, 2026).
L’exactitude
Le score le plus évident est l’exactitude.
Contrairement à la précision et au rappel, l’exactitude compte aussi les vrais négatifs true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : exactitude = (VP + VN) / (VP + FP + FN + VN). Autrement dit, l’exactitude est le nombre de décisions correctes, positives ou négatives, divisé par le nombre total de décisions. Elle peut se calculer pour un système qui classe des éléments, où les vrais négatifs peuvent être comptés, mais pas pour un système qui repère des éléments dans un texte (see also the False positives and false negatives page) (voir aussi la page Faux positifs et faux négatifs).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10 de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6 messages qui ne sont pas des pourriels.
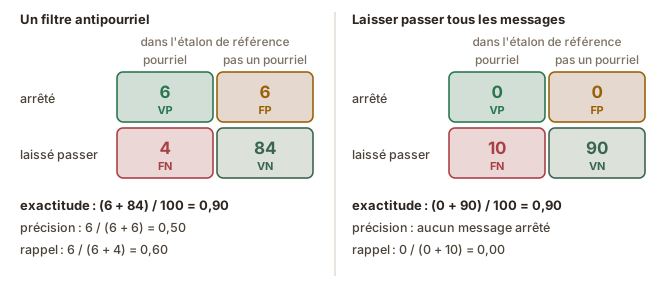
L’exactitude est trompeuse quand la classe à trouver est rare, comme le montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus extrême : un million de publications sur les réseaux sociaux, dont une centaine portent sur le produit qu’une entreprise veut suivre. Un système qui étiquette chaque publication comme ne portant pas sur le produit a raison pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La précision et le rappel ne comptent pas les vrais négatifs : le même système a donc un rappel de zéro (see also the Baselines page) (voir aussi la page Les étalons).
La précision et le rappel
Pour un système qui repère des éléments dans un texte, ou qui classe des éléments en deux classes, la comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. donne deux scores (Jurafsky & Martin, 2026). La Figure 6figure 6 montre les parties à partir desquelles ils se calculent, pour un extracteur de termes.
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous paraîtra peut-être plus claire que les autres :
- Précision
- sous forme de formule : précision = VP / (VP + FP) ;
- sous forme de part : les vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divisés par tout ce que le système a trouvé, pour un extracteur de termes tous ses candidats ;
- sous forme de question : de tout ce que le système a trouvé, quelle part est correcte ?
- les faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , la font baisser.
- Rappel
- sous forme de formule : rappel = VP / (VP + FN) ;
- sous forme de part : les vrais positifs divisés par tout ce que contient l’étalon de référence, pour un extracteur de termes tous ses termes ;
- sous forme de question : de tout ce que contient l’étalon de référence, quelle part le système a-t-il trouvée ?
- les faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , le font baisser.
Un exemple détaillé
Dans cet exemple, un extracteur de termes propose dix candidats pour un court texte sur le dressage, et l’étalon de référence de ce texte compte neuf termes (Figure 7figure 7).
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs, 5 faux positifs et 4 faux négatifs (Figure 8figure 8) :
- précision = 5 / (5 + 5) = 0,50 ;
- rappel = 5 / (5 + 4) = 0,56.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme : F1 = 2 × précision × rappel / (précision + rappel), ici 2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus proche de la plus basse des deux valeurs que ne le serait une moyenne ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon score en ne faisant qu’une seule chose. Par exemple, si un outil proposait chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait, une précision proche de zéro et un score F1 proche de zéro (Figure 9figure 9).
Les scores changent avec le nombre de candidats qu’un outil propose. La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des courriels en urgents, normaux et pourriels, la précision et le rappel se calculent pour chaque classe. On fait ensuite la moyenne des scores des classes (macromoyenne), ou on regroupe les décisions de toutes les classes avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente pèse le plus sur le résultat (Jurafsky & Martin, 2026).
L’exactitude
Le score le plus évident est l’exactitude.
Contrairement à la précision et au rappel, l’exactitude compte aussi les vrais négatifs true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : exactitude = (VP + VN) / (VP + FP + FN + VN). Autrement dit, l’exactitude est le nombre de décisions correctes, positives ou négatives, divisé par le nombre total de décisions. Elle peut se calculer pour un système qui classe des éléments, où les vrais négatifs peuvent être comptés, mais pas pour un système qui repère des éléments dans un texte (see also the False positives and false negatives page) (voir aussi la page Faux positifs et faux négatifs).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10 de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6 messages qui ne sont pas des pourriels.
L’exactitude est trompeuse quand la classe à trouver est rare, comme le montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus extrême : un million de publications sur les réseaux sociaux, dont une centaine portent sur le produit qu’une entreprise veut suivre. Un système qui étiquette chaque publication comme ne portant pas sur le produit a raison pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La précision et le rappel ne comptent pas les vrais négatifs : le même système a donc un rappel de zéro (see also the Baselines page) (voir aussi la page Les étalons).
Les deux listes
Les exercices ci-dessous portent sur un extracteur de termes qui propose six candidats pour un court texte sur le dressage. L’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. de ce texte compte huit termes. Le tableau ci-dessous donne les deux listes.
| Liste | Unités |
|---|---|
| Dans l’étalon de référence (8 termes) | épaule en dedans, appuyer, reculer, trot allongé, pas rassemblé, contre-galop, cession à la jambe, travers |
| Proposés par l’outil (6 candidats) | épaule en dedans, appuyer, trot allongé, contre-galop, grand côté, bon rythme |
Exercices
What is the precision of the tool? Round the answer to two decimals.
Quelle est la précision de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
Four of the six candidates are in the gold standard. Precision is the share of the candidates that are correct: 4 / 6 = 0.67.
Quatre des six candidats figurent dans la référence. La précision est la part des candidats qui sont corrects : 4 / 6 = 0,67.
What is the recall of the tool?
Quel est le rappel de l'outil ?
Show the explanationVoir l'explication
The gold standard has eight terms and the tool found four of them. Recall is the share of the terms of the gold standard that the tool found: 4 / 8 = 0.50.
La référence compte huit termes et l'outil en a trouvé quatre. Le rappel est la part des termes de la référence que l'outil a trouvés : 4 / 8 = 0,50.
What is the F1 score of the tool? Round the answer to two decimals.
Quel est le score F1 de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
The F1 score is twice the product of precision and recall, divided by their sum: 2 × 0.67 × 0.50 / (0.67 + 0.50) = 0.57. It lies between the two values, closer to the lower one.
Le score F1 vaut deux fois le produit de la précision et du rappel, divisé par leur somme : 2 × 0,67 × 0,50 / (0,67 + 0,50) = 0,57. Il se situe entre les deux valeurs, plus près de la plus basse.
A second tool returns twenty candidates for the same text, and all eight terms of the gold standard are among them. Which of the following statements is true?
Un deuxième outil propose vingt candidats pour le même texte, et les huit termes de la référence en font partie. Lequel des énoncés suivants est exact ?
Show the solutionVoir la solution
The second tool has a recall of 8 / 8 = 1.00 and a precision of 8 / 20 = 0.40. Its F1 score is therefore 2 × 0.40 × 1.00 / (0.40 + 1.00) = 0.57, the same as the first tool's.
Two tools can reach the same F1 score with opposite errors: the first misses half of the terms, and most of the second tool's candidates are not terms. That is why an evaluation reports precision and recall as well as the F1 score.
Le deuxième outil a un rappel de 8 / 8 = 1,00 et une précision de 8 / 20 = 0,40. Son score F1 est donc de 2 × 0,40 × 1,00 / (0,40 + 1,00) = 0,57, comme celui du premier outil.
Deux outils peuvent obtenir le même score F1 avec des erreurs opposées : le premier manque la moitié des termes, et la plupart des candidats du second ne sont pas des termes. C'est pourquoi une évaluation indique la précision et le rappel en plus du score F1.
Les réponses : 4 vrais positifs, 2 faux positifs, 4 faux négatifs ; précision 4 / 6 = 0,67, rappel 4 / 8 = 0,50, F1 0,57. Les exercices eux-mêmes sont sur la page, avec la vérification automatique.
Les décisions de correspondance
Les scores d’un système qui repère des éléments dans un texte dépendent de la rigueur avec laquelle une réponse doit correspondre à l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. pour compter comme correcte (see also the Interpreting a score page) (voir aussi la page Interpréter un score). Les mêmes décisions se posent pour toute tâche de ce genre. Le tableau ci-dessous les donne pour l’extraction de termes (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) et pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , qui repère les noms de personnes, de lieux et d’organisations dans un texte.
| Décision | Extraction de termes | Reconnaissance d’entités nommées |
|---|---|---|
| Éléments uniques ou occurrences | chaque terme une seule fois, ou chacune de ses occurrences dans le texte | chaque nom une seule fois, ou chacune de ses mentions dans le texte |
| Correspondances partielles | si galop est faux, à moitié juste ou juste quand l’étalon de référence contient galop rassemblé | si Curie est faux, à moitié juste ou juste quand l’étalon de référence contient Marie Curie |
| Unités imbriquées | seulement les termes les plus longs, ou aussi les termes plus courts qu’ils contiennent, comme galop dans galop rassemblé | seulement les noms les plus longs, ou aussi les noms qu’ils contiennent, comme Paris dans Université de Paris |
| Forme | si les majuscules, les pluriels et les variantes orthographiques donnent la même réponse | si les majuscules et les variantes orthographiques, comme Tchaïkovski et Tchaïkovsky, donnent la même réponse |
| Étiquettes | si un terme doit aussi avoir la bonne étiquette, quand l’étalon de référence étiquette ses termes | si un nom doit aussi avoir le bon type, comme personne ou lieu |
| Seuil | toute la liste classée, ou son haut | un seuil sur la confiance du système, quand il en indique une |
Pour la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , la plupart de ces décisions ne se posent pas : chaque élément, comme un message, est une unité aux limites fixes, et le système lui attribue une classe. Jurafsky et Martin (2026) font remarquer que la reconnaissance d’entités nommées comporte une étape de segmentation, qui décide où chaque nom commence et finit, que la classification de textes n’a pas, et que cette étape complique son évaluation.
Dans Figure 12figure 12, par exemple, les mêmes quatre candidats obtiennent un score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. de 0,25, de 0,50 ou de 0,75, selon la décision sur la forme.
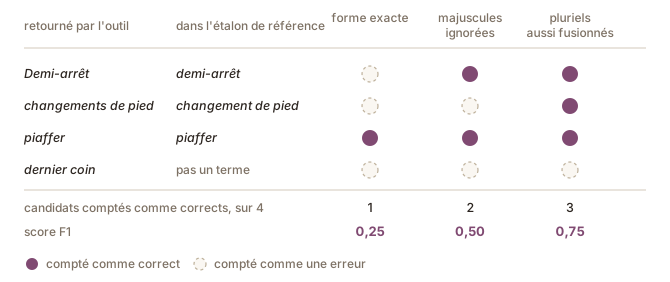
Quatre constats montrent à quel point ces décisions peuvent changer les scores :
- Correspondances partielles en reconnaissance d’entités nommées. Quand l’unité comptée est le nom, un système qui propose Jane là où l’étalon de référence contient Jane Villanueva fait deux erreurs à la fois : un faux positif false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. pour Jane et un faux négatif false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. pour Jane Villanueva (Jurafsky & Martin, 2026).
- Correspondances partielles et seuil en extraction de termes. Les scores publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon que les correspondances partielles sont acceptées ou non, et ils changent avec l’endroit où une liste classée est coupée (Rigouts Terryn et al., 2019).
- Termes uniques ou occurrences. Les scores calculés sur chaque occurrence dans le texte et les scores calculés sur une liste de termes uniques peuvent mener à des conclusions différentes, par exemple sur la langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al., 2022b).
- Forme. Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. donne parfois une forme qui ne figure pas telle quelle dans le texte, comme follow-up là où le texte a follow up (Rigouts Terryn, 2026).
Les candidats entre le juste et le faux
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de candidats d’un extracteur de termes se situent entre les deux (Figure 13figure 13) :
- le candidat est une partie d’un terme de l’étalon de référence ;
- le candidat est un terme de l’étalon de référence auquel s’ajoute un autre mot ;
- le candidat serait un terme pour certains usages, mais pas pour d’autres.
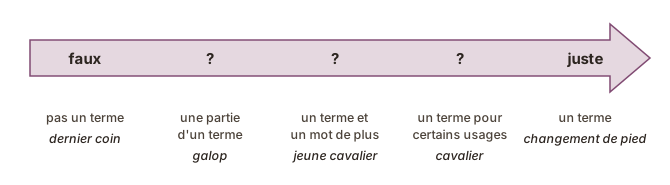
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop. Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus souple en accepte certains et donne des scores plus élevés : des scores obtenus avec des règles différentes ne peuvent donc pas être comparés.
Les décisions de correspondance
Les scores d’un système qui repère des éléments dans un texte dépendent de la rigueur avec laquelle une réponse doit correspondre à l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. pour compter comme correcte (see also the Interpreting a score page) (voir aussi la page Interpréter un score). Les mêmes décisions se posent pour toute tâche de ce genre. Le tableau ci-dessous les donne pour l’extraction de termes (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) et pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , qui repère les noms de personnes, de lieux et d’organisations dans un texte.
| Décision | Extraction de termes | Reconnaissance d’entités nommées |
|---|---|---|
| Éléments uniques ou occurrences | chaque terme une seule fois, ou chacune de ses occurrences dans le texte | chaque nom une seule fois, ou chacune de ses mentions dans le texte |
| Correspondances partielles | si galop est faux, à moitié juste ou juste quand l’étalon de référence contient galop rassemblé | si Curie est faux, à moitié juste ou juste quand l’étalon de référence contient Marie Curie |
| Unités imbriquées | seulement les termes les plus longs, ou aussi les termes plus courts qu’ils contiennent, comme galop dans galop rassemblé | seulement les noms les plus longs, ou aussi les noms qu’ils contiennent, comme Paris dans Université de Paris |
| Forme | si les majuscules, les pluriels et les variantes orthographiques donnent la même réponse | si les majuscules et les variantes orthographiques, comme Tchaïkovski et Tchaïkovsky, donnent la même réponse |
| Étiquettes | si un terme doit aussi avoir la bonne étiquette, quand l’étalon de référence étiquette ses termes | si un nom doit aussi avoir le bon type, comme personne ou lieu |
| Seuil | toute la liste classée, ou son haut | un seuil sur la confiance du système, quand il en indique une |
Pour la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , la plupart de ces décisions ne se posent pas : chaque élément, comme un message, est une unité aux limites fixes, et le système lui attribue une classe. Jurafsky et Martin (2026) font remarquer que la reconnaissance d’entités nommées comporte une étape de segmentation, qui décide où chaque nom commence et finit, que la classification de textes n’a pas, et que cette étape complique son évaluation.
Dans Figure 12figure 12, par exemple, les mêmes quatre candidats obtiennent un score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. de 0,25, de 0,50 ou de 0,75, selon la décision sur la forme.
Quatre constats montrent à quel point ces décisions peuvent changer les scores :
- Correspondances partielles en reconnaissance d’entités nommées. Quand l’unité comptée est le nom, un système qui propose Jane là où l’étalon de référence contient Jane Villanueva fait deux erreurs à la fois : un faux positif false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. pour Jane et un faux négatif false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. pour Jane Villanueva (Jurafsky & Martin, 2026).
- Correspondances partielles et seuil en extraction de termes. Les scores publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon que les correspondances partielles sont acceptées ou non, et ils changent avec l’endroit où une liste classée est coupée (Rigouts Terryn et al., 2019).
- Termes uniques ou occurrences. Les scores calculés sur chaque occurrence dans le texte et les scores calculés sur une liste de termes uniques peuvent mener à des conclusions différentes, par exemple sur la langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al., 2022b).
- Forme. Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. donne parfois une forme qui ne figure pas telle quelle dans le texte, comme follow-up là où le texte a follow up (Rigouts Terryn, 2026).
Les candidats entre le juste et le faux
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de candidats d’un extracteur de termes se situent entre les deux (Figure 13figure 13) :
- le candidat est une partie d’un terme de l’étalon de référence ;
- le candidat est un terme de l’étalon de référence auquel s’ajoute un autre mot ;
- le candidat serait un terme pour certains usages, mais pas pour d’autres.
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop. Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus souple en accepte certains et donne des scores plus élevés : des scores obtenus avec des règles différentes ne peuvent donc pas être comparés.
Un annotateur comme étalon de référence
L’accord inter-annotateurs inter-annotator agreement (IAA)accord inter-annotateurs evaluationévaluation How far two or more people who annotate the same data independently give the same answers.Mesure dans laquelle deux personnes ou plus qui annotent les mêmes données séparément donnent les mêmes réponses. mesure à quel point des personnes qui annotent les mêmes données séparément sont d’accord, et donc à quel point un étalon de référence est fiable (see also the Agreement between annotators page) (voir aussi la page L'accord entre annotateurs). Il existe plusieurs mesures de cet accord. Quand deux personnes ont chacune dressé la liste des termes d’un même texte, leur accord peut se mesurer avec les scores de ce chapitre, en prenant une des listes comme étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. et en évaluant l’autre comme la sortie d’un système :
- les termes qui figurent sur les deux listes sont des vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. ;
- les termes qui ne figurent que sur la deuxième liste sont des faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. ;
- les termes qui ne figurent que sur la première liste sont des faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. .
Dans Figure 14figure 14, la liste de l’annotateur A compte cinq termes et celle de l’annotateur B, six, et quatre termes figurent sur les deux listes. Avec A comme étalon de référence, B a une précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. de 4 / 6 et un rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. de 4 / 5. Avec B comme étalon de référence, les deux valeurs s’inversent. Le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. vaut 0,73 dans les deux cas : l’accord inter-annotateurs entre deux personnes est donc un seul nombre, quelle que soit celle qui sert d’étalon de référence. Avec trois annotateurs ou plus, on compare chaque paire à tour de rôle et on fait la moyenne des scores.
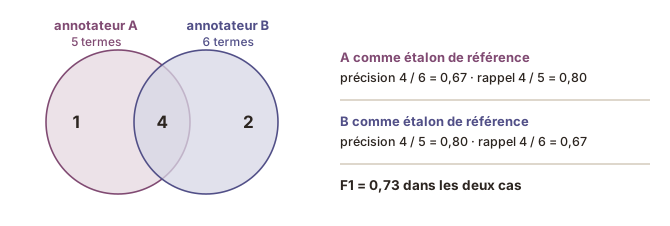
Cette mesure convient à l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. de termes et d’autres éléments repérés dans un texte, où il n’y a pas de liste fixe d’éléments et où l’on ne peut pas compter ce que personne n’a repéré (Hripcsak & Rothschild, 2005) (see also the False positives and false negatives page) (voir aussi la page Faux positifs et faux négatifs).
Mesuré ainsi, l’accord inter-annotateurs est sur la même échelle que le score d’un système, et les deux peuvent être comparés directement.