Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
This teaching view only exists in French.
Groupe de sept environ, donc le tour de table peut prendre son temps : compter une quinzaine de minutes. Noter qui vient de quel programme, cela servira à composer les équipes une fois les inscriptions finales, le 16 septembre 2026.
Ce que vous trouverez ici
Bienvenue dans TRA6008. Tout ce qui concerne le cours se trouve ici, tenu à jour tout au long du trimestre.
Qui je suis
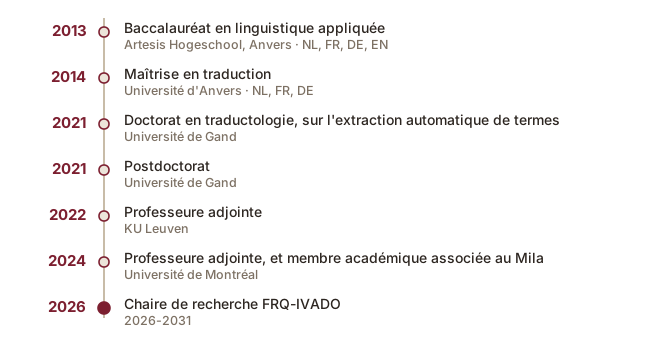
Je m’appelle Ayla Rigouts Terryn.
Ce que fait ce cours
- Comprendre ce que font ces systèmes, comment ils sont construits et où ils échouent.
- Explorer un outil nouveau par vous-mêmes, efficacement, sans attendre qu’on vous le montre : les outils changeront, cette autonomie restera.
- Évaluer : mesurer ce que fait une technologie, interpréter des résultats publiés, et composer avec le cas ordinaire de la traduction, où il n’existe pas une seule bonne réponse à laquelle se comparer.
Les trois volets
Le trimestre tient en trois fois trois : trois séances de théorie, trois modules en ligne, trois projets d’équipe.
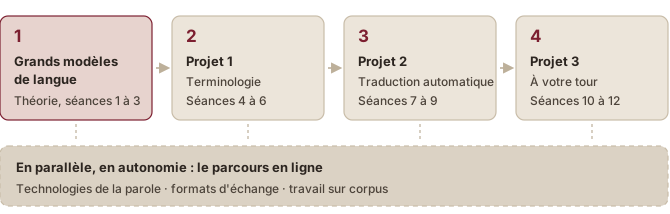
Les trois séances de théorie, en septembre, portent sur les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) : comment ils sont construits, ce qu’ils font bien, ce qu’ils font mal. Elles ne sont pas notées et il n’y a pas d’examen de théorie. Cette matière sert les projets, où vous vous en servirez constamment.
Le parcours en ligne se fait seul, à votre rythme, en dehors des séances. Ses trois modules portent sur des technologies langagières que les projets ne touchent pas : la parole, les formats d’échange et le travail sur corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. . Il vaut 10 % (see also the online path page) (voir aussi la page Le parcours en ligne).
Les trois projets d’équipe occupent le reste du trimestre. Ils reprennent le même schéma sur trois tâches différentes, et l’autonomie qu’ils vous demandent augmente de l’un à l’autre (see also the three projects page) (voir aussi la page Les trois projets).
Ce cours ne porte donc pas uniquement sur les GML, même s’ils y occupent une grande place. La démarche d’évaluation que vous apprenez dans les projets vaut pour n’importe quelle technologie langagière.
La première séance
La première séance, le 3 septembre 2026, sert à poser les bases pratiques et à entrer dans la matière :
- le plan de cours, le calendrier et les échéances du trimestre ;
- comment le cours se sert de l’intelligence artificielle, et ce qui est attendu de vous à ce sujet ;
- ce qui se trouve sur ce site et ce qui se trouve sur StudiUM ;
- l’annonce du Projet 1 ;
- une entrée en matière sur les grands modèles de langue.
Le Projet 1 est annoncé dès cette séance, mais ses consignes détaillées arrivent à la séance 3 et son travail d’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. commence à la séance 4. Le mois de septembre appartient à la théorie et au parcours en ligne.
À main levée, puis laisser parler deux ou trois personnes. Le but est de savoir où se situe le groupe, pas d’ouvrir le débat : la position du cours vient plus tard dans la séance.
Noter les réponses : elles servent de point de comparaison à la fin du trimestre.
Description officielle
Utilisation et fonctionnement général des systèmes de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. et de traduction assistée par ordinateur computer-assisted translation (CAT)traduction assistée par ordinateur (TAO) CAT toolsTAO Software that assists a human translator during the translation process, commonly by dividing texts into segments and providing functions such as translation-memory retrieval, terminology management, consistency checks and file management.Logiciel qui assiste un traducteur humain pendant le processus de traduction, généralement en divisant les textes en segments et en offrant des fonctions comme la recherche en mémoire de traduction, la gestion terminologique, les vérifications de cohérence et la gestion des fichiers. , ainsi que les divers outils d’aide à la traduction.
Introduction
Ce séminaire porte sur les technologies de la traduction dans un contexte marqué par l’essor de l’intelligence artificielle artificial intelligence (AI)intelligence artificielle (IA) AIIA A field of research and practice concerned with developing computer systems that perform functions associated with intelligence, such as perception, learning, reasoning, language use, and decision-making. By extension, the term also refers to the systems themselves, as in the increasingly common expression "an AI". For this second sense, the OECD defines an AI system as "a machine-based system that, for explicit or implicit objectives, infers, from the input it receives, how to generate outputs such as predictions, content, recommendations, or decisions that can influence physical or virtual environments. Different AI systems vary in their levels of autonomy and adaptiveness after deployment" (Grobelnik et al., 2024).Domaine de recherche et de pratique visant à développer des systèmes informatiques qui accomplissent des fonctions associées à l'intelligence, comme la perception, l'apprentissage, le raisonnement, l'usage de la langue et la prise de décision. Par extension, le terme désigne aussi les systèmes eux-mêmes, comme dans l'expression de plus en plus courante « une IA ». Pour ce second sens, l'OCDE définit un système d'IA comme un système automatisé qui, pour des objectifs explicites ou implicites, déduit à partir des entrées reçues comment générer des sorties telles que des prédictions, du contenu, des recommandations ou des décisions pouvant influencer des environnements physiques ou virtuels, les systèmes d'IA variant dans leur degré d'autonomie et d'adaptativité après leur déploiement (Grobelnik et al., 2024, traduction libre). et, en particulier, des grands modèles de langue (GML). Il vise à former des utilisateurs et utilisatrices capables d’exploiter ces technologies de manière efficace et de les évaluer de manière rigoureuse.
L’apprentissage est majoritairement axé sur des projets, soutenus par des apports théoriques ciblés. Vous travaillez en équipes sur des tâches inspirées de la pratique professionnelle et développez progressivement votre autonomie : les premiers projets sont fortement encadrés, le dernier suppose que l’équipe conçoive elle-même sa démarche.
Une attention particulière est portée à l’évaluation : comment mesurer ce que fait une technologie, à quelles conditions les résultats obtenus sont interprétables, et ce que signifie, pour certaines tâches, l’absence de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. unique à laquelle se comparer.
Objectifs généraux
Le séminaire de traductique vise à vous initier à l’utilisation et au fonctionnement général des systèmes de traduction automatique et de traduction assistée par ordinateur, ainsi qu’aux divers outils d’aide à la traduction.
À la fin du cours, vous serez en mesure d’utiliser différents outils de traduction et de les évaluer en fonction de besoins précis. Vous pourrez, en outre, jauger les possibilités et les limites de l’informatique dans un environnement de traduction.
Objectifs spécifiques
À la fin du cours, vous devriez être en mesure de :
- comprendre le fonctionnement général des grands modèles de langue et ce qui en découle pour leur usage en traduction ;
- exploiter les GML de manière efficace et critique dans des tâches langagières concrètes, notamment par le requêtage et la comparaison de modèles ;
- concevoir et appliquer un protocole d’évaluation adapté à une tâche donnée ;
- choisir des mesures d’évaluation pertinentes, en interpréter les résultats et en reconnaître les limites ;
- situer les GML par rapport aux autres technologies langagières : TAO et mémoires de traduction, traduction automatique, travail sur corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. , technologies de la parole, formats et normes d’échange ;
- documenter une démarche technologique de façon à la rendre reproductible et critiquable ;
- développer une réflexion critique et argumentée sur la place de l’intelligence artificielle dans les professions langagières.
Structure générale
Le cours comprend trois volets :
- une introduction aux grands modèles de langue, en début de trimestre, combinant séances en classe et lectures individuelles ;
- trois projets successifs, réalisés en équipes, portant sur des tâches langagières distinctes ;
- un parcours d’apprentissage en ligne, individuel et asynchrone, consacré à d’autres technologies langagières.
Chaque projet combine des apports théoriques ciblés, du travail d’équipe en classe, du travail à la maison, une présentation orale et la remise de rapports. Dans la mesure du possible, chaque équipe travaille avec un agent conversationnel différent, ce qui permet de comparer les résultats obtenus d’une équipe à l’autre. La composition des équipes peut être revue entre les projets.
Références et ressources
Chaque projet et chaque parcours d’apprentissage comprend ses propres références, communiquées avec le matériel correspondant. La liste ci-dessous est non exhaustive.
- Baumgarten, S., & Tieber, M. (dir.). (2025). The Routledge Handbook of Translation Technology and Society. Routledge.
- Bowker, L. (2023). Translating for Canada, eh? (version 2). University of Ottawa. Également disponible en français.
- Drouin, P. (2003). Term Extraction Using Non-Technical Corpora as a Point of Leverage. Terminology, 9(1), 99–115.
- Gallegos, I. O., Rossi, R. A., Barrow, J., Tanjim, M. M., Kim, S., Dernoncourt, F., Yu, T., Zhang, R., & Ahmed, N. K. (2024). Bias and Fairness in Large Language Models: A Survey. Computational Linguistics, 50(3), 1097–1179.
- Jurafsky, D., & Martin, J. H. (2025). Speech and Language Processing (3e éd.). Manuscrit en ligne.
- Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: Ten years on. Lexicography, 1(1), 7–36.
- O’Hagan, M. (dir.). (2020). The Routledge Handbook of Translation and Technology. Routledge.
- Rigouts Terryn, A. (2026). Introduction to Large Language Models: Principles, Pitfalls, and Possibilities. Matériel de cours, Université de Montréal.
- Rivas Ginel, M. I., & Moorkens, J. (2025). Translators’ trust and distrust in the times of GenAI. Translation Studies, 18, 283–299.
- Rothwell, A., Moorkens, J., Fernández-Parra, M., Drugan, J., & Austermuehl, F. (2023). Translation Tools and Technologies. Routledge.
- Vanroy, B., Tezcan, A., & Macken, L. (2023). MATEO: MAchine Translation Evaluation Online. Proceedings of the 24th Annual Conference of the European Association for Machine Translation, 499–500.
- WMT. Proceedings of the Conference on Machine Translation. Association for Computational Linguistics. Édition la plus récente disponible au moment du cours.
Un schéma commun aux trois
Chacun des trois projets vous demande la même chose sur un sujet différent : réaliser une tâche langagière avec un outil spécialisé, la réaliser ensuite avec un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. , puis évaluer vous-mêmes ce que les deux ont produit.
Évaluer, trois fois
C’est l’évaluation qui change le plus d’un projet à l’autre, parce que mesurer la qualité ne veut pas dire la même chose selon la tâche.
- Parfois il faut d’abord construire la référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. à laquelle comparer, en faisant la tâche à la main, puis mesurer à quel point vos décisions concordent avec celles des autres.
- Parfois la référence n’est qu’une bonne réponse parmi d’autres, et le travail consiste à juger des productions à l’aide d’une grille d’erreurs, puis à confronter ce jugement à celui d’un agent conversationnel et à des mesures automatiques.
- Parfois enfin, rien n’est donné, et c’est à vous de décider quoi mesurer et comment.
L’autonomie augmente
Les trois projets se suivent en ordre croissant de difficulté et d’autonomie.
- Le Projet 1, sur l’extraction de termes, est encadré de près : tâche fixée, environnement de travail prêt, évaluation construite ensemble en classe. Il a aussi un volet industriel, puisqu’il alimente une étude menée avec une entreprise de traduction.
- Le Projet 2, sur la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , garde une tâche définie et des outils donnés, mais vous décidez de votre façon de traduire avec l’agent et vous jugez vous-mêmes les erreurs.
- Le Projet 3 est le vôtre : l’équipe choisit sa question, conçoit sa démarche et la défend.
Les équipes
Les équipes comptent trois personnes. Chaque équipe travaille avec un agent conversationnel différent, et l’attribution change d’un projet à l’autre : au fil du trimestre, le groupe aura vu plusieurs modèles à l’œuvre sur les mêmes tâches. La composition des équipes peut elle aussi être revue entre les projets.
Ce que vous remettez
Chaque projet se conclut par deux rapports, un individuel et un d’équipe, remis à la même date ; un gabarit vous est fourni pour chacun, avec le contenu attendu section par section.
À la dernière séance du projet, chaque équipe présente son travail. Rien de formel : le but est de montrer aux autres équipes ce que vous avez fait et de nourrir la discussion, pas de vous mettre en scène (see also the Evaluation page) (voir aussi la page Évaluation).
Les consignes de chaque projet
Tout ce qui est propre à un projet, le calendrier, la répartition des points, les règles de ressources et les gabarits des rapports, est sur la page du projet, publiée au début du projet (see also the TRA6008 · Project briefs chapter) (voir aussi le chapitre TRA6008 · Consignes des projets).
Quand a lieu le cours
Les séances ont lieu le jeudi, de 12 h 30 à 15 h 30. Onze séances de cours, plus la séance de présentations finales du 10 décembre 2026, dans la même case horaire.
Les séances
Le tableau donne tous les jeudis du trimestre, y compris ceux sans cours, pour que les interruptions soient visibles. Les séances teintées portent une évaluation.
| Séance | Date | Sujet |
|---|---|---|
| 1 | 3 septembre 2026 | Introduction, plan de cours, entrée en matière sur les GML ; annonce du Projet 1 |
| 2 | 10 septembre 2026 | GML : théorie |
| 17 septembre 2026 · Pas de cours (engagement IVADO). À faire cette semaine-là : le module sur la parole, et les lectures pour la séance 3 | ||
| 3 | 24 septembre 2026 | Se servir des GML ; leurs limites et leurs risques ; rappel de la question du consentement (Projet 1) |
| 4 | 1er octobre 2026 | Projet 1 : présentation du travail de projet, questionnaire de profil, début de l'annotation, formation des équipes |
| 5 | 8 octobre 2026 | Projet 1 : calcul de l'accord, précision, rappel et F1, retour sur la notion de terme et sur l'extraction automatique |
| 6 | 15 octobre 2026 | Présentations du Projet 1 |
| 22 octobre 2026 · Pas de cours (période d'activités libres) | ||
| 7 | 29 octobre 2026 | Projet 2 : vos questions sur les lectures, rédaction commune de la requête unique, traduction à la main, traduction avec l'agent |
| 8 | 5 novembre 2026 | Projet 2 : vos questions sur les lectures, annotation des erreurs, rédaction commune de la requête du juge, jugement par l'agent, chrF et COMET dans MATEO |
| 9 | 12 novembre 2026 | Présentations du Projet 2 ; lancement du Projet 3 |
| 19 novembre 2026 · Pas de cours (colloque à Ottawa). À faire cette semaine-là : choisir en équipe la question du Projet 3 et m'envoyer une proposition d'étude pour le dimanche 22 novembre 2026 | ||
| 10 | 26 novembre 2026 | Projet 3 : séance de travail (collecte) |
| 11 | 3 décembre 2026 | Projet 3 : séance de travail (analyse et préparation de l'oral) |
| 12 | 10 décembre 2026 | Présentations finales du Projet 3 |
Les trois jeudis sans cours
Il n’y a pas de séance le 17 septembre 2026, le 22 octobre 2026 ni le 19 novembre 2026.
Le 22 octobre 2026 tombe dans la période d’activités libres, où rien n’est prévu.
La semaine du 17 septembre 2026, en revanche, porte du travail. C’est là que se fait le module sur les technologies de la parole, dont l’échéance est le 25 septembre 2026, au lendemain de la séance 3, et que se préparent les lectures de cette séance.
Le 19 novembre 2026, je suis à Ottawa pour un colloque. Ce jeudi-là remplace la première séance de travail du Projet 3 : l’équipe se sert du créneau du cours, et peut se retrouver dans la salle habituelle, pour choisir sa question. Elle m’envoie ensuite une proposition d’étude au plus tard le dimanche 22 novembre 2026 à 23 h 59. Je lis ces propositions avant de rencontrer chaque équipe à mon bureau, le lundi 23 novembre 2026 ou le mardi 24 novembre 2026.
Les blocs du trimestre
1Séances 1 à 3
Introduction et grands modèles de langue
In classEn classeTrois séances : ce qu'est un grand modèle de langue et comment il est entraîné, puis comment s'en servir et ce qu'il fait mal. Le Projet 1 est annoncé à la séance 1 ; ses consignes détaillées arrivent au début de la séance 4.
Outside classHors classeTrois chapitres avant la séance 2. Avant la séance 3 : la fin de l'entraînement des GML (données, préentraînement, affinage) et l'essentiel de l'inférence et de l'apprentissage en contexte. La semaine du 17 septembre 2026, sans séance, sert aussi au module sur la parole.
2Séances 4 à 6
Projet 1 · Terminologie
In classEn classeLa présentation du travail de projet et le début de l'annotation à la séance 4, sans théorie avant. L'accord entre annotateurs, la précision, le rappel et le F1 à la séance 5, avec un retour sur la notion de terme. Présentations à la séance 6.
Outside classHors classeLa fin de l'annotation pour le 4 octobre 2026, puis le module d'extraction terminologique pour la séance 5, les listes et les scores des deux systèmes pour la séance 6, les deux rapports pour le 25 octobre 2026.
3Séances 7 à 9
Projet 2 · Traduction automatique
In classEn classeÀ la séance 7, vos questions sur les lectures, puis les traductions : la requête unique rédigée ensemble, la traduction à la main et la traduction avec l'agent. À la séance 8, vos questions, puis les évaluations : l'annotation des erreurs, la requête du juge rédigée ensemble, le jugement par l'agent, chrF et COMET. Présentations à la séance 9, qui lance le Projet 3.
Outside classHors classeLa théorie sur la traduction automatique pour la séance 7, celle sur son évaluation pour la séance 8. Ce qui n'est pas fini en classe se termine à la maison, et l'équipe compare ses annotations avant la séance 9. Les deux rapports pour le 20 novembre 2026.
4Séances 10 à 12, présentations le 10 décembre 2026
Projet 3 · À votre tour
In classEn classeLancement à la séance 9, puis deux séances de travail, l'une pour la collecte, l'autre pour l'analyse et la préparation de l'oral. Présentations finales le 10 décembre 2026.
Outside classHors classePas de séance le 19 novembre 2026 : l'équipe choisit sa question et m'envoie une proposition d'étude pour le 22 novembre 2026, puis en discute avec moi à mon bureau le 23 novembre 2026 ou le 24 novembre 2026. Les deux rapports pour le 17 décembre 2026.
5En autonomie
Parcours d'apprentissage en ligne
Outside classHors classeTrois modules individuels : la parole pour le 25 septembre 2026, les formats d'échange pour le 11 octobre 2026 et Sketch Engine pour le 1er novembre 2026. Ensemble, 10 % de la note.
Ce qui se passe entre les séances
Le tableau des séances ne montre pas tout le travail du trimestre.
Les projets se travaillent entre les séances autant que pendant. Chaque bloc de projet réserve du temps de classe au travail d’équipe, mais l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. , la collecte, l’analyse et la rédaction se font en dehors.
Le parcours en ligne se fait seul, sur les créneaux que vous choisissez, et ses trois modules ont chacun leur échéance, placée dans les semaines les plus calmes (see also the online path page) (voir aussi la page Le parcours en ligne).
Les lectures annoncées avant une séance ne sont pas facultatives : sans elles, la séance se suit mal, parce que le temps de classe sert au travail qui s’appuie dessus. Pendant les blocs de projet, c’est aussi une responsabilité envers votre équipe, puisque c’est ce qui vous permet d’y contribuer.
Insister sur le 17 septembre 2026 : pas de séance, mais du travail, et l’échéance du module sur la parole est huit jours plus tard. L’an dernier, la semaine d’autoformation improvisée a été l’élément le plus mal noté de l’évaluation du cours. Celle-ci a une remise datée ; le dire.
Les composantes et leur poids
| Composante | Pondération | Format |
|---|---|---|
| Parcours d’apprentissage en ligne | 10 % | Individuel, en ligne, trois échéances |
| Projet 1 · Terminologie | 20 % | Équipe et individuel, présentations le 15 octobre 2026, deux rapports le 25 octobre 2026 |
| Projet 2 · Traduction automatique | 30 % | Équipe et individuel, présentations le 12 novembre 2026, deux rapports le 20 novembre 2026 |
| Projet 3 · À votre tour | 40 % | Équipe et individuel, présentations le 10 décembre 2026, deux rapports le 17 décembre 2026 |
Pourquoi les projets ne pèsent pas le même poids
La progression 20 %, 30 %, 40 % ne suit pas le nombre d’heures, qui est comparable d’un projet à l’autre. Elle suit ce que le projet vous demande de décider.
Au Projet 1, vous appliquez une démarche que je vous donne. Au Projet 2, la tâche et les outils restent donnés, mais vous décidez de votre façon de traduire avec l’agent et vous jugez vous-mêmes les erreurs, sur une tâche où mesurer la qualité est nettement plus difficile. Au Projet 3, vous concevez tout : la question, le protocole, les mesures et l’interprétation. C’est là que se joue l’essentiel de ce que le cours cherche à vous apprendre, et c’est pour cela qu’il vaut le plus.
Comment un projet est noté
Sauf problème signalé en cours de projet, le rapport d’équipe et la présentation orale reçoivent chacun une note d’équipe, la même pour tous les membres ; le rapport individuel est noté individuellement.
La répartition des points à l’intérieur d’un projet est précisée dans ses consignes, avec ce que j’attends de la présentation orale, publiées en même temps que le reste du projet.
Les dates des évaluations
| Élément | Date |
|---|---|
| Parcours sur les technologies de la parole | vendredi 25 septembre 2026, 23 h 59, au lendemain de la séance 3 |
| Réponse à la question du consentement (AnnoTerm) | jeudi 1er octobre 2026, envoyée en classe le 3 septembre 2026 |
| Annotation du Projet 1 et questionnaire de fin de tâche | dimanche 4 octobre 2026, 23 h 59 |
| Module sur l'extraction terminologique | jeudi 8 octobre 2026, à lire avant la séance, une fois l'annotation remise |
| Parcours sur les formats d'échange | dimanche 11 octobre 2026, 23 h 59 |
| Présentations du Projet 1 | jeudi 15 octobre 2026, en classe |
| Listes de TermoStat et de l'agent, par équipe | jeudi 15 octobre 2026, par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a |
| Rapports du Projet 1 | dimanche 25 octobre 2026, 23 h 59, sur StudiUM |
| Module sur la traduction automatique | jeudi 29 octobre 2026, à lire avant la séance |
| Parcours sur Sketch Engine | dimanche 1er novembre 2026, 23 h 59 |
| Lectures sur l'évaluation de la traduction automatique | jeudi 5 novembre 2026, avant la séance |
| Projet 2 : référence de l'équipe | jeudi 5 novembre 2026, par courriel, au plus tard au début de la séance |
| Présentations du Projet 2 | jeudi 12 novembre 2026, en classe |
| Projet 2 : diapositives de l'équipe | jeudi 12 novembre 2026, par courriel, au plus tard à 23 h 59 ; partagées avec toute la classe sur StudiUM |
| Rapports du Projet 2 | vendredi 20 novembre 2026, 23 h 59 |
| Proposition d'étude du Projet 3 | dimanche 22 novembre 2026, 23 h 59 |
| Rencontres d'encadrement du Projet 3 | lundi 23 novembre 2026, à mon bureau, une rencontre par équipe sur les deux jours |
| Rencontres d'encadrement du Projet 3 | mardi 24 novembre 2026, à mon bureau, une rencontre par équipe sur les deux jours |
| Présentations finales du Projet 3 | jeudi 10 décembre 2026, en classe |
| Rapports du Projet 3 | jeudi 17 décembre 2026, 23 h 59 |
Correction et retards
Les retards sont pénalisés à hauteur de 20 % par jour de retard, sauf en cas de circonstances exceptionnelles justifiées. Les délais sont communiqués dès le début du trimestre, et il est attendu que les travaux soient remis à temps.
Ce à quoi je m’engage
Vous recevez une rétroaction détaillée sur chaque projet, et non une note seule : ce qui a fonctionné, ce qui n’a pas fonctionné, et ce qu’il faut changer pour le projet suivant. Comme les trois projets reprennent la même démarche sur des tâches différentes, cette rétroaction est faite pour être utilisée : je vise à vous la remettre avant les présentations du projet suivant, et pour le Projet 3, avant la remise des notes finales.
Les ressources autorisées
Les ressources permises ne sont pas les mêmes d’un projet à l’autre, et elles sont précisées par écrit avec les consignes, avant chaque évaluation.
Trois dates à nommer explicitement, parce que ce sont celles qui surprennent :
le 25 septembre 2026, un VENDREDI, pour le module sur la parole : au lendemain de la séance 3, pour que les dernières questions se posent en classe ;
les dimanches 11 octobre 2026 (formats d’échange) et 1er novembre 2026 (Sketch Engine), placés dans les creux, tout remis avant le Projet 3 ;
le 17 décembre 2026 pour le rapport du Projet 3, une semaine après les présentations.
Ce que vaut le parcours
Le parcours d’apprentissage en ligne vaut 10 % de la note et se compose de trois modules distincts, individuels et asynchrones. Ils portent sur des technologies langagières que les projets ne touchent pas : la parole, les formats d’échange et le travail sur corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. .
Les trois modules
| Module | Pondération | Échéance | Comment il est évalué |
|---|---|---|---|
| Technologies de la parole | 6 % | vendredi 25 septembre 2026, 23 h 59 | Remise sur StudiUM |
| Formats d’échange en traduction | 2 % | dimanche 11 octobre 2026, 23 h 59 | Questionnaire en ligne |
| Sketch Engine et le travail sur corpus | 2 % | dimanche 1er novembre 2026, 23 h 59 | Questionnaire en ligne |
Les trois sont notés sur ce que vous produisez, et non sur le simple fait de les avoir parcourus. Ils ne pèsent pas le même poids parce qu’ils ne demandent pas le même travail. Le module sur la parole vous fait manipuler trois outils et produire des fichiers, ce qui prend plusieurs heures. Les deux autres sont plus courts : celui sur les formats d’échange se lit, et celui sur Sketch Engine reprend un outil que vous connaissez déjà en partie.
Ce que contient chacun
Les technologies de la parole : la reconnaissance et la synthèse de la parole speech synthesis (TTS)synthèse de la parole speechparole The generation of artificial speech from written text (text-to-speech), combining linguistic processing to derive a pronounceable phonetic form with signal processing to render it as audio; the inverse of automatic speech recognition.Production de parole artificielle à partir de n'importe quel texte (angl. text-to-speech, TTS), combinant un traitement linguistique, qui transforme le texte en une forme phonétique prononçable, et un traitement du signal, qui transforme cette forme en son ; l'inverse de la reconnaissance automatique de la parole. , comment on en mesure la qualité, la traduction de la parole, et ce que tout cela change au métier. Il se termine par trois démonstrations que vous faites vous-même, avec un fichier à remettre.
Les formats d’échange en traduction : pourquoi les outils de traduction ont besoin de formats communs, comment lire du XML, et ce que font concrètement TMX, TBX et XLIFF. C’est le module le plus proche du travail quotidien avec un outil de TAO.
Sketch Engine et le travail sur corpus : ce qu’est un corpus, à quoi il sert en traduction, et comment interroger Sketch Engine, entre listes de fréquences, concordances concordanceconcordance corporacorpus A display of all occurrences of a word or expression in a corpus, each shown with its surrounding context, typically one occurrence per line with the search word aligned in the middle (the key word in context, or KWIC, format).Affichage de toutes les occurrences d'un mot ou d'une expression dans un corpus, chacune accompagnée de son contexte immédiat, généralement une occurrence par ligne avec le mot cherché aligné au centre (format KWIC, mot-clé en contexte). , comparaison de corpus et Word Sketch. L’accès passe par l’Institutional Login de l’Université de Montréal.
Quand les faire
Les trois sont en ligne et vous les faites sur les créneaux que vous choisissez.
Les échéances, elles, sont placées dans les creux du trimestre.
- Celle de la parole tombe au lendemain de la séance 3, pour que les dernières questions puissent se poser en classe la veille ; la semaine sans séance du 17 septembre 2026 lui est réservée, car c’est le plus exigeant des trois.
- Celle de Sketch Engine suit la semaine d’activités libres.
- Tout est remis avant le lancement du Projet 3, le 12 novembre 2026, pour que les dernières semaines du trimestre appartiennent à votre propre étude.
Vos marques de progression ne sont enregistrées nulle part
Le site n’a pas de comptes et ne conserve rien sur un serveur. Quand vous terminez un exercice, la marque est écrite dans la mémoire de votre navigateur, sur cet ordinateur-là. Vous la perdez si vous effacez vos données de navigation, si vous passez à un autre appareil, ou si vous travaillez en navigation privée.
Je ne vois donc rien de votre progression sur le site. Ce qui compte est ce que vous remettez : le fichier sur StudiUM pour la parole, et les deux questionnaires en ligne pour les formats d’échange et pour Sketch Engine.
Dire que le module sur la parole est le seul des trois qui soit figé : il ouvre aujourd’hui et ne bouge plus, parce que l’échéance est trop proche. Signaler les problèmes d’outil tout de suite plutôt qu’à la remise.
Deux minutes, pas plus : le briefing détaillé a lieu à la séance 3 et a son propre deck. Dire seulement ce qu’il faut pour que la lecture d’ici là ait un sens : vous déciderez vous-mêmes, texte en main, ce qui est un terme, vous comparerez vos décisions à celles des autres, et un outil et un agent conversationnel travailleront sur les mêmes textes.
Les équipes et l’agent attribué à chacune ne s’annoncent pas aujourd’hui : les inscriptions ferment le 16 septembre 2026.
Dire aussi que la question du consentement à l’étude AnnoTerm part aujourd’hui, par courriel de Noah dans LimeSurvey, avec réponse pour le 1er octobre 2026 : tout le monde fait le projet en entier de toute façon, le consentement ne porte que sur l’usage des données dans l’étude publiée, et je n’ai pas accès aux réponses. Le questionnaire de profil se remplira en classe le 1er octobre 2026, en dix minutes, et c’est lui qui ouvrira l’accès à INCEpTION.
D’abord, devant le groupe, enregistrer la page du glossaire depuis le navigateur (https://aylart.github.io/learn/glossary/, Ctrl+S, HTML) : le geste montre aux étudiants comment récupérer une page. Puis taper (ou dicter) la requête en direct, le fichier HTML en pièce jointe, dans DEUX outils, Claude et ChatGPT, deux onglets côte à côte : première comparaison de modèles du trimestre. L’essai par l’adresse seule s’est enlisé dans la récupération, le fichier joint va beaucoup plus vite.
La requête, telle quelle, l’adresse cédant la place au fichier joint :
I would like to have an interactive flashcard app to help me study all of the terms and translations on this page https://aylart.github.io/learn/glossary/. I want you to show me the app in this window. I want to be able to interrogate myself with either the FR or EN term, and have to write the equivalent in the other language. The app should remember (in session) which ones I’ve gotten right or wrong, so that on second tries, I would be able to practice only the ones I’ve gotten wrong, or haven’t practised yet. If you can think of other nice-to-have features, you can integrate those as well. Doesn’t need to be anything fancy, just a nice study aid
Peu importe la forme que chacun rend (application affichée dans la fenêtre, ou fichier HTML à télécharger) : un fichier téléchargé se montre en l’ouvrant en local, et c’est un argument, pas un raté : une application à soi, hors de l’outil, sans compte. Requête vérifiée le 31 août 2026 (Claude ; les deux formes de sortie observées).
La génération prend du temps, d’où le lancement avant les deux autres démonstrations : la vidéo et la visite du site l’occupent, et la pause qui suit lui laisse de la marge si elle en a besoin. Laisser les onglets ouverts, et garder une conversation de secours dans un autre onglet.
La vidéo se joue depuis le fichier local, pas depuis le site : elle n’y est pas publiée. C’est le rendu de l’an dernier, de l’anglais vers le français, avec la voix clonée et les lèvres resynchronisées.
Trois choses à faire remarquer pendant la lecture : c’est ma voix, ce sont mes lèvres, et rien de tout cela n’a été enregistré en français. Ne pas expliquer la cascade tout de suite : elle est reprise dans le module sur les technologies de la parole, où cette vidéo revient.
Le parcours à l’écran : la page de classe, le calendrier, un bloc, une étape, puis un chapitre public et une page. Montrer le bouton de langue, la recherche, le glossaire, et le bouton de signalement d’erreur au bas d’une page.
Dire que le site ne garde rien et ne note rien : il n’y a pas de compte, donc rien à suivre.
Le site compte lui aussi comme une démonstration : je ne sais pas construire un site comme celui-ci, et la mise en oeuvre technique est de Claude Code, comme une bonne part des traductions. Le contenu, lui, est le mien. Dire où la déclaration complète se lit, usage par usage, plutôt que la lire : le lien « L’usage de l’IA » au bas de chaque page.
Après la pause, revenir aux deux onglets lancés avant la vidéo. Montrer ce que chacun a produit, et ouvrir le fichier en local si c’est un fichier qui est sorti : une application à soi, hors de l’outil, sans compte.
Si la génération a échoué ou traîne, la conversation de secours dans l’autre onglet.