Benchmarks in French and other languagesLes tests en français et dans d'autres langues
Most benchmarks are in English
Most benchmarks are written in English, so a model’s score on them says nothing direct about how it handles French or any other language. There are two ways round that: translate the test, or build one per language.
Translating the test
OpenAI had MMLU’s test set test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. translated into fourteen languages, French among them, by professional translators, so that the same questions could be asked in each.OpenAI, MMMLU dataset card, read 15 September 2026: “We translated the MMLU’s test set into 14 languages using professional human translators.” That is worth more than no test at all: it shows whether a model does in French what it does in English.
What translation does not fix
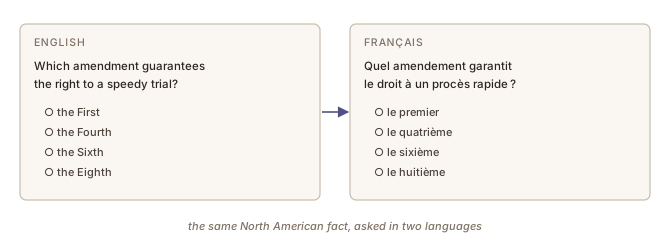
Nevertheless, a translated question is still the same question. Singh et al. (2025a) found that 28% of the MMLU questions they annotated need knowledge specific to a culture or a region, most often North American or European. A question about an amendment to the American constitution, asked in French, still tests knowledge of American civics (Figure 5figure 5). Their Global MMLU marks those questions, and the ranking of models changes depending on whether they are scored on the whole set or on that subset alone.
Tests built language by language
EuroEval keeps one leaderboard per European language, French included, on tasks such as reading comprehension, summarization and linguistic acceptability (Nielsen, 2023). Its French tests mix material written in French, such as news summaries and questions about French Wikipedia articles, with tests translated from English, and its documentation says which is which. The AI Language Proficiency Monitor follows up to two hundred languages, mostly with translated datasets (Pomerenke et al., 2025).EuroEval, formerly ScandEval, with its French datasets, and the AI Language Proficiency Monitor, read 15 September 2026 and 17 September 2026.
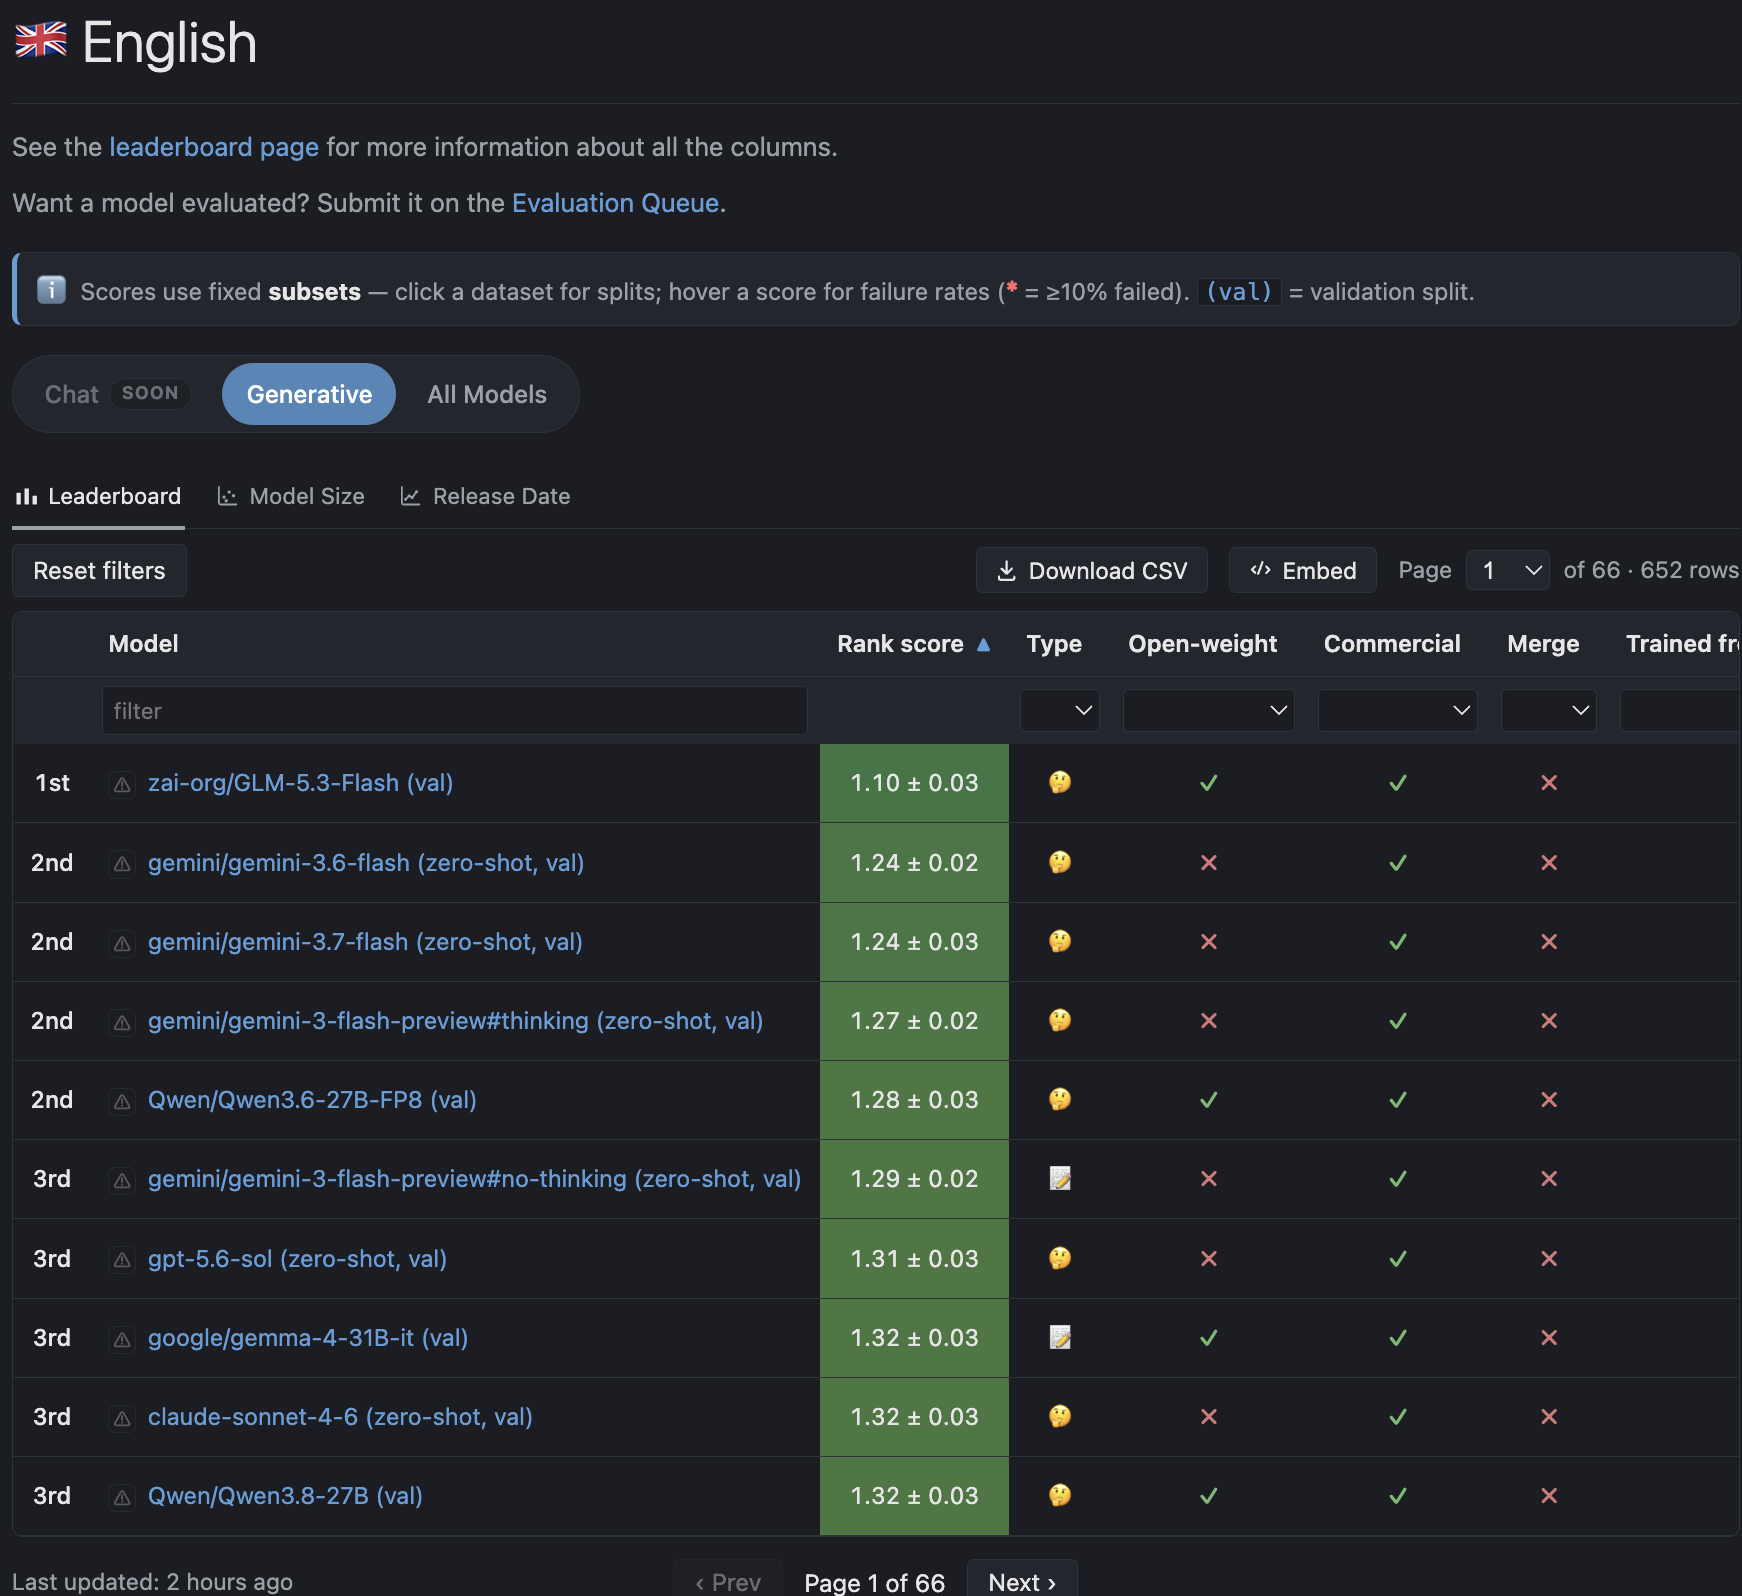
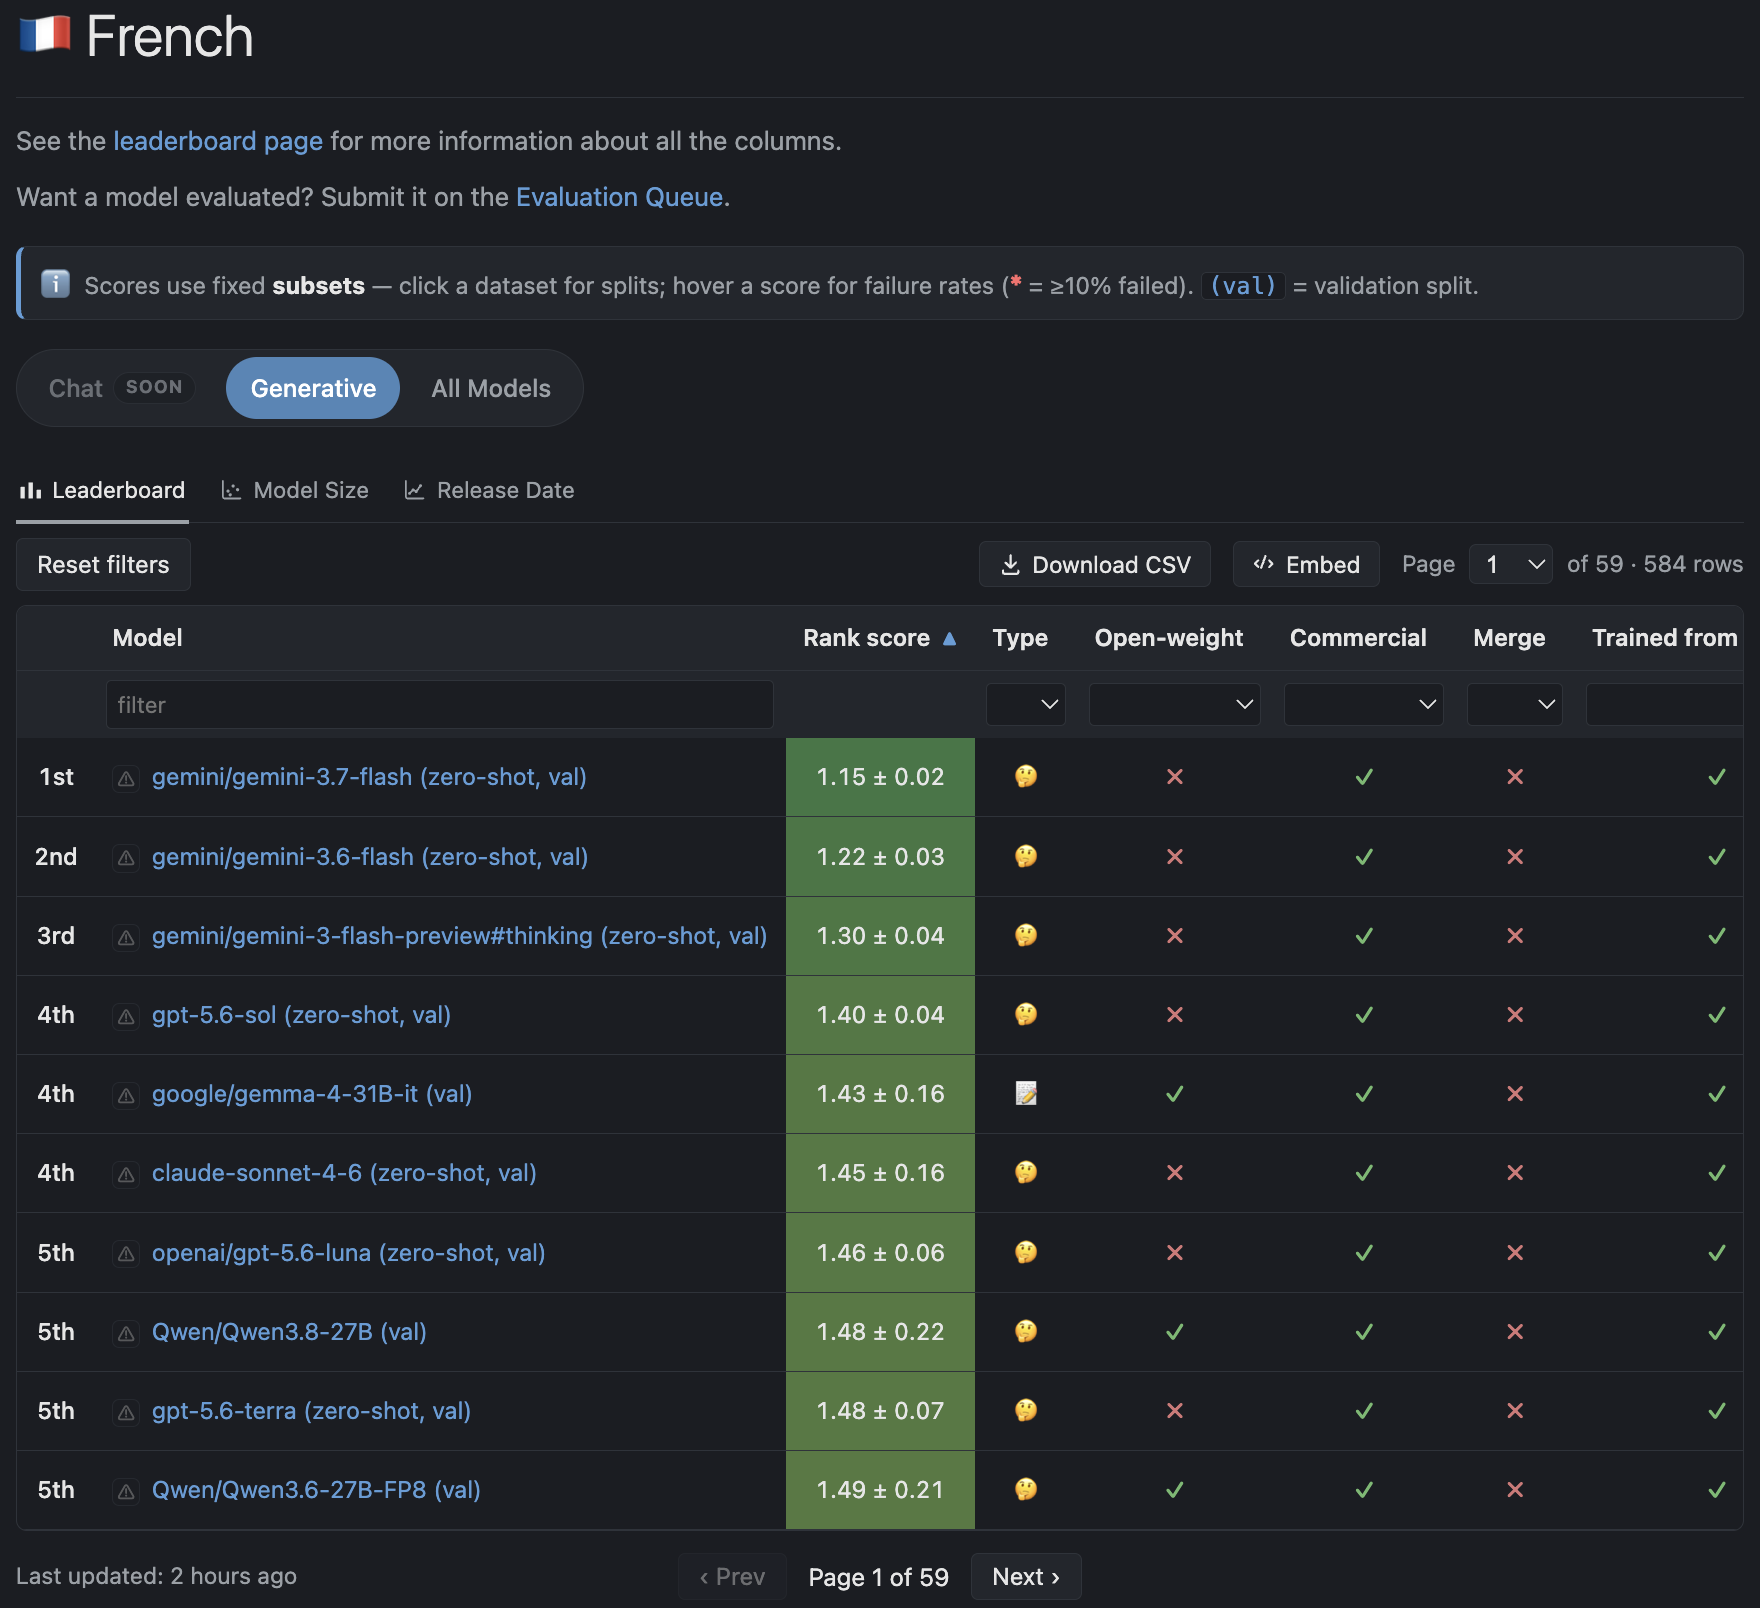
Such rankings differ from one language to the next. On 17 September 2026, the model ranked first on EuroEval’s English leaderboard was not among the first ten in French (Figure 6figure 6 and Figure 7figure 7).
La plupart des tests sont en anglais
La plupart des tests sont rédigés en anglais : le score d’un modèle à ces tests ne dit donc rien de direct sur ce qu’il fait en français ou dans une autre langue. Il y a deux façons de contourner le problème : traduire le test, ou en concevoir un par langue.
Traduire le test
OpenAI a fait traduire le jeu de données de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. de MMLU dans quatorze langues, dont le français, par des traductrices et traducteurs professionnels, afin de pouvoir poser les mêmes questions dans chacune.OpenAI, fiche du jeu de données MMMLU, consultée le 15 septembre 2026 : « We translated the MMLU’s test set into 14 languages using professional human translators. » C’est mieux que pas de test du tout : cela montre si un modèle fait en français ce qu’il fait en anglais.
Ce que la traduction ne règle pas
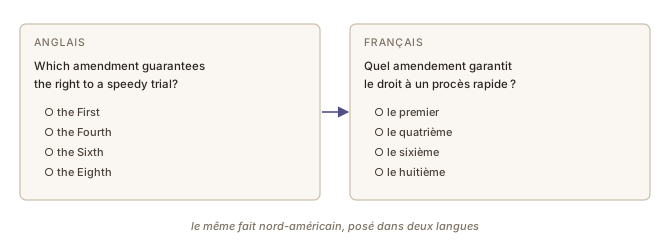
Une question traduite reste néanmoins la même question. Singh et al. (2025a) ont constaté que 28 % des questions de MMLU qu’ils ont annotées demandent des connaissances propres à une culture ou à une région, le plus souvent nord-américaine ou européenne. Une question sur un amendement de la Constitution américaine, posée en français, évalue toujours des connaissances en instruction civique américaine (Figure 5figure 5). Leur Global MMLU signale ces questions, et le classement des modèles change selon qu’ils sont notés sur l’ensemble des questions ou sur ce sous-ensemble seulement.
Des tests conçus langue par langue
EuroEval tient un classement par langue européenne, dont le français, sur des tâches comme la compréhension de lecture, le résumé et l’acceptabilité linguistique (Nielsen, 2023). Ses tests français mêlent des textes rédigés en français, comme des résumés d’articles de presse et des questions sur des articles de Wikipédia en français, et des tests traduits de l’anglais, et sa documentation précise lesquels sont lesquels. L’AI Language Proficiency Monitor suit jusqu’à deux cents langues, surtout avec des jeux de données traduits (Pomerenke et al., 2025).EuroEval, anciennement ScandEval, avec ses jeux de données français, et l’AI Language Proficiency Monitor, consultés le 15 septembre 2026 et le 17 septembre 2026.
Ces classements diffèrent d’une langue à l’autre. Le 17 septembre 2026, le modèle en tête du classement anglais d’EuroEval ne figurait pas parmi les dix premiers en français (Figure 6figure 6 et Figure 7figure 7).
Sources
- Nielsen, D. S. (2023). ScandEval: A Benchmark for Scandinavian Natural Language Processing. Proceedings of the 24th Nordic Conference on Computational Linguistics (NoDaLiDa 2023), 185–201. https://aclanthology.org/2023.nodalida-1.20/
- Pomerenke, D., Nothnagel, J., & Ostermann, S. (2025). The AI Language Proficiency Monitor: Tracking the Progress of LLMs on Multilingual Benchmarks. Preprint, arXiv:2507.08538. https://arxiv.org/abs/2507.08538
- Singh, S., Romanou, A., Fourrier, C., Adelani, D. I., Ngui, J. G., Vila-Suero, D., et al. (2025a). Global MMLU: Understanding and Addressing Cultural and Linguistic Biases in Multilingual Evaluation. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 18761–18799. https://doi.org/10.18653/v1/2025.acl-long.919