Before neural networks: rules and statisticsAvant les réseaux de neurones : règles et statistiques
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Rule-based translationLa traduction à base de règles
Dictionaries and rules
The first generation of systems translated the way a beginner with a
dictionary and a grammar might. For the green witch arrived, an
English-to-French system of this kind works through a list:
look each word up in its bilingual dictionary: the → la, green →
vert, witch → sorcière, arrived → est arrivée;
apply the rule that a French adjective follows its noun: sorcière vert;
apply the rule that it agrees in gender and number: sorcière verte;
assemble the sentence: la sorcière verte est arrivée.
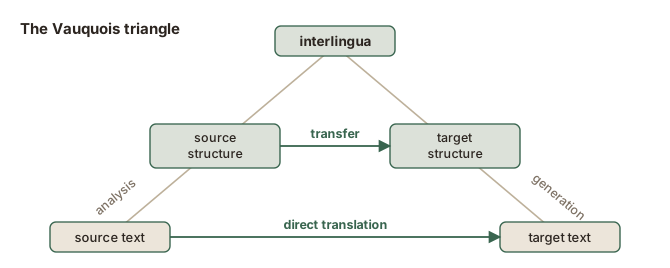
Jurafsky and Martin (2026) describe three designs, which differ in how much
of the source sentence is analyzed before anything is produced (Figure 1figure 1).
Figure 1. The Vauquois triangle, as given by Jurafsky and Martin (2026), who attribute it to Vauquois.
Design
Analysis before anything is written
Written for each language pair
Direct
nothing: the sentence is worked through word by word
a large bilingual dictionary whose every entry is a small program, translating one word and handling its reordering
Transfer
the grammatical structure of the source sentence
rules that turn a source structure into a target structure, then a generator, the part that writes the target sentence from that structure
Interlingua
the meaning, into a representation independent of both languages
in principle nothing specific to the pair: one analyzer per source language, one generator per target language
The three designs of rule-based translation.
Going up the triangle means more analysis on both sides and less knowledge
specific to the pair in the middle.
Strengths and limits
Strengths
Limits
Control. A wrong translation is traced to a rule or a dictionary entry, and corrected there.
Transparency. The path from the source to the output can be read, rule by rule.
Slow and expensive to build. In a direct or transfer system, each language pair and each direction needs its own dictionary and rules, written by linguists.
Hard to maintain. Rules interact, and a rule added for one case can break another.
The approach lost ground once enough translated text existed to learn from,
and it survives mainly for language pairs where that text does not exist.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Des dictionnaires et des règles
La première génération de systèmes traduisait comme le ferait un débutant
muni d’un dictionnaire et d’une grammaire. Pour the green witch arrived, un
système de ce type qui traduit de l’anglais vers le français suit une liste
d’étapes :
chercher chaque mot dans son dictionnaire bilingue : the → la,
green → vert, witch → sorcière, arrived → est arrivée ;
appliquer la règle selon laquelle l’adjectif français suit le nom :
sorcière vert ;
appliquer la règle d’accord en genre et en nombre : sorcière verte ;
assembler la phrase : la sorcière verte est arrivée.
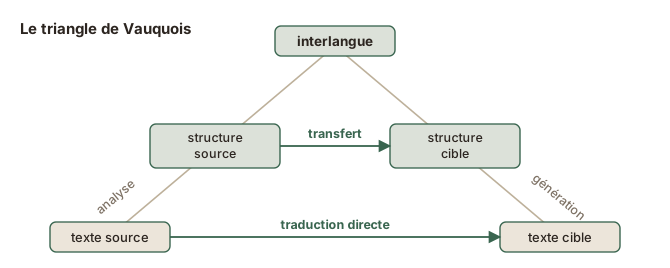
Jurafsky et Martin (2026) décrivent trois architectures, qui diffèrent par la
part de la phrase source analysée avant que quoi que ce soit soit produit
(Figure 1figure 1).
Figure 1. Le triangle de Vauquois, tel que le présentent Jurafsky et Martin (2026), qui l'attribuent à Vauquois.
Architecture
Analyse avant toute écriture
Ce qu’il faut écrire pour chaque paire de langues
Directe
aucune : la phrase est traitée mot par mot
un grand dictionnaire bilingue dont chaque entrée est un petit programme, qui traduit un mot et gère son déplacement dans la phrase
Transfert
la structure grammaticale de la phrase source
des règles qui transforment une structure source en structure cible, puis un générateur, la partie qui écrit la phrase cible à partir de cette structure
Interlangue
le sens, dans une représentation indépendante des deux langues
en principe rien de propre à la paire : un analyseur par langue source, un générateur par langue cible
Les trois architectures de la traduction à base de règles.
Plus on monte dans le triangle, plus l’analyse est poussée des deux côtés, et
moins il faut de connaissances propres à la paire de langues au milieu.
Forces et limites
Forces
Limites
Contrôle. Une traduction erronée se ramène à une règle ou à une entrée du dictionnaire, et se corrige à cet endroit.
Transparence. Le chemin de la phrase source au résultat se lit règle par règle.
Long et coûteux à construire. Dans un système direct ou à transfert, chaque paire de langues et chaque direction exigent leurs propres dictionnaire et règles, écrits par des linguistes.
Difficile à maintenir. Les règles interagissent, et une règle ajoutée pour un cas peut en défaire un autre.
Forces et limites de la traduction à base de règles.
L’approche a perdu du terrain dès que les textes traduits ont été assez
nombreux pour qu’on puisse en apprendre, et elle survit surtout pour les
paires de langues où ces textes n’existent pas.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
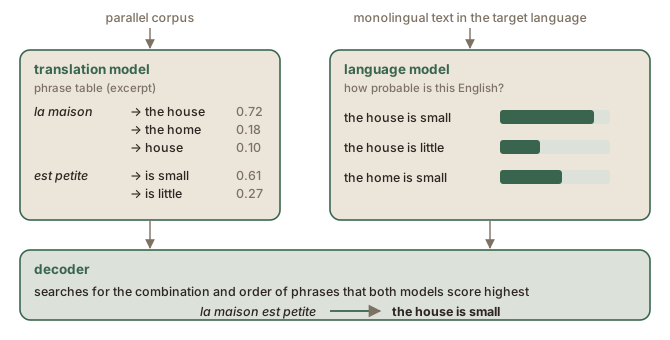
The parts of a statistical system are shown in Figure 2figure 2 (Jurafsky & Martin, 2026).
Figure 2. The three components of a statistical translation system. The phrase table and its probabilities are illustrative.
The translation model contains the bilingual knowledge: for each source
word or phrase, the target words or phrases paired with it in the corpus,
each with a probability. In the phrase-based systems that became
standard in the 2000s, this is a table of phrase pairs, the phrase table.
The decoder combines the two: it takes every phrase pair that matches
the source sentence and searches for the combination and order whose
probability is highest under both models together.
The reference textbook of this generation is Koehn (2010).
You can try the reasoning yourself on a menu in a language you do not read,
for example the four dishes in the table below. If you read Chinese, the
steps work the same way for a menu in any language you do not know.
On the menu
In English
虾仁炒饭
Shrimp fried rice
牛肉炒饭
Beef fried rice
牛肉面
Beef noodles
炒面
Fried noodles
Four dishes from a Chinese menu, with their English translations.
Two dishes are fried rice, and the only signs they have in common are
炒饭, so 炒饭 probably means fried rice.
Two dishes contain beef, and they have 牛肉 in common, so 牛肉 means
beef: two signs for one English word.
In 牛肉面, once 牛肉 is beef, the one sign left, 面, must be noodles.
In 炒面, once 面 is noodles, 炒 must be fried, which leaves 饭 in
炒饭 for rice.
In the first dish, 虾仁 is then the only candidate left for shrimp.
You have matched every sign to an English word without reading the menu,
only by comparing which signs and which English words occur together. Real
translations are less tidy: the same menu could translate 炒面 as chow
mein, and that dish would then tell you nothing about fried or noodles.
What the system does
A statistical system applies the same idea to millions of sentence pairs,
with counts in place of reasoning.
At the start, the system has no information about either language. Every word
of a source sentence is equally likely to translate every word of its
target sentence (Brown et al., 1993).
The system counts and recalculates, many times over. Words that keep
occurring in the same sentence pairs gain probability; once a word’s
translation is clear, the other words of the pair are left to share the
rest. The effect is close to the elimination you did on the menu. The
result is a word alignment: in each sentence pair, each word is paired
with its probable translation (Brown et al., 1993).
The system then collects phrase pairs, sequences of words that are
aligned only with each other, such as 炒面 and fried noodles (Koehn et
al., 2003).
The probability in the phrase table is a share. Of all the times a
source phrase was paired with something, it is the share of times it was
paired with this translation (Koehn et al., 2003). If 炒面 occurred
1 000 times, 700 times with fried noodles, 250 times with chow mein and
50 times with noodles, the three probabilities would be 0.70, 0.25 and
0.05 (illustrative numbers).
Whether the model produces text. In a statistical system the language
model does not produce any text of its own: the phrase table proposes the
candidates and the language model only scores them. An LLM produces the
text itself, one token at a time, by choosing among the tokens it gives a high
probability (see also the LLMs as next-word predictors chapter, in the LLM lifecycle module) (voir aussi le chapitre Les GML, prédicteurs du mot suivant, dans le module Cycle de vie des GML).
Dependence on the training data
The quality of a statistical system depends mainly on its training data:
the more translated words a system was trained on, the more reliable its
counts;
the closer the training data is to the text to translate, in domain and in
style, the better the output: a system trained on parliamentary proceedings
translates proceedings well and a product manual less well;
languages and domains with little parallel text are served badly, a problem
the neural generation inherited (see also the Remaining failures page) (voir aussi la page Les échecs qui subsistent).
Sources
Brown, P. F., Della Pietra, S. A., Della Pietra, V. J., & Mercer, R. L. (1993). The Mathematics of Statistical Machine Translation: Parameter Estimation. Computational Linguistics, 19(2), 263–311. https://aclanthology.org/J93-2003/
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Koehn, P., Och, F. J., & Marcu, D. (2003). Statistical Phrase-Based Translation. Proceedings of the 2003 Human Language Technology Conference of the North American Chapter of the Association for Computational Linguistics, 127–133. https://aclanthology.org/N03-1017/
Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/
Modèle de traduction, modèle de langue et décodeur
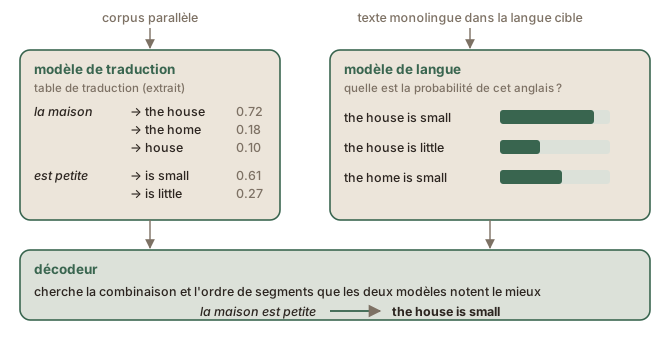
La Figure 2figure 2 présente les composantes d’un système statistique (Jurafsky & Martin, 2026).
Figure 2. Les trois composantes d'un système de traduction statistique. La table de traduction et ses probabilités sont fictives.
Le modèle de traduction contient les connaissances bilingues : pour
chaque mot ou segment source, les mots ou segments cibles qui lui sont
appariés dans le corpus, chacun avec une probabilité. Dans les systèmes
fondés sur les segments, devenus la norme dans les années 2000, il s’agit
d’une table de paires de segments, la table de traduction (angl. phrase
table).
Le décodeur combine les deux : il prend toutes les paires de segments qui
correspondent à la phrase source et cherche la combinaison et l’ordre dont la
probabilité est la plus élevée selon les deux modèles réunis.
L’ouvrage de référence de cette génération est celui de Koehn (2010).
Vous pouvez essayer ce raisonnement vous-même sur un menu dans une langue que
vous ne lisez pas, par exemple les quatre plats du tableau ci-dessous. Si vous
lisez le chinois, les étapes fonctionnent de la même façon avec un menu dans
n’importe quelle langue que vous ne connaissez pas.
Sur le menu
En français
虾仁炒饭
Riz sauté aux crevettes
牛肉炒饭
Riz sauté au bœuf
牛肉面
Nouilles au bœuf
炒面
Nouilles sautées
Quatre plats d'un menu chinois, avec leur traduction française.
Deux plats sont du riz sauté, et les seuls signes qu’ils ont en commun
sont 炒饭 : 炒饭 veut donc probablement dire riz sauté.
Deux plats contiennent du bœuf, et ils ont 牛肉 en commun : 牛肉 veut donc
dire bœuf, deux signes pour un seul mot français.
Dans 牛肉面, une fois 牛肉 identifié comme bœuf, le seul signe qui reste,
面, doit vouloir dire nouilles.
Dans 炒面, une fois 面 identifié comme nouilles, 炒 doit vouloir dire
sautées, ce qui laisse 饭, dans 炒饭, pour riz.
Dans le premier plat, 虾仁 est alors le seul candidat qui reste pour
crevettes.
Vous avez associé chaque signe à un mot français sans lire le menu,
uniquement en comparant quels signes et quels mots français apparaissent
ensemble. Les traductions réelles sont moins nettes : le même menu pourrait
traduire 炒面 par chow mein, et ce plat ne vous apprendrait alors rien sur
sautées ni sur nouilles.
Ce que fait le système
Un système statistique applique la même idée à des millions de paires de
phrases, avec des comptages à la place du raisonnement.
Au départ, le système ne dispose d’aucune information sur l’une ou l’autre langue. Chaque mot d’une
phrase source a autant de chances de traduire n’importe quel mot de sa
phrase cible (Brown et al., 1993).
Le système compte et recalcule, un grand nombre de fois. Les mots qui
reviennent sans cesse dans les mêmes paires de phrases gagnent en
probabilité ; une fois la traduction d’un mot établie, les autres mots de la
paire se partagent le reste. L’effet est proche de l’élimination que vous
avez faite sur le menu. Le résultat est un alignement des mots : dans
chaque paire de phrases, chaque mot est apparié à sa traduction probable
(Brown et al., 1993).
Le système recueille ensuite des paires de segments, des suites de mots
qui ne sont alignées qu’entre elles, comme 炒面 et nouilles sautées (Koehn
et al., 2003).
La probabilité dans la table de traduction est une proportion. Sur
toutes les fois où un segment source a été apparié à quelque chose, c’est la
proportion des fois où il a été apparié à cette traduction (Koehn et al.,
2003). Si 炒面 apparaissait 1 000 fois, dont 700 fois avec nouilles
sautées, 250 fois avec chow mein et 50 fois avec nouilles, les trois
probabilités seraient 0,70, 0,25 et 0,05 (chiffres fictifs).
Le modèle de langue et les grands modèles de langue
Si le modèle produit du texte. Dans un système statistique, le modèle de
langue ne produit aucun texte de lui-même : la table de traduction propose
les candidats, et le modèle de langue se contente de les noter. Un GML
produit lui-même le texte, un jeton à la fois, en choisissant parmi les
jetons auxquels il attribue une forte probabilité (see also the LLMs as next-word predictors chapter, in the LLM lifecycle module) (voir aussi le chapitre Les GML, prédicteurs du mot suivant, dans le module Cycle de vie des GML).
La dépendance aux données d’entraînement
La qualité d’un système statistique dépend surtout de ses données
d’entraînement :
plus le système a été entraîné sur un grand nombre de mots traduits, plus
ses comptages sont fiables ;
plus les données d’entraînement sont proches du texte à traduire, par le
domaine et par le style, meilleur est le résultat : un système entraîné sur
des débats parlementaires traduit bien des débats et moins bien un manuel de
produit ;
les langues et les domaines qui disposent de peu de textes parallèles sont
mal servis, un problème dont la génération neuronale a hérité (see also the Remaining failures page) (voir aussi la page Les échecs qui subsistent).
Sources
Brown, P. F., Della Pietra, S. A., Della Pietra, V. J., & Mercer, R. L. (1993). The Mathematics of Statistical Machine Translation: Parameter Estimation. Computational Linguistics, 19(2), 263–311. https://aclanthology.org/J93-2003/
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Koehn, P., Och, F. J., & Marcu, D. (2003). Statistical Phrase-Based Translation. Proceedings of the 2003 Human Language Technology Conference of the North American Chapter of the Association for Computational Linguistics, 127–133. https://aclanthology.org/N03-1017/
Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/