This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
LLM lifecycleCycle de vie des GML
Training dataLes données d'entraînement
LLM lifecycleCycle de vie des GML
Training dataLes données d'entraînement
How much text a model readsQuelle quantité de texte lit un modèle
Where the text comes fromD'où vient le texte
What gets filtered outCe qui est filtré
Which languages, and how unevenlyQuelles langues, et dans quelles proportions
Model collapseEffondrement du modèle
How much text goes into one model
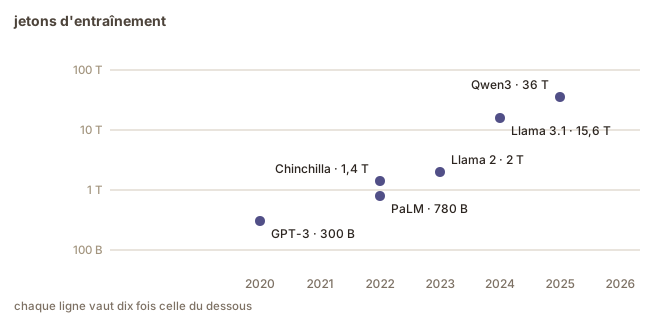
The dataset assembled to train GPT-3 came to 499 billion tokens, of which the
model saw 300 billion during training (Brown et al., 2020). A few years later,
Chinchilla was trained on 1.4 trillion (Hoffmann et al., 2022). The published
figures have gone on climbing since: 15.6 trillion tokens for Llama 3.1 in 2024
(Grattafiori et al., 2024), 36 trillion for Qwen3 in 2025 (Yang et al.,
2025b).These are the figures that were
published. OpenAI’s report on GPT-4 says it gives “no further details about the
architecture (including model size), hardware, training compute, dataset
construction, training method, or similar” (OpenAI, 2023), and the other large
providers say no more, so the size of the models most people use today is a
matter of estimate rather than record.
Those figures mean very little on their own, so here is a comparison to try to
get a better grasp:
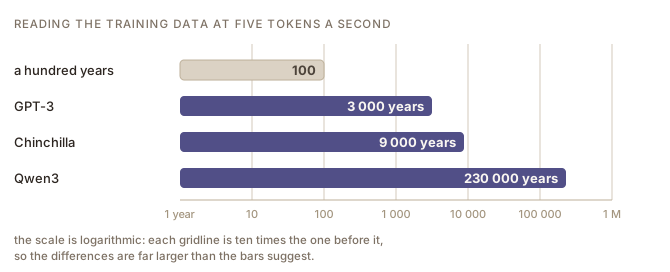
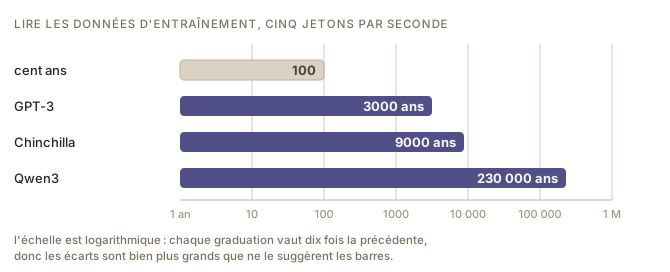
Reading at roughly five tokens a second, without stopping to eat or sleep, 1.4
trillion tokens would take somewhere near nine thousand years. Qwen3’s 36
trillion would take about two hundred and thirty thousand.
Figure 1. The same quantities as time spent reading, which is the only scale most of us have for them. Token counts from Brown et al. (2020), Hoffmann et al. (2022) and Yang et al. (2025b).
How the amounts have grown
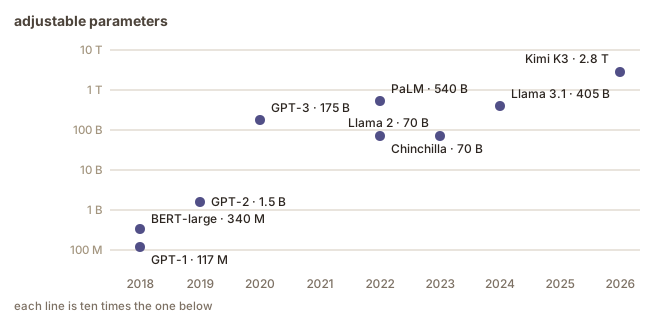
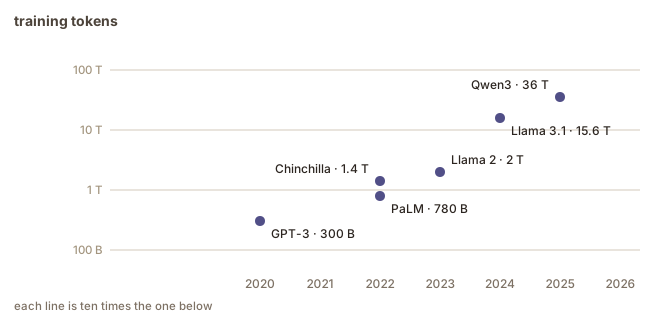
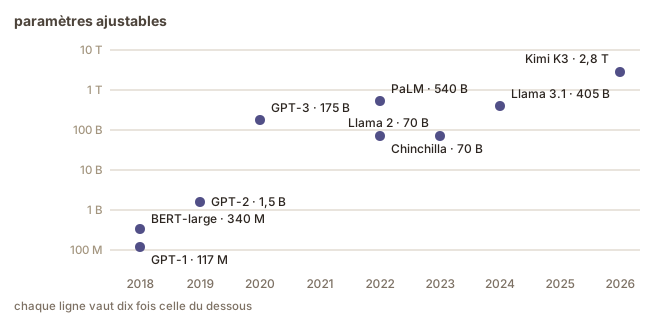
Figure 2. Number of adjustable parameters per model, 2018 to 2026, on a logarithmic scale. Kimi K3's 2.8 T is the total it contains; about 104 B of them run for any one token. Figures from Radford et al. (2019), Devlin et al. (2019), Brown et al. (2020), Hoffmann et al. (2022), Chowdhery et al. (2022), Touvron et al. (2023), Grattafiori et al. (2024) and Kimi Team (2026). Figure 3. Number of training tokens per model, 2020 to 2026, on a logarithmic scale. Figures from Brown et al. (2020), Hoffmann et al. (2022), Chowdhery et al. (2022), Touvron et al. (2023), Grattafiori et al. (2024) and Yang et al. (2025b).
The growth went into the text rather than into the model. Chinchilla and Llama 2
are smaller models than GPT-3 and were trained on several times more text, after
Hoffmann et al. (2022) showed that for a given amount of computation a smaller
model trained on more data does better (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
after 2023 the best-known models stopped publishing their figures
everything still plottable comes from the open-weight models
the scale of the closed ones is an estimate, not a record
Three things to say over the two charts. The reversal: Chinchilla and Llama 2
have fewer parameters than GPT-3 and were trained on far more text, because
Hoffmann and colleagues showed the models of the day were too large for the
amount of text they had been given. Kimi K3’s 2.8 trillion is the total it
contains, and only about 104 billion run for any one token, so it is not the
same measure as GPT-3’s 175 billion. And the reading comparison: 1.4 trillion
tokens is nine thousand years of nonstop reading, 36 trillion about two hundred
and thirty thousand.
Where the text comes from
Where the text comes from
Crawling the web
The largest single source for most models is a crawl of the public web.
A downloaded page comes with navigation menus, cookie banners, advertisements, boilerplate footers and the
HTML that structures all of it, so the running text has to be pulled out of the
markup first, and that extraction is itself imperfect.
What went into one published model
GPT-3 is a useful case because its composition was published, which is unusual
(Brown et al., 2020).
Source
Tokens
Share of training
Common Crawl (filtered)
410 billion
60 %
WebText2
19 billion
22 %
Books1
12 billion
8 %
Books2
55 billion
8 %
Wikipedia
3 billion
3 %
The table names sources it does not describe. Brown et al. (2020) account for
Books1 and Books2 in a single phrase, “two internet-based books corpora”, and
say nothing about what is in them or where they came from, although the two
together come to 67 billion tokens and Books2 alone is the second largest source
in the list.
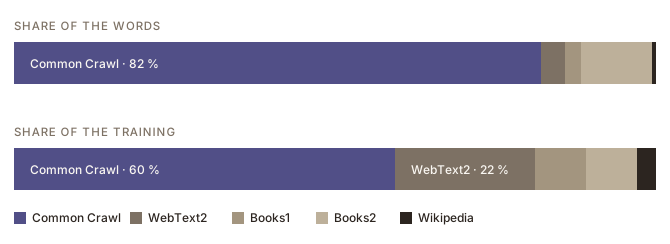
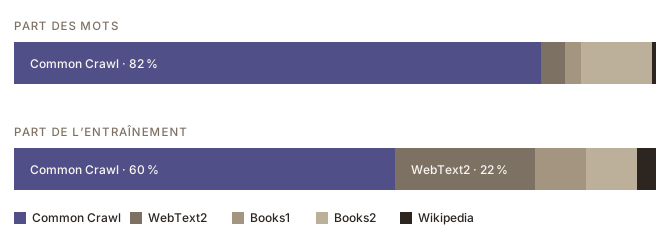
Figure 4. How much of the corpus each source is, and how much of the training it accounts for. Figures from Brown et al. (2020).
A source’s share of the words is the amount of text it contributed. Its share of
the training is the number of times the model read that text, and the two come
apart: Common Crawl is 82 % of the words and 60 % of the training, while
Wikipedia is well under 1 % of the words and 3 % of the training. So the model
went through Wikipedia several times over while seeing much of the crawl once or
not at all.
Sampling weights manage quality without anyone editing the text.
Sources trusted to be clean and well written are read repeatedly; the messy bulk
is read thinly.
Books1 and Books2: “two internet-based books corpora”, and nothing more
between them, 67 billion tokens
Books2 alone is the second largest source in the list
Where the text comes from
No labels on any of it
nothing marks the language, the genre, the reliability, the
author’s competence
a medical paper and a post inventing a cure: two sequences of tokens
The point of the two bars: Common Crawl is 82 % of the words and 60 % of the
training, Wikipedia 0.6 % of the words and 3 % of the training. Sampling
weights manage quality without anyone touching the text: clean sources are
reread, the messy bulk is read once or not at all.
Four things filtering tries to do
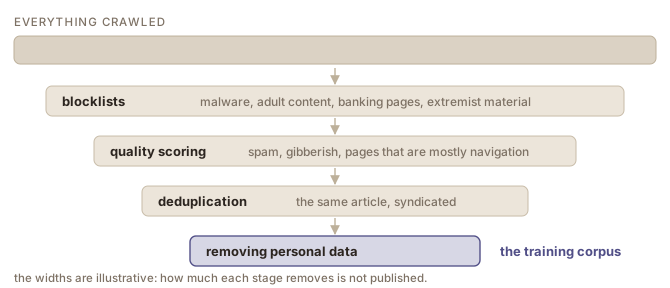
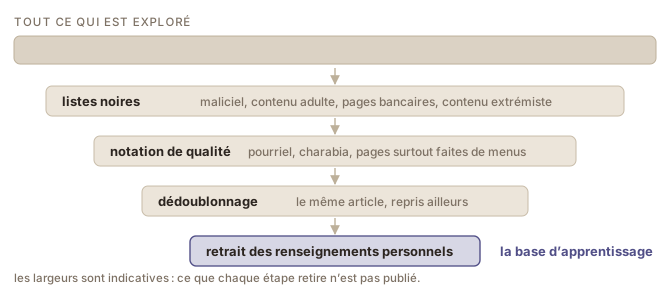
Figure 5. The four stages between a crawl and a training corpus. Sources from Brown et al. (2020).
Whole sites are excluded first, through blocklists covering malware, adult
content, banking pages and material judged extremist. Within what remains,
automatic scoring drops pages that look like spam or gibberish, pages that repeat
themselves, and pages that are mostly navigation and advertisement.
Near-duplicates are then removed. The same article is syndicated across dozens of
sites, and a model trained on the same text hundreds of times gives it that much
more weight, so deduplication is more important than it sounds. GPT-3’s builders describe both
document-level fuzzy deduplication and the removal of documents overlapping with
their evaluation sets (Brown et al., 2020).
Finally, there are attempts to remove personal information.
Why none of it works completely
These filters are automatic and approximate. Personal
information appears in forms no pattern anticipates, a phone number written out
in words or an address inside a scanned document, so some of it survives into
the corpus and can resurface in what a model produces.
And “low quality” is not a property the text has. Somebody decides
that this forum is worth keeping and that one is not, that this dialect reads as
error-strewn, that this topic is unsuitable. Those decisions are usually made
quickly, at scale, by people with a particular idea of what good writing looks
like, and they end up shaping what a model treats as normal
language (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
What gets filtered out
What gets filtered out
Why none of it works completely
the filters are automatic and approximate: a number written out in words,
an address inside a scan
“low quality” is not a property of the text: somebody decides which forum
to keep, which dialect reads as error-strewn
GPT-3 is quoted throughout because it is the exception, not the rule
How much of a corpus is English
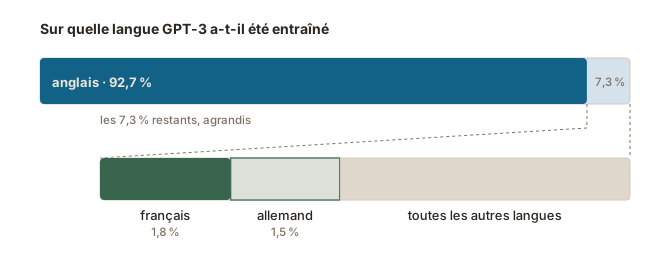
Xu et al. (2025) surveyed the corpora behind multilingual models and found
several, GPT-3 among them, trained on text more than 90 % English. For GPT-3
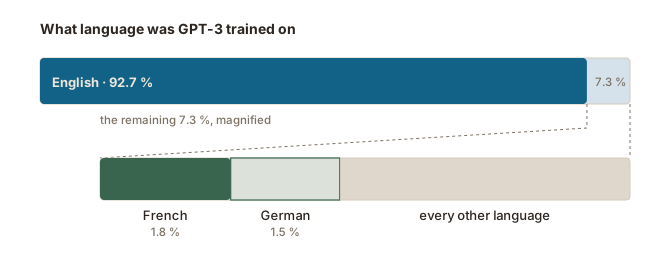
their figures are 92.7 % English, 1.8 % French, 1.5 % German and 5.9 %
everything else.
French, the second language on that list, is one of the best-served languages in
the world, and it still accounts for under a fiftieth of what the model read.
Figure 6. The remainder is magnified because at true scale French and German are slivers. Figures as reported by Xu et al. (2025).
There are many attempts at broadening language coverage, either in multilingual
models that include more data in other languages, or in models dedicated to a
single other language than English. Qwen3, released in 2025, was trained on text
in 119 languages and dialects, against 29 for the model it replaced (Yang et
al., 2025b). The reporting has not kept pace: almost no model in use publishes its
shares, which is why GPT-3 is still the example anyone can quote precisely.
Part of this reflects the web, which is itself skewed toward English. The rest is
decisions:
which crawls to include;
which quality filters to apply, since a filter trained on English rates other
languages badly;
whether to spend effort on languages that would each add little volume.
Joshi et al. (2020) documented how uneven the resources are across the world’s
languages, with a small number well provided for and the great majority having
almost nothing available at all.
Why this matters for translation
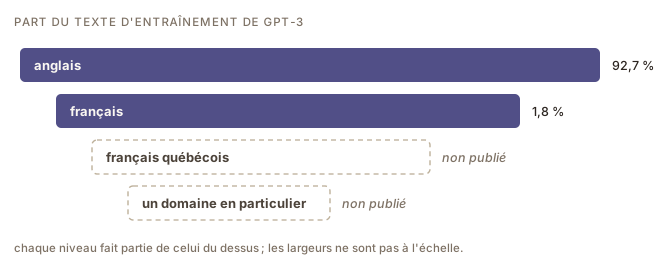
A general claim about what “an LLM” can do is not portable across languages. A
model that drafts fluent English may be
noticeably weaker in your other working language, and weaker again in a variety
of that language: Quebec French rather than metropolitan French, a regional
term, a domain where the local usage differs.
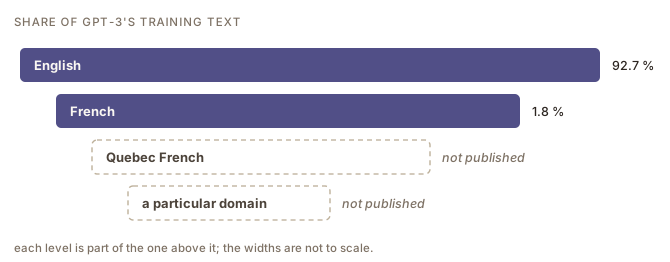
Figure 7. Each level is part of the one above it. The reported figures stop above the level a translator works at. Percentages from Xu et al. (2025).
Volume is not the only factor. Models trained on many languages do better in a
well-resourced language than models trained on that language alone, and they
align best between English and the languages closest to it, which puts French in
a comparatively good position on both counts. The benefit has a limit the field
calls the curse of multilinguality: at a fixed model size, supporting more
languages costs each of them (Xu et al., 2025).
This is a reason to test rather than assume. A model’s fluency is not evidence
about its accuracy, and it is least reliable in exactly the places where you
would be checking hardest anyway.
a claim about “an LLM” does not carry from one language to another
weaker again in a variety: Quebec French, a regional term, local usage
fluency is not evidence about accuracy
Which languages
Volume is not the only factor
a multilingual model does better than one trained on that language alone
alignment is best between English and the languages closest to it
but at a fixed size, more languages cost each of them: the curse of
multilinguality
Which languages
A second penalty, in tokens
The same sentence costs more tokens in most other languages.
a smaller effective context window
slower responses
a larger bill
Model collapse
Training data incest
a growing share of the web was produced by a model
the next model’s corpus contains the last one’s output
nothing in the pipeline can tell them apart
Model collapse
Three names for the same thing
Habsburg AI, after the royal house and its inbreeding
AI inbreeding
model autophagy disorder
Model collapse
Training data incest
Every corpus described so far was gathered by crawling, and the web has changed:
a substantial and growing part of the text on it was produced by a language
model. So the corpus for the next model contains the output of the last one, and
nothing in the pipeline can reliably tell the two apart.
The effect goes by other names. It circulates as Habsburg AI, after the royal
house whose portraits record the effects of inbreeding, for a system trained so
heavily on the output of other systems that its features come out exaggerated
and distorted; also as AI inbreeding, and as model autophagy disorder.
What happens when training on generated output?
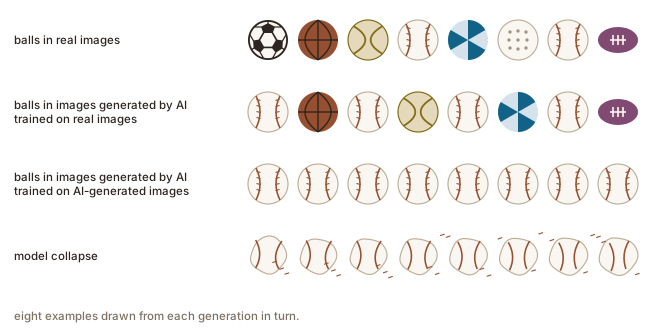
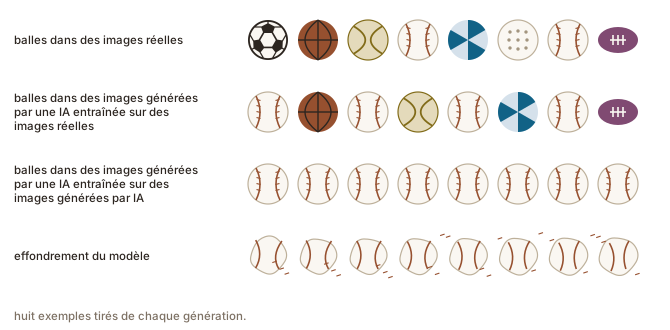
Shumailov et al. (2024) trained models on data generated by their predecessors,
over several generations, and found a consistent pattern. A model’s output
over-represents what was common in its training, so the next model sees a
narrower world than the one before it, and after enough repetitions the output
degenerates. The first things to go are whatever was least represented to begin
with: a regional variant, a specialized term that has a frequent near synonym, a
construction that is correct without being the one a model reaches for first.
Figure 8. Model collapse, illustrated with image generation of balls. After Shumailov et al. (2024).
Model collapse
What goes first
Whatever was least represented to begin with:
a regional variant
a specialized term with a frequent near synonym
a construction that is correct without being the first one reached for
Scope the finding honestly: Shumailov and colleagues replace the training data
completely at every generation, which is the sharpest version of the problem
and not the situation anyone is in. Gerstgrasser and colleagues tested the
milder case, adding synthetic data to real data rather than replacing it, and
found no collapse. A demonstrated mechanism and a reason to care about
provenance, not a dated prediction.
Quelle quantité de texte entre dans un modèle
Le jeu de données réuni pour entraîner GPT-3 comptait 499 milliards de jetons,
dont le modèle a vu 300 milliards pendant l’entraînement (Brown et al., 2020).
Quelques années plus tard, Chinchilla était entraîné sur 1 400 milliards
(Hoffmann et al., 2022). Les chiffres publiés n’ont cessé de grimper depuis :
15 600 milliards de jetons pour Llama 3.1 en 2024 (Grattafiori et al., 2024),
36 000 milliards pour Qwen3 en 2025 (Yang et al.,
2025b).Ce sont là les chiffres qui ont été publiés. Le rapport d’OpenAI
sur GPT-4 précise qu’il ne donne « aucun détail supplémentaire sur
l’architecture (y compris la taille du modèle), le matériel, le calcul
d’entraînement, la construction du jeu de données, la méthode d’entraînement ou
autre » (OpenAI, 2023), et les autres grands fournisseurs n’en disent pas
davantage. La taille des modèles que la plupart des gens utilisent aujourd’hui
relève donc de l’estimation plutôt que du fait établi.
Ces chiffres ne veulent pas dire grand-chose en eux-mêmes ; voici donc une
comparaison pour tenter de mieux les saisir :
À raison d’environ cinq jetons par seconde, sans s’arrêter pour manger ni pour
dormir, 1 400 milliards de jetons prendraient près de neuf mille ans. Les 36 000
milliards de Qwen3 en prendraient environ deux cent trente mille.
Figure 1. Les mêmes quantités exprimées en temps de lecture, la seule échelle dont la plupart d'entre nous disposent pour elles. Nombres de jetons tirés de Brown et al. (2020), Hoffmann et al. (2022) et Yang et al. (2025).
Comment les quantités ont augmenté
Figure 2. Nombre de paramètres ajustables par modèle, de 2018 à 2026, sur une échelle logarithmique. Les 2 800 milliards de Kimi K3 sont le total qu'il contient ; environ 104 milliards servent pour un jeton donné. Chiffres tirés de Radford et al. (2019), Devlin et al. (2019), Brown et al. (2020), Hoffmann et al. (2022), Chowdhery et al. (2022), Touvron et al. (2023), Grattafiori et al. (2024) et Kimi Team (2026). Figure 3. Nombre de jetons d'entraînement par modèle, de 2020 à 2026, sur une échelle logarithmique. Chiffres tirés de Brown et al. (2020), Hoffmann et al. (2022), Chowdhery et al. (2022), Touvron et al. (2023), Grattafiori et al. (2024) et Yang et al. (2025).
La croissance est allée au texte plutôt qu’au modèle. Chinchilla et Llama 2 sont
des modèles plus petits que GPT-3 et ont été entraînés sur plusieurs fois plus de
texte, après que Hoffmann et al. (2022) ont montré qu’à quantité de calcul
donnée, un modèle plus petit entraîné sur plus de données fait
mieux (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
après 2023, les modèles les plus connus ne publient plus leurs chiffres
tout ce qui reste traçable vient des modèles à poids ouverts
la taille des modèles fermés relève de l’estimation, pas du fait établi
Trois choses à dire sur les deux courbes. Le renversement : Chinchilla et
Llama 2 ont moins de paramètres que GPT-3 et ont été entraînés sur beaucoup plus
de texte, parce que Hoffmann et al. ont montré que les modèles de l’époque
étaient trop grands pour la quantité de texte qu’on leur donnait. Les 2 800
milliards de Kimi K3 sont le total : environ 104 milliards servent pour un
jeton donné, ce n’est donc pas la même mesure que les 175 milliards de GPT-3. Et
la comparaison de lecture : 1 400 milliards de jetons, c’est neuf mille ans de
lecture sans arrêt ; 36 000 milliards, deux cent trente mille.
D'où vient le texte
D'où vient le texte
L’exploration du Web
La principale source, pour la plupart des modèles, est une exploration du
Web public.
Une page téléchargée arrive avec ses menus de navigation, ses bandeaux de témoins,
ses publicités, ses pieds de page standardisés et le HTML qui structure le tout ;
il faut donc d’abord extraire le texte courant du balisage, et cette extraction
est elle-même imparfaite.
Ce qui est entré dans un modèle publié
GPT-3 est un cas utile parce que sa composition a été publiée, ce qui est rare
(Brown et al., 2020).
Source
Jetons
Part de l’entraînement
Common Crawl (filtré)
410 milliards
60 %
WebText2
19 milliards
22 %
Books1
12 milliards
8 %
Books2
55 milliards
8 %
Wikipédia
3 milliards
3 %
Le tableau nomme des sources qu’il ne décrit pas. Brown et al. (2020) rendent
compte de Books1 et de Books2 en une seule expression, « deux corpus de livres
tirés d’Internet », et ne disent rien de leur contenu ni de leur provenance,
alors que les deux réunis font 67 milliards de jetons et que Books2 est à lui
seul la deuxième source en importance de la liste.
Figure 4. La part du corpus que représente chaque source, et la part de l'entraînement qu'elle occupe. Chiffres tirés de Brown et al. (2020).
La part des mots d’une source est la quantité de texte qu’elle a fournie. Sa part
de l’entraînement est le nombre de fois que le modèle a lu ce texte, et les deux
se dissocient : Common Crawl représente 82 % des mots et 60 % de
l’entraînement, tandis que Wikipédia est bien en dessous de 1 % des mots et
compte pour 3 % de l’entraînement. Le modèle a donc parcouru Wikipédia
plusieurs fois, alors qu’il n’a vu qu’une fois, ou pas du tout, une bonne partie
de l’exploration.
Les poids d’échantillonnage gèrent la qualité sans que personne ne modifie le
texte. Les sources jugées propres et bien écrites sont lues à répétition ; la
masse brouillonne n’est lue que superficiellement.
Books1 et Books2 : « deux corpus de livres tirés d’Internet », et rien
de plus
à eux deux, 67 milliards de jetons
Books2 est à lui seul la deuxième source en importance de la liste
D'où vient le texte
Aucune étiquette
rien n’indique la langue, le genre, la fiabilité, la compétence
de l’auteur
un article médical et une publication qui invente un remède : deux suites
de jetons
Le point des deux barres : Common Crawl fait 82 % des mots et 60 % de
l’entraînement, Wikipédia 0,6 % des mots et 3 % de l’entraînement. Les poids
d’échantillonnage gèrent la qualité sans que personne ne touche au texte : les
sources propres sont relues, la masse brouillonne est lue une fois ou pas du
tout.
Quatre choses que le filtrage tente de faire
Figure 5. Les quatre étapes entre une exploration et une base d'apprentissage. Sources tirées de Brown et al. (2020).
Des sites entiers sont d’abord exclus, au moyen de listes noires couvrant les
maliciels, le contenu adulte, les pages bancaires et le contenu jugé extrémiste.
Dans ce qui reste, une notation automatique écarte les pages qui ressemblent à du
pourriel ou à du charabia, celles qui se répètent, et celles qui sont surtout
faites de menus et de publicité.
Les quasi-doublons sont ensuite supprimés. Un même article est repris sur des
dizaines de sites, et un modèle qui rencontre un texte des centaines de fois le
pondère en conséquence : le dédoublonnage compte donc plus qu’il n’y paraît.
Ceux qui ont construit GPT-3 décrivent à la fois un dédoublonnage approximatif au
niveau du document et le retrait des documents recoupant leurs jeux d’évaluation
(Brown et al., 2020).
Enfin, on tente de retirer les renseignements personnels.
Pourquoi rien de tout cela ne fonctionne complètement
Ces filtres sont automatiques et approximatifs. Les renseignements personnels
apparaissent sous des formes qu’aucun motif n’anticipe, un numéro de téléphone
écrit en toutes lettres ou une adresse à l’intérieur d’un document numérisé :
une partie survit donc jusque dans le corpus et peut ressortir dans ce que produit
un modèle.
Et la « faible qualité » n’est pas une propriété du texte. Quelqu’un décide
que tel forum mérite d’être conservé et tel autre non, que tel dialecte se lit
comme truffé de fautes, que tel sujet ne convient pas. Ces décisions se prennent
en général vite, à grande échelle, par des gens qui ont une idée particulière de
ce à quoi ressemble une bonne écriture, et elles finissent par façonner ce qu’un
modèle traite comme une langue
normale (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Ce qui est filtré
Ce qui est filtré
Pourquoi rien ne fonctionne complètement
les filtres sont automatiques et approximatifs : un numéro écrit en
toutes lettres, une adresse dans un document numérisé
la « faible qualité » n’est pas une propriété du texte : quelqu’un
décide quel forum garder, quel dialecte se lit comme fautif
GPT-4 : aucun détail sur la construction du jeu de données
GPT-3 est cité partout ici parce qu’il est l’exception, pas la règle
Quelle part d’un corpus est en anglais
Xu et al. (2025) ont recensé les corpus derrière les modèles multilingues et en
ont trouvé plusieurs, dont GPT-3, entraînés sur du texte anglais à plus de
90 %. Pour GPT-3, leurs chiffres sont 92,7 % d’anglais, 1,8 % de français,
1,5 % d’allemand et 5,9 % pour tout le reste.
Le français, deuxième langue de cette liste, est l’une des mieux servies au
monde, et il ne représente pourtant pas un cinquantième de ce que le modèle a lu.
Figure 6. Le reste est agrandi parce qu'à l'échelle réelle le français et l'allemand ne sont que de minces bandes. Chiffres rapportés par Xu et al. (2025).
Les tentatives d’élargir la couverture linguistique sont nombreuses, soit dans
des modèles multilingues qui intègrent davantage de données dans d’autres langues,
soit dans des modèles consacrés à une seule autre langue que l’anglais. Qwen3,
paru en 2025, a été entraîné sur du texte dans 119 langues et dialectes, contre
29 pour le modèle qu’il remplace (Yang et al., 2025b). La publication des
chiffres n’a pas suivi : presque aucun modèle en usage ne publie ses
proportions, et c’est pourquoi GPT-3 reste l’exemple que l’on peut citer avec
précision.
Cela tient en partie au Web, lui-même orienté vers l’anglais. Le reste tient à des
décisions :
quelles explorations inclure ;
quels filtres de qualité appliquer, puisqu’un filtre entraîné sur de l’anglais
note mal les autres langues ;
s’il vaut la peine de consacrer des efforts à des langues qui n’ajouteraient
chacune que peu de volume.
Joshi et al. (2020) ont documenté à quel point les ressources sont inégales
entre les langues du monde, un petit nombre étant bien pourvues et la grande
majorité n’ayant presque rien de disponible.
Pourquoi cela compte en traduction
Une affirmation générale sur ce que « un GML » sait faire ne se transporte pas
d’une langue à l’autre. Un modèle qui rédige un anglais fluide peut être
nettement plus faible dans votre autre langue de travail, et plus faible encore
dans une variété de cette langue : le français québécois plutôt que le français
hexagonal, un terme régional, un domaine où l’usage local diffère.
Figure 7. Chaque niveau fait partie de celui du dessus. Les chiffres publiés s'arrêtent au-dessus du niveau où travaille un traducteur. Pourcentages tirés de Xu et al. (2025).
Le volume n’est pas le seul facteur. Les modèles entraînés sur de nombreuses
langues font mieux dans une langue bien pourvue que les modèles entraînés sur
cette seule langue, et ils alignent le mieux l’anglais et les langues qui en sont
les plus proches, ce qui place le français en assez bonne position sur les deux
plans. L’avantage a une limite que le domaine appelle la malédiction du
multilinguisme : à taille de modèle fixe, prendre en charge plus de langues
coûte à chacune d’elles (Xu et al., 2025).
C’est une raison de tester plutôt que de présumer. La fluidité d’un modèle ne
renseigne pas sur son exactitude, et elle est la moins fiable précisément là où
vous vérifieriez le plus attentivement de toute façon.
une affirmation sur « un GML » ne se transporte pas d’une langue à
l’autre
plus faible encore dans une variété : français québécois, terme
régional, usage local
la fluidité ne renseigne pas sur l’exactitude
Quelles langues
Le volume n’est pas le seul facteur
un modèle multilingue fait mieux qu’un modèle entraîné sur la seule langue
l’alignement est meilleur entre l’anglais et les langues qui en sont
proches
mais à taille fixe, ajouter des langues coûte à chacune : la malédiction
du multilinguisme
Quelles langues
Une seconde pénalité, en jetons
La même phrase coûte plus de jetons dans la plupart des autres langues.
une fenêtre contextuelle effective plus petite
des réponses plus lentes
une facture plus élevée
Effondrement du modèle
L’inceste des données d’entraînement
une part croissante du Web a été produite par un modèle
le corpus du prochain modèle contient la sortie du précédent
rien dans la chaîne ne permet de les distinguer
Effondrement du modèle
Trois noms pour la même chose
IA Habsbourg, du nom de la maison royale et de sa consanguinité
consanguinité de l’IA
trouble d’autophagie des modèles
Effondrement du modèle
L’inceste des données d’entraînement
Tous les corpus décrits jusqu’ici ont été réunis par exploration, et le Web a
changé : une part substantielle et croissante du texte qui s’y trouve a été
produite par un modèle de langue. Le corpus du prochain modèle contient donc la
sortie du précédent, et rien dans la chaîne de traitement ne permet de les
distinguer de façon fiable.
Le phénomène porte d’autres noms. Il circule sous celui d’IA Habsbourg, du nom de
la maison royale dont les portraits gardent la trace des effets de la
consanguinité, pour un système entraîné si lourdement sur la sortie d’autres
systèmes que ses traits ressortent exagérés et déformés ; on parle aussi de
consanguinité de l’IA et de trouble d’autophagie des modèles.
Que se passe-t-il quand on s’entraîne sur du texte généré ?
Shumailov et al. (2024) ont entraîné des modèles sur des données produites par
leurs prédécesseurs, sur plusieurs générations, et ont constaté un motif
constant. La sortie d’un modèle surreprésente ce qui était fréquent dans son
entraînement : le modèle suivant voit donc un monde plus étroit que celui d’avant,
et après assez de répétitions la sortie dégénère. Ce qui disparaît en premier,
c’est ce qui était le moins représenté au départ : une variante régionale, un
terme spécialisé doublé d’un quasi-synonyme fréquent, une construction correcte
sans être celle vers laquelle un modèle se tourne d’abord.
Figure 8. L'effondrement du modèle, illustré par la génération d'images de balles. D'après Shumailov et al. (2024).
Effondrement du modèle
Ce qui disparaît en premier
Ce qui était le moins représenté au départ :
une variante régionale
un terme spécialisé doublé d’un quasi-synonyme fréquent
une construction correcte sans être la première venue
Cadrer le résultat honnêtement : Shumailov et al. remplacent entièrement les
données à chaque génération, ce qui est la version la plus tranchée du problème
et non la situation réelle. Gerstgrasser et al. ont éprouvé le cas plus
modéré, en ajoutant des données synthétiques aux données réelles au lieu de les
remplacer, et n’ont pas observé d’effondrement. Un mécanisme démontré et une
raison de se soucier de la provenance, pas une prédiction datée.
The page behind this slideLa page derrière cette diapositive
1 / 2The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter