Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Autocomplete
Type Good into a message on your phone. Your keyboard will suggest the next words it predicts to be most likely: morning, night, luck. Add one letter, Good m, and the list narrows to morning. Nothing in the keyboard understands what you are writing. It is answering a single question: given the words already typed, which word is likely to come next?
Your keyboard answers from something small. The older way is a frequency table: the keyboard has counted which words followed Good, in the text it was built from and in your own past messages, and suggests the most frequent one. Current keyboards run a small neural network neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. instead, with a vocabulary of around ten thousand words and about a megabyte of storage on the phone (Hard et al., 2018). Either way it looks one or two words behind the cursor.
Click Figure 1figure 1 to test the quality of the autocomplete on my phone.
The same question with more behind it
Compare the results from the autocomplete in Figure 1figure 1 with what we have come to expect from large language models (LLMs) like ChatGPT, Claude, Gemini, etc.
To understand the difference in quality, consider these important differences:
- LLMs are far bigger. The keyboard’s model is around a million adjustable numbers, small enough to sit on the phone in your hand. LLMs have billions of them, and they run on hardware you never see.
- LLMs learned from far more text, written by other people. Your keyboard learned from a modest word list and from your own past messages. LLMs are trained on a very large and varied collection of text. Their vocabulary, their phrasing and their factual associations all come from there.
- LLMs read far more of what you already typed. Where the keyboard uses the last word or two, they take thousands of tokens of preceding text into account, so a pronoun twenty sentences back can still affect what they predict now.
- LLMs represent each word far more richly, and not the same way twice. Both turn words into word embeddings word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , vectors of numbers standing for a word (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). The keyboard’s are about ninety-six numbers long and fixed once, so bank is the same vector in every sentence you type. An LLM’s run to thousands of numbers and are recomputed for the sentence at hand by the attention mechanism attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , which decides which of the earlier words matter for the word being predicted now (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
One objective to solve many tasks
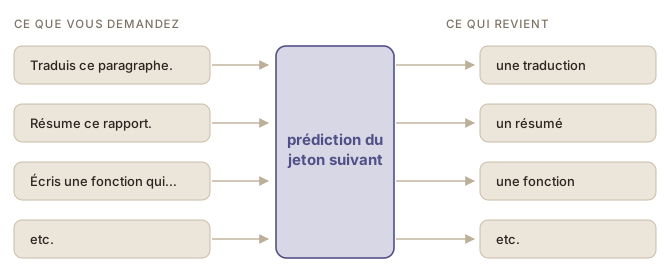
While LLMs are trained just to predict the next most probable token, that single objective manages to create systems that are good at many tasks. This is quite different from the previous generation of NLP natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. systems, where we had more specialized dedicated tools per task. Instead of one translation model, one summarizing model, one code completion model, we now have one giant LLM able to do it all.
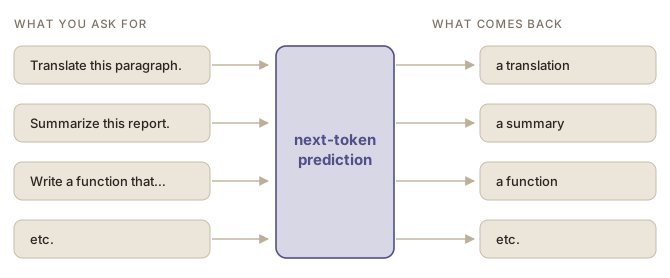
The keyboard figure is the hook: tapping the middle suggestion collapses into “of a bit of a bit of a bit”, and the same half-written message given to a model comes back finished. Worth typing live on a phone if the room wants to see it happen.
Large?
A phone keyboard and large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. are both language models. Clearly, the large here makes a big difference. So in what ways, specifically, is a large language model so large?
- Billions of parameters. Every association the model has picked up, between words, between a country and its capital, between a question and the shape of an answer, is stored across those numbers and nowhere else.
- A large context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . An LLM takes thousands of tokens of text into account at once and weighs all of them, where earlier systems built on the same transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. architecture usually worked a sentence at a time (Vaswani et al., 2017; Voita et al., 2019). The window is still bounded, though, and text that falls outside it might as well not exist (see also the Inference chapter) (voir aussi le chapitre Inférence).
- A vast corpus of training text. The largest models are trained on close to as much text as can be gathered: a crawl web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. of the public web, plus books, reference works, news and code (see also the Training data chapter) (voir aussi le chapitre Les données d'entraînement). That breadth lets one model be asked about cooking, contract law and Python in the same conversation.
What GPT stands for
GPT is short for Generative Pre-trained Transformer, and each of the three letters names a property of the model. Radford et al. (2018) introduced the model the name comes from, describing the method as generative pre-training of a transformer-based language model; the acronym itself came into use later.
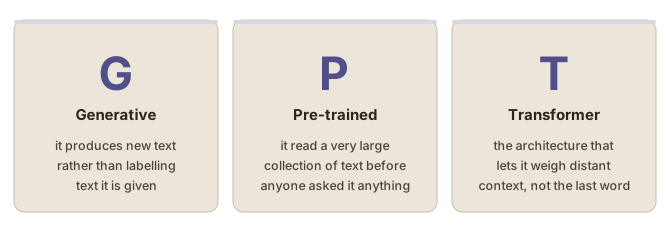
The aside on the page is worth a sentence out loud: nearly every current large language model is a transformer, so the two words get used as one, but nothing in the definition of a language model requires that architecture.
Finishing one sentence
Take an unfinished sentence: The bank was closed because…
Before anything sensible can follow, one thing has to be settled: which bank this is. The financial sense and the riverside sense lead to entirely different continuations, and the sentence so far does not say which is meant. This is the ambiguity a single fixed vector per word could not resolve (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Settle it on the financial sense, and the continuation still depends on knowing how businesses work: a bank closes for a public holiday, for renovations, at the end of the working day, or permanently because it failed.
And even once you have settled the ambiguity and know enough about the world to suggest a plausible reason, the continuation still has to be grammatical. The bank was closed because holiday gives the right reason and is not a sentence.
What has to be learned
Predicting well across many different texts means having picked up several kinds of regularity at once:
- grammar, syntax and the conventions of a style;
- facts about the world, and the relations between the things named in it;
- patterns of reasoning, such as cause and effect or the order events happen in;
- how people actually use language, including implication and politeness.
None of this is taught separately. Guessing the next word needs all of it, so it all comes out of practising the guess.
Too much text to remember
The amount of text involved rules out the simplest explanation, that the model has the training text stored somewhere. Hoffmann et al. (2022) trained a model of 70 billion parameters on 1.4 trillion tokens. At roughly four characters a token, keeping that text would take about five terabytes, more than most laptops can store. The model that came out of it is 70 billion numbers at two bytes each, about 140 gigabytes, which fits on one laptop with room left over.
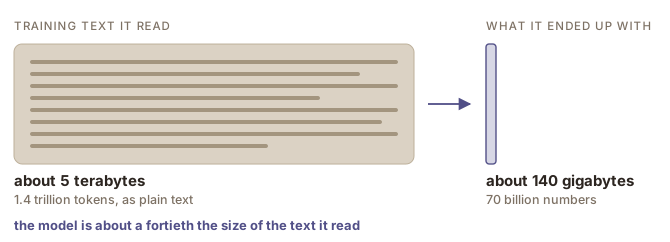
The text itself does not survive that reduction. To predict Paris after the capital of France is, a model does not need that sentence stored; it needs the association between France and Paris, which takes far less room and also works in sentences it has never seen. Karpathy calls the result a lossy compression of the training text (Karpathy, 2023).
It is a metaphor rather than a technical account, and it makes the right point: the output stays recognizably derived from text that was never kept (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
None of the four is taught separately: all of it is what it takes to guess the next word, so all of it comes out of practising that guess. Then the ratio: twenty tokens of training text per parameter, so the text cannot be in there. Karpathy’s “lossy compression” is a metaphor, and it makes the right point.
What happens after you press enter
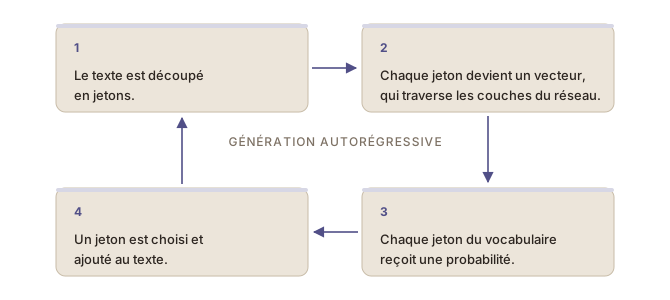
Your prompt goes through the same four steps every time.
- The text is split into tokens (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
- Each token becomes a vector, and those vectors pass through the network’s layers.
- The model produces a score for every token in its vocabulary, turned into a probability.
- One token is picked, appended to the text, and the process starts again from step 1.
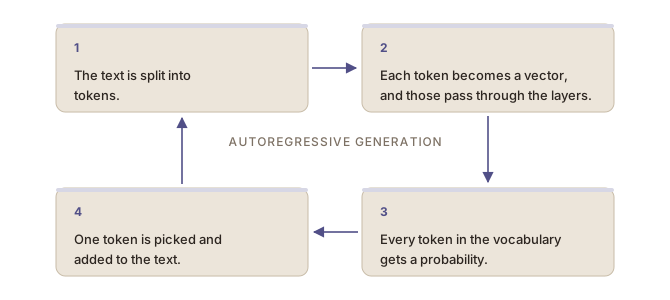
Every token gets a probability
The third step is the one that gets misread. Asked to continue My favourite colour is, the model does not decide on blue. It produces a number for every single token it knows, tens of thousands of them, and those numbers add up to one.
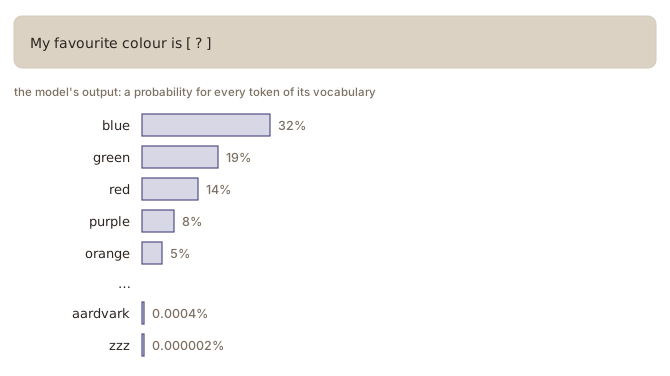
Most of them are absurd here and get probabilities near zero, but they are all scored. Choosing one of them is a separate step, taken after the computation, and the highest number does not always win (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
Why the text arrives the way it does
From the outside a model looks as though it reads your question once and writes the answer. Each token in that answer is a separate pass, and every pass reads the prompt together with everything the model has already added.
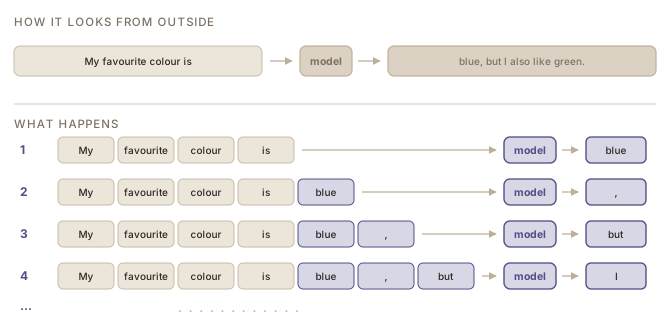
An answer of five hundred tokens is five hundred of those passes. Two consequences to consider:
- The output appears steadily rather than all at once, because each token has to wait for the one before it.
- The model has no draft. It commits to each token before computing the next, so it cannot plan a sentence, notice halfway that the ending will not work, and revise the beginning.
The second one is the point to land: it cannot plan a sentence, notice halfway that the ending will not work, and revise the beginning. Which choice is made from the distribution is a separate decision, taken after the computation, and that is the inference chapter at séance 3.
La saisie automatique
Tapez Good dans un message sur votre téléphone. Votre clavier vous proposera les mots qu’il juge les plus probables ensuite : morning, night, luck. Ajoutez une lettre, Good m, et la liste se réduit à morning. Rien dans le clavier ne comprend ce que vous écrivez. Il répond à une seule question : étant donné les mots déjà tapés, quel mot a le plus de chances de suivre ?
Votre clavier répond à partir de quelque chose de petit. La façon la plus ancienne est une table de fréquences : le clavier a compté quels mots suivaient Good, dans le texte à partir duquel il a été construit et dans vos propres messages, et il suggère le plus fréquent. Les claviers actuels font plutôt tourner un petit réseau de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. , avec un vocabulaire d’environ dix mille mots et près d’un mégaoctet de stockage sur le téléphone (Hard et al., 2018). Dans les deux cas, il regarde un mot ou deux avant le curseur.
Cliquez sur Figure 1figure 1 pour tester la qualité de la saisie automatique sur mon téléphone.
La même question, avec bien plus derrière
Comparez les résultats de la saisie automatique de Figure 1figure 1 avec ce que nous avons pris l’habitude d’attendre des grands modèles de langue (GML) comme ChatGPT, Claude, Gemini, etc.
Pour comprendre la différence de qualité, voici les différences importantes :
- Les GML sont bien plus gros. Le modèle du clavier compte environ un million de nombres ajustables, assez peu pour tenir dans le téléphone que vous avez en main. Les GML en ont des milliards, et ils tournent sur du matériel que vous ne voyez jamais.
- Les GML ont appris sur bien plus de texte, écrit par d’autres. Votre clavier a appris à partir d’une liste de mots modeste et de vos propres messages. Les GML sont entraînés sur une collection de textes très vaste et très variée. Leur vocabulaire, leurs tournures et leurs associations factuelles viennent tous de là.
- Les GML lisent bien plus de ce que vous avez déjà tapé. Là où le clavier se sert du dernier mot ou des deux derniers, ils prennent en compte des milliers de jetons de texte précédent, si bien qu’un pronom vingt phrases plus haut peut encore influer sur ce qu’ils prédisent maintenant.
- Les GML représentent chaque mot bien plus richement, et jamais deux fois de la même façon. Les deux transforment les mots en plongements lexicaux word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , des vecteurs de nombres qui tiennent lieu de mot (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). Ceux du clavier font environ quatre-vingt-seize nombres et sont fixés une fois pour toutes, de sorte que bank est le même vecteur dans toutes les phrases que vous tapez. Ceux d’un GML vont jusqu’à des milliers de nombres et sont recalculés pour la phrase en cours par le mécanisme d’attention attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , qui décide quels mots précédents comptent pour le mot en train d’être prédit (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
Un seul objectif pour résoudre de nombreuses tâches
Alors que les GML sont entraînés uniquement à prédire le jeton suivant le plus probable, cet objectif unique parvient à créer des systèmes qui sont bons dans de nombreuses tâches. C’est très différent de la génération précédente de systèmes de TAL natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. , où l’on avait des outils spécialisés et dédiés, un par tâche. Au lieu d’un modèle de traduction, d’un modèle de résumé, d’un modèle de complétion de code, nous avons maintenant un seul GML géant capable de tout faire.
La figure du clavier est l’accroche : en touchant la suggestion du milieu, le message finit par tourner en rond, « je vous remercie de votre réponse je vous remercie ». Cliquer la figure étape par étape devant la salle. À faire en direct sur un téléphone si le groupe veut le voir arriver.
Grand ?
Un clavier de téléphone et les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. sont tous des modèles de langue. De toute évidence, le « grand » fait ici une grande différence. Alors, en quoi, précisément, un grand modèle de langue est-il si grand ?
- Des milliards de paramètres. Chaque association que le modèle a captée, entre des mots, entre un pays et sa capitale, entre une question et la forme d’une réponse, est stockée à travers ces nombres et nulle part ailleurs.
- Une grande fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . Un GML prend en compte des milliers de jetons de texte à la fois et les pondère tous, là où les systèmes antérieurs bâtis sur la même architecture transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. travaillaient généralement une phrase à la fois (Vaswani et al., 2017 ; Voita et al., 2019). La fenêtre reste toutefois bornée, et le texte qui en sort n’existe pour ainsi dire plus (see also the Inference chapter) (voir aussi le chapitre Inférence).
- Un corpus d’entraînement colossal. Les plus grands modèles sont entraînés sur presque tout le texte qu’il est possible de rassembler : une exploration du Web web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. public, plus des livres, des ouvrages de référence, des nouvelles et du code (see also the Training data chapter) (voir aussi le chapitre Les données d'entraînement). Cette ampleur permet d’interroger un même modèle sur la cuisine, le droit des contrats et Python dans une même conversation.
Ce que veut dire GPT
GPT est l’abréviation de Generative Pre-trained Transformer, et chacune des trois lettres nomme une propriété du modèle. Radford et al. (2018) ont présenté le modèle dont vient le nom, en décrivant la méthode comme un préentraînement génératif d’un modèle de langue fondé sur un transformeur ; l’acronyme lui-même s’est répandu plus tard.
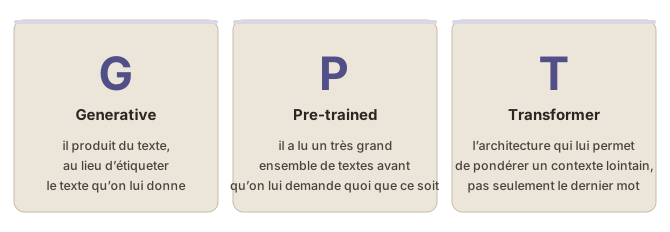
L’encadré de la page vaut une phrase à voix haute : presque tous les grands modèles de langue actuels sont des transformeurs, d’où les deux termes employés comme un seul, mais rien dans la définition d’un modèle de langue n’exige cette architecture.
Terminer une phrase
Prenez une phrase inachevée : The bank was closed because…
Avant que quoi que ce soit de sensé puisse suivre, une chose doit être réglée : de quelle bank il s’agit. Le sens financier et le sens de la rive mènent à des suites entièrement différentes, et la phrase telle quelle ne dit pas lequel est visé. C’est l’ambiguïté qu’un vecteur unique et fixe par mot ne pouvait pas lever (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Réglez-la sur le sens financier, et la suite dépend encore de ce que l’on sait du fonctionnement des entreprises : une banque ferme pour un jour férié, pour des rénovations, à la fin de la journée de travail, ou définitivement parce qu’elle a fait faillite.
Et même une fois l’ambiguïté réglée et le monde assez bien connu pour proposer une raison plausible, la suite doit encore être grammaticale. The bank was closed because holiday donne la bonne raison et n’est pas une phrase.
Ce qu’il faut avoir appris
Bien prédire à travers des textes très divers suppose d’avoir capté plusieurs sortes de régularités à la fois :
- la grammaire, la syntaxe et les conventions d’un style ;
- des faits sur le monde, et les relations entre les choses qu’on y nomme ;
- des schémas de raisonnement, comme la cause et l’effet ou l’ordre dans lequel les événements se produisent ;
- la façon dont les gens emploient réellement la langue, sous-entendus et politesse compris.
Rien de tout cela n’est enseigné à part. Prédire le mot suivant exige tout cela, si bien que tout cela sort de l’exercice répété de la prédiction.
Trop de texte pour s’en souvenir
La quantité de texte en jeu écarte l’explication la plus simple, celle où le modèle aurait le texte d’entraînement stocké quelque part. Hoffmann et al. (2022) ont entraîné un modèle de 70 milliards de paramètres sur 1 400 milliards de jetons. À environ quatre caractères par jeton, conserver ce texte prendrait quelque cinq téraoctets, plus que ne contiennent la plupart des ordinateurs portables. Le modèle qui en est sorti, c’est 70 milliards de nombres à deux octets chacun, environ 140 gigaoctets, qui tiennent sur un seul portable avec de la place en trop.
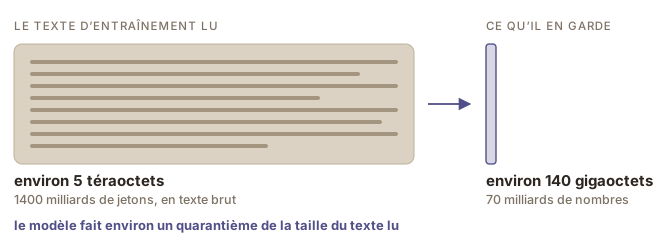
Le texte lui-même ne survit pas à cette réduction. Pour prédire Paris après the capital of France is, un modèle n’a pas besoin d’avoir cette phrase en mémoire : il a besoin de l’association entre la France et Paris, qui prend bien moins de place et vaut aussi dans des phrases qu’il n’a jamais vues. Karpathy (2023) appelle le résultat une compression avec perte du texte d’entraînement.
C’est une métaphore plutôt qu’un compte rendu technique, et elle vise juste : la sortie reste visiblement dérivée d’un texte qui n’a jamais été conservé (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
Rien de tout cela n’est enseigné à part : tout cela sort de l’exercice répété de la prédiction. Puis le rapport : conserver le texte prendrait cinq téraoctets, le modèle en fait cent quarante gigaoctets, donc le texte ne peut pas être dedans. La « compression avec perte » de Karpathy est une métaphore, et elle vise juste.
Ce qui se passe quand vous appuyez sur Entrée
Votre requête passe par les quatre mêmes étapes à chaque fois.
- Le texte est découpé en jetons (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
- Chaque jeton devient un vecteur, et ces vecteurs traversent les couches du réseau.
- Le modèle produit une note pour chaque jeton de son vocabulaire, convertie en probabilité.
- Un jeton est choisi, ajouté au texte, et tout reprend à l’étape 1.
Chaque jeton reçoit une probabilité
La troisième étape est celle que l’on interprète mal. Quand on lui demande de continuer My favourite colour is, le modèle ne décide pas blue. Il produit un nombre pour chacun des jetons qu’il connaît, des dizaines de milliers, et ces nombres font 1 au total.
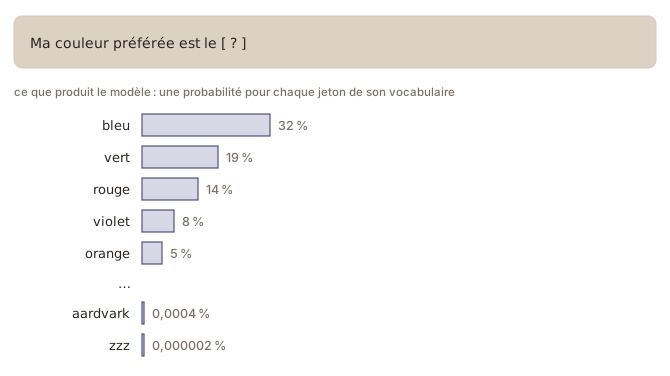
La plupart sont absurdes ici et reçoivent des probabilités proches de zéro, mais ils sont tous notés. En choisir un est une étape distincte, qui a lieu après le calcul, et le nombre le plus élevé ne l’emporte pas toujours (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
Pourquoi le texte arrive comme il arrive
Vu de l’extérieur, un modèle a l’air de lire votre question une fois et d’écrire la réponse. Chaque jeton de cette réponse est un passage distinct, et chaque passage lit la requête en même temps que tout ce que le modèle a déjà ajouté.
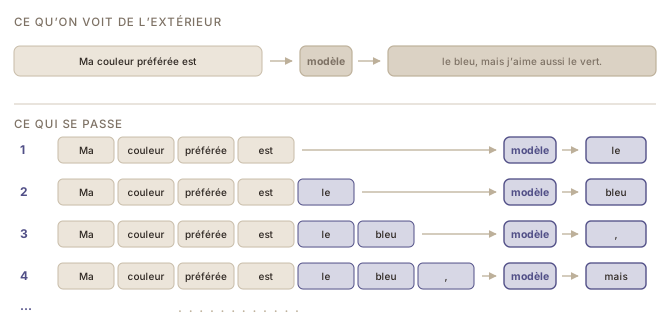
Une réponse de cinq cents jetons, ce sont cinq cents de ces passages. Deux conséquences à retenir :
- La sortie arrive progressivement plutôt que d’un seul coup, parce que chaque jeton doit attendre celui qui le précède.
- Le modèle n’a pas de brouillon. Il s’engage sur chaque jeton avant de calculer le suivant, si bien qu’il ne peut pas prévoir une phrase, s’apercevoir à mi-chemin que la fin ne fonctionnera pas, et revenir sur le début.
C’est la seconde qu’il faut faire passer : il ne peut pas prévoir une phrase, s’apercevoir à mi-chemin que la fin ne fonctionnera pas, et revenir sur le début. Le choix fait dans la distribution est une décision distincte, prise après le calcul, et c’est le chapitre sur l’inférence à la séance 3.