This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
LLM lifecycleCycle de vie des GML
InferenceInférence
LLM lifecycleCycle de vie des GML
InferenceInférence
InferenceInférence
The context windowLa fenêtre contextuelle
LLMs are non-deterministicLes GML ne sont pas déterministes
Temperature, top-p and top-kTempérature, top-p et top-k
Errors spread through contextLes erreurs se propagent dans le contexte
Reasoning step by stepRaisonner étape par étape
Key pointsL'essentiel
InferenceInférence
is using the trained model: the parameters are fixed, so nothing you say in a conversation changes it.
L' consiste à utiliser le modèle entraîné : les paramètres sont figés, si bien que rien de ce que vous dites dans une conversation ne le modifie.
inference · fr: inférence inférence · en : inference machine learningapprentissage automatique : The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée.
Key pointsL'essentiel
InferenceInférence
The contains the system prompt, saved instructions and memory, the conversation, your prompt and the answer being written, and the answer has a separate token limit of its own.
La contient la requête générative système, les instructions enregistrées et la mémoire, la conversation, votre requête et la réponse en cours de rédaction, et la réponse a sa propre limite de jetons.
context window · fr: fenêtre contextuelle fenêtre contextuelle · en : context window language modelsmodèles de langue : "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre).
Key pointsL'essentiel
InferenceInférence
A large window is a limit rather than a promise: models use the whole of one measurably less well than they use a small part.
Une grande fenêtre est une limite plutôt qu'une promesse : les modèles utilisent nettement moins bien la totalité de leur fenêtre qu'une petite partie de celle-ci.
Key pointsL'essentiel
InferenceInférence
The model produces probabilities and a separate step picks a token. Chat assistants are not , so one output is not evidence.
Le modèle produit des probabilités, et une étape distincte de choisit un jeton. Les agents conversationnels ne sont pas , si bien qu'une seule réponse ne prouve rien.
decoding · fr: décodage décodage · en : decoding language modelsmodèles de langue : The process used during text generation to turn a language model's predicted probabilities into an actual sequence of output tokens.Processus qui, pendant la génération de texte, transforme les probabilités prédites par un modèle de langue en une séquence réelle de jetons de sortie.
deterministic · fr: déterministe déterministe · en : deterministic computinginformatique : Describes a process, algorithm, or system that, under the same initial conditions and with the same input, always produces the same output.Se dit d'un processus, d'un algorithme ou d'un système qui, dans les mêmes conditions initiales et avec la même entrée, produit toujours la même sortie.
Key pointsL'essentiel
InferenceInférence
A model cannot change a token once it is written, so a wrong detail early becomes part of what the rest of the answer is written to agree with.
Un modèle ne peut plus modifier un jeton une fois écrit, si bien qu'un détail erroné au début devient une base avec laquelle le reste de la réponse est rédigé pour s'accorder.
Key pointsL'essentiel
InferenceInférence
A model only ever predicts the next token, so writing out the steps spreads the work of a hard problem over many tokens; that helps most on problems that can be calculated, and much less elsewhere.
Un modèle ne fait que prédire le jeton suivant ; écrire les étapes répartit donc le travail d'un problème difficile sur de nombreux jetons, ce qui aide surtout pour les problèmes qui peuvent être calculés, et beaucoup moins ailleurs.
Page 1Page 1
InferenceInférence
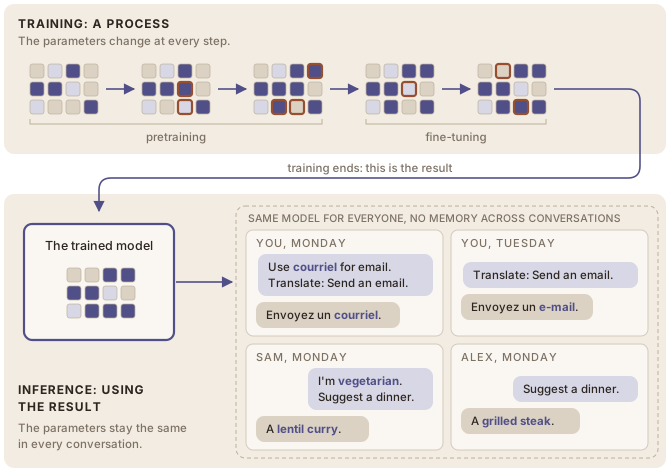
is simply the process of using a trained model. In contrast to the training phases, during inference, the model itself (its parameters) no longer changes.
Every new conversation uses the same fixed model. The commercial model you use is identical to the one used by everyone else using that same service.
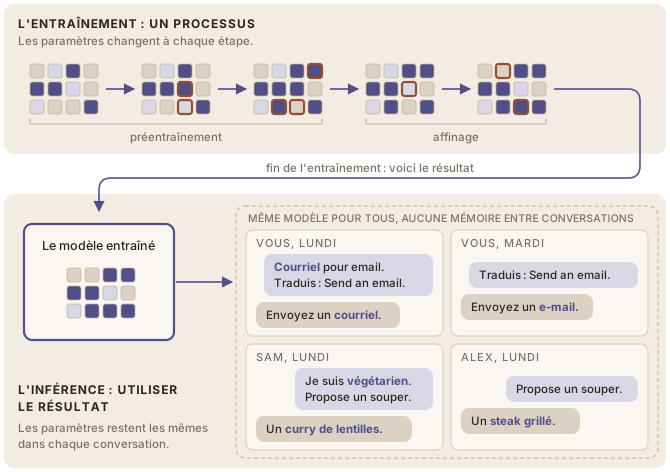
L' est simplement le fait d'utiliser un modèle entraîné. Contrairement à ce qui se passe pendant l'entraînement, le modèle lui-même (ses paramètres) ne change plus pendant l'inférence.
Chaque nouvelle conversation utilise le même modèle figé. Le modèle commercial que vous utilisez est identique à celui qu'utilisent toutes les autres personnes qui se servent du même service.
inference · fr: inférence inférence · en : inference machine learningapprentissage automatique : The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée.
Page 1Page 1
Figure 1. Training changes the parameters step by step; the model it leaves behind answers every conversation without changing. Figure 1. L'entraînement modifie les paramètres étape par étape ; le modèle qui en résulte répond à chaque conversation sans changer.
Page 2Page 2
The context windowLa fenêtre contextuelle
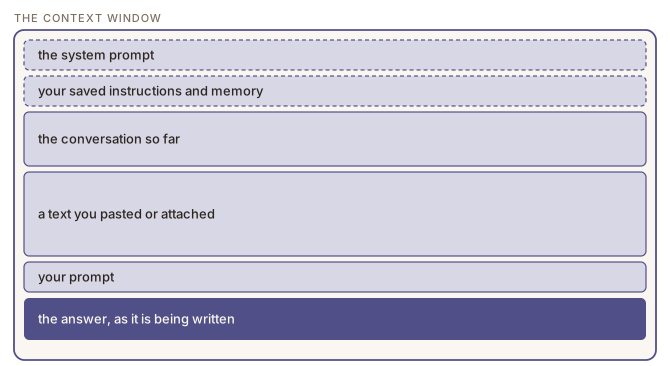
The is everything a model can see at once, and every part of a request competes for the same room.
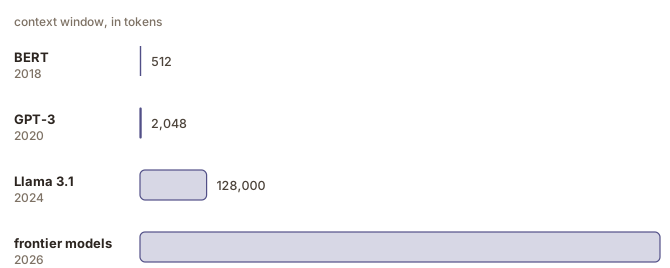
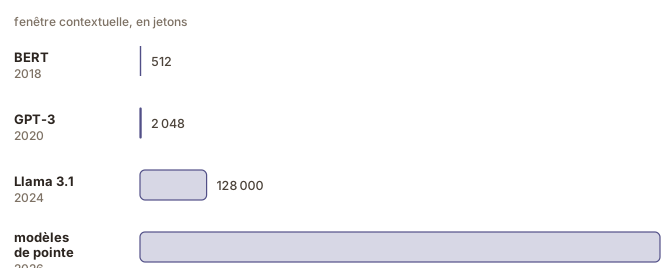
An advertised window is a limit, not a promise: reliable use of the whole of it is measurably worse than use of a small part.
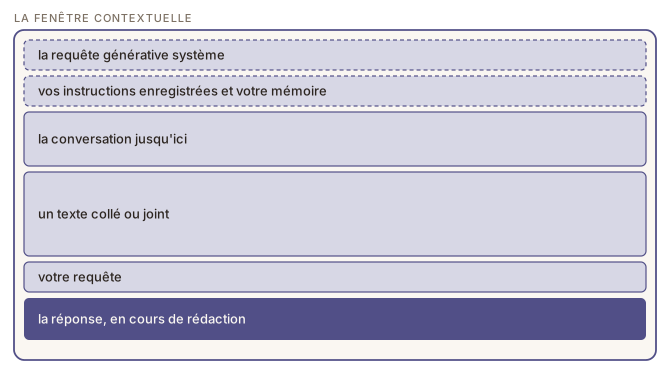
La correspond à tout ce qu'un modèle peut voir à la fois, et chaque partie d'une requête se dispute la même place.
La taille annoncée d'une fenêtre est une limite, pas une promesse : un modèle utilise nettement moins bien la totalité de sa fenêtre qu'une petite partie de celle-ci.
context window · fr: fenêtre contextuelle fenêtre contextuelle · en : context window language modelsmodèles de langue : "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre).
Page 2Page 2
Figure 2. What the context window contains. Figure 2. Ce que contient la fenêtre contextuelle.
Page 2Page 2
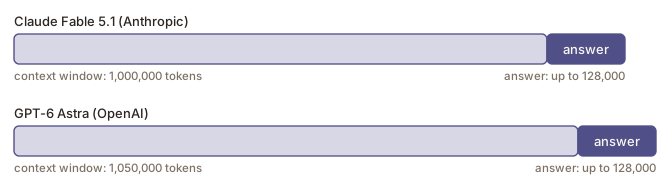
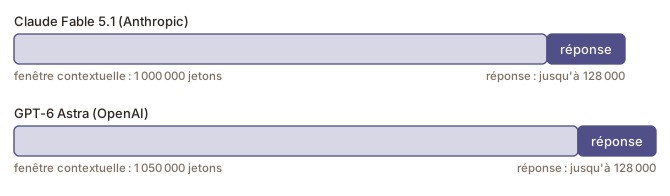
Figure 3. The answer's share of the context window for two models, drawn to scale. Figure 3. La part de la réponse dans la fenêtre contextuelle de deux modèles, à l'échelle.
Page 2Page 2
Figure 4. Context windows as published for BERT (Devlin et al., 2019), GPT-3 (Brown et al., 2020), Llama 3.1 (Grattafiori et al., 2024), and Claude Fable 5.1 and GPT-6 Astra, the frontier models of 2026 (Anthropic and OpenAI model pages, read 14 September 2026). Figure 4. Fenêtres contextuelles publiées pour BERT (Devlin et al., 2019), GPT-3 (Brown et al., 2020), Llama 3.1 (Grattafiori et al., 2024), ainsi que pour Claude Fable 5.1 et GPT-6 Astra, les modèles de pointe de 2026 (pages des modèles d'Anthropic et d'OpenAI, consultées le 14 septembre 2026).
Page 3Page 3
LLMs are non-deterministicLes GML ne sont pas déterministes
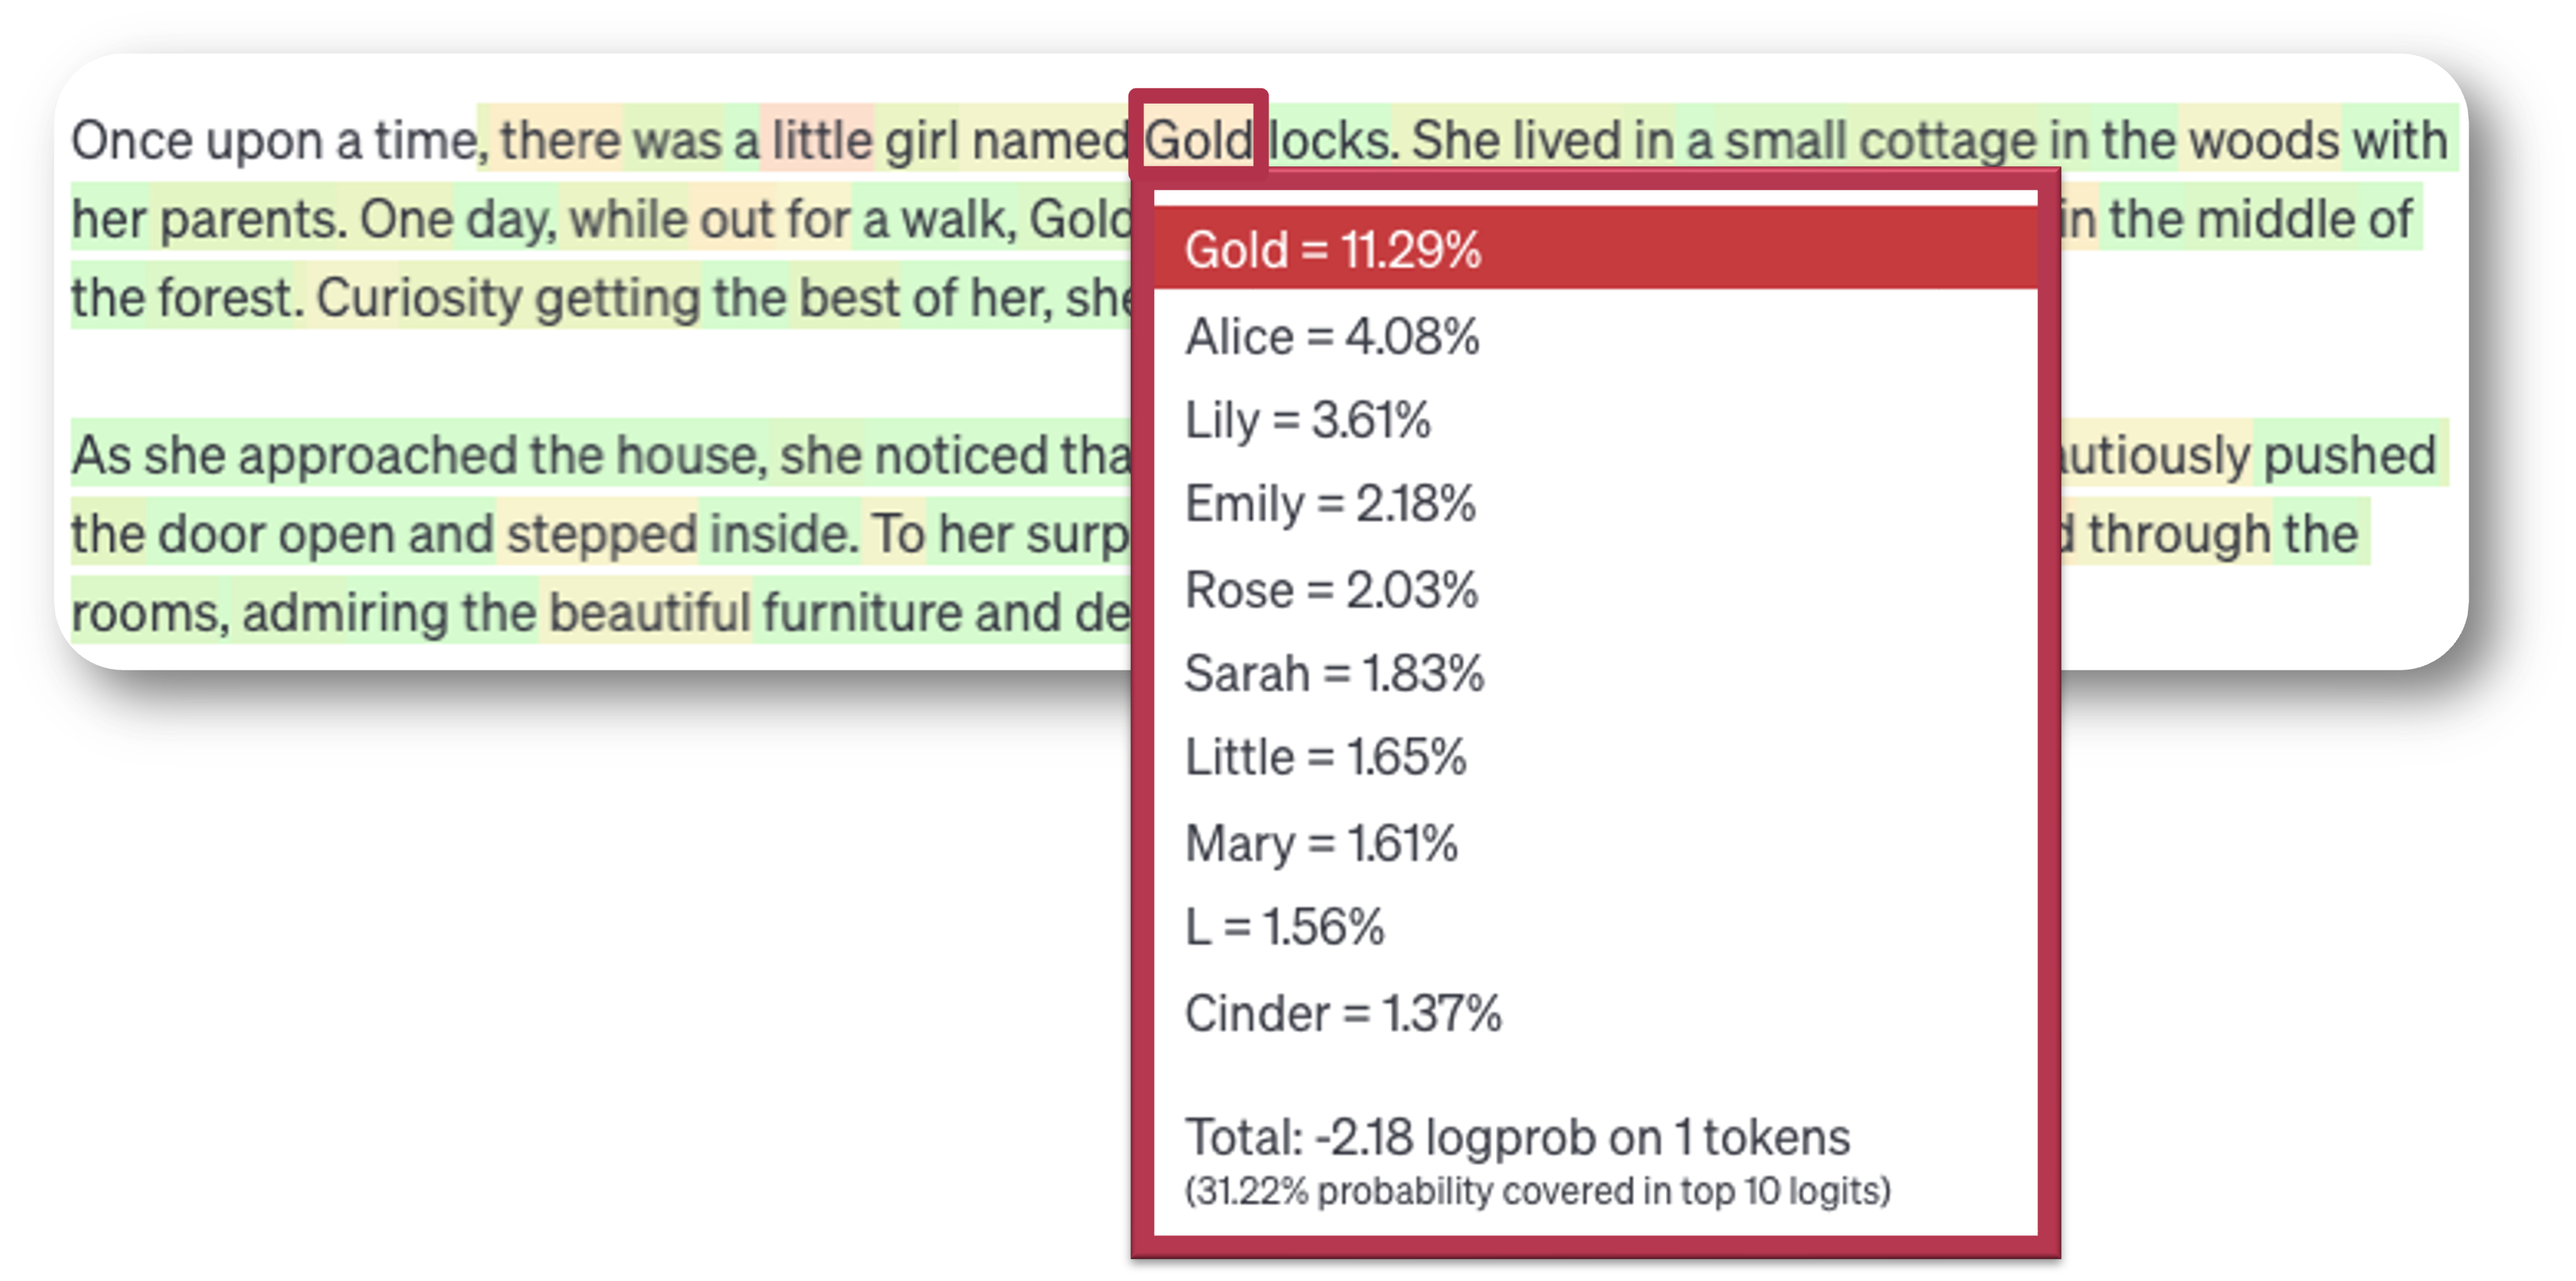
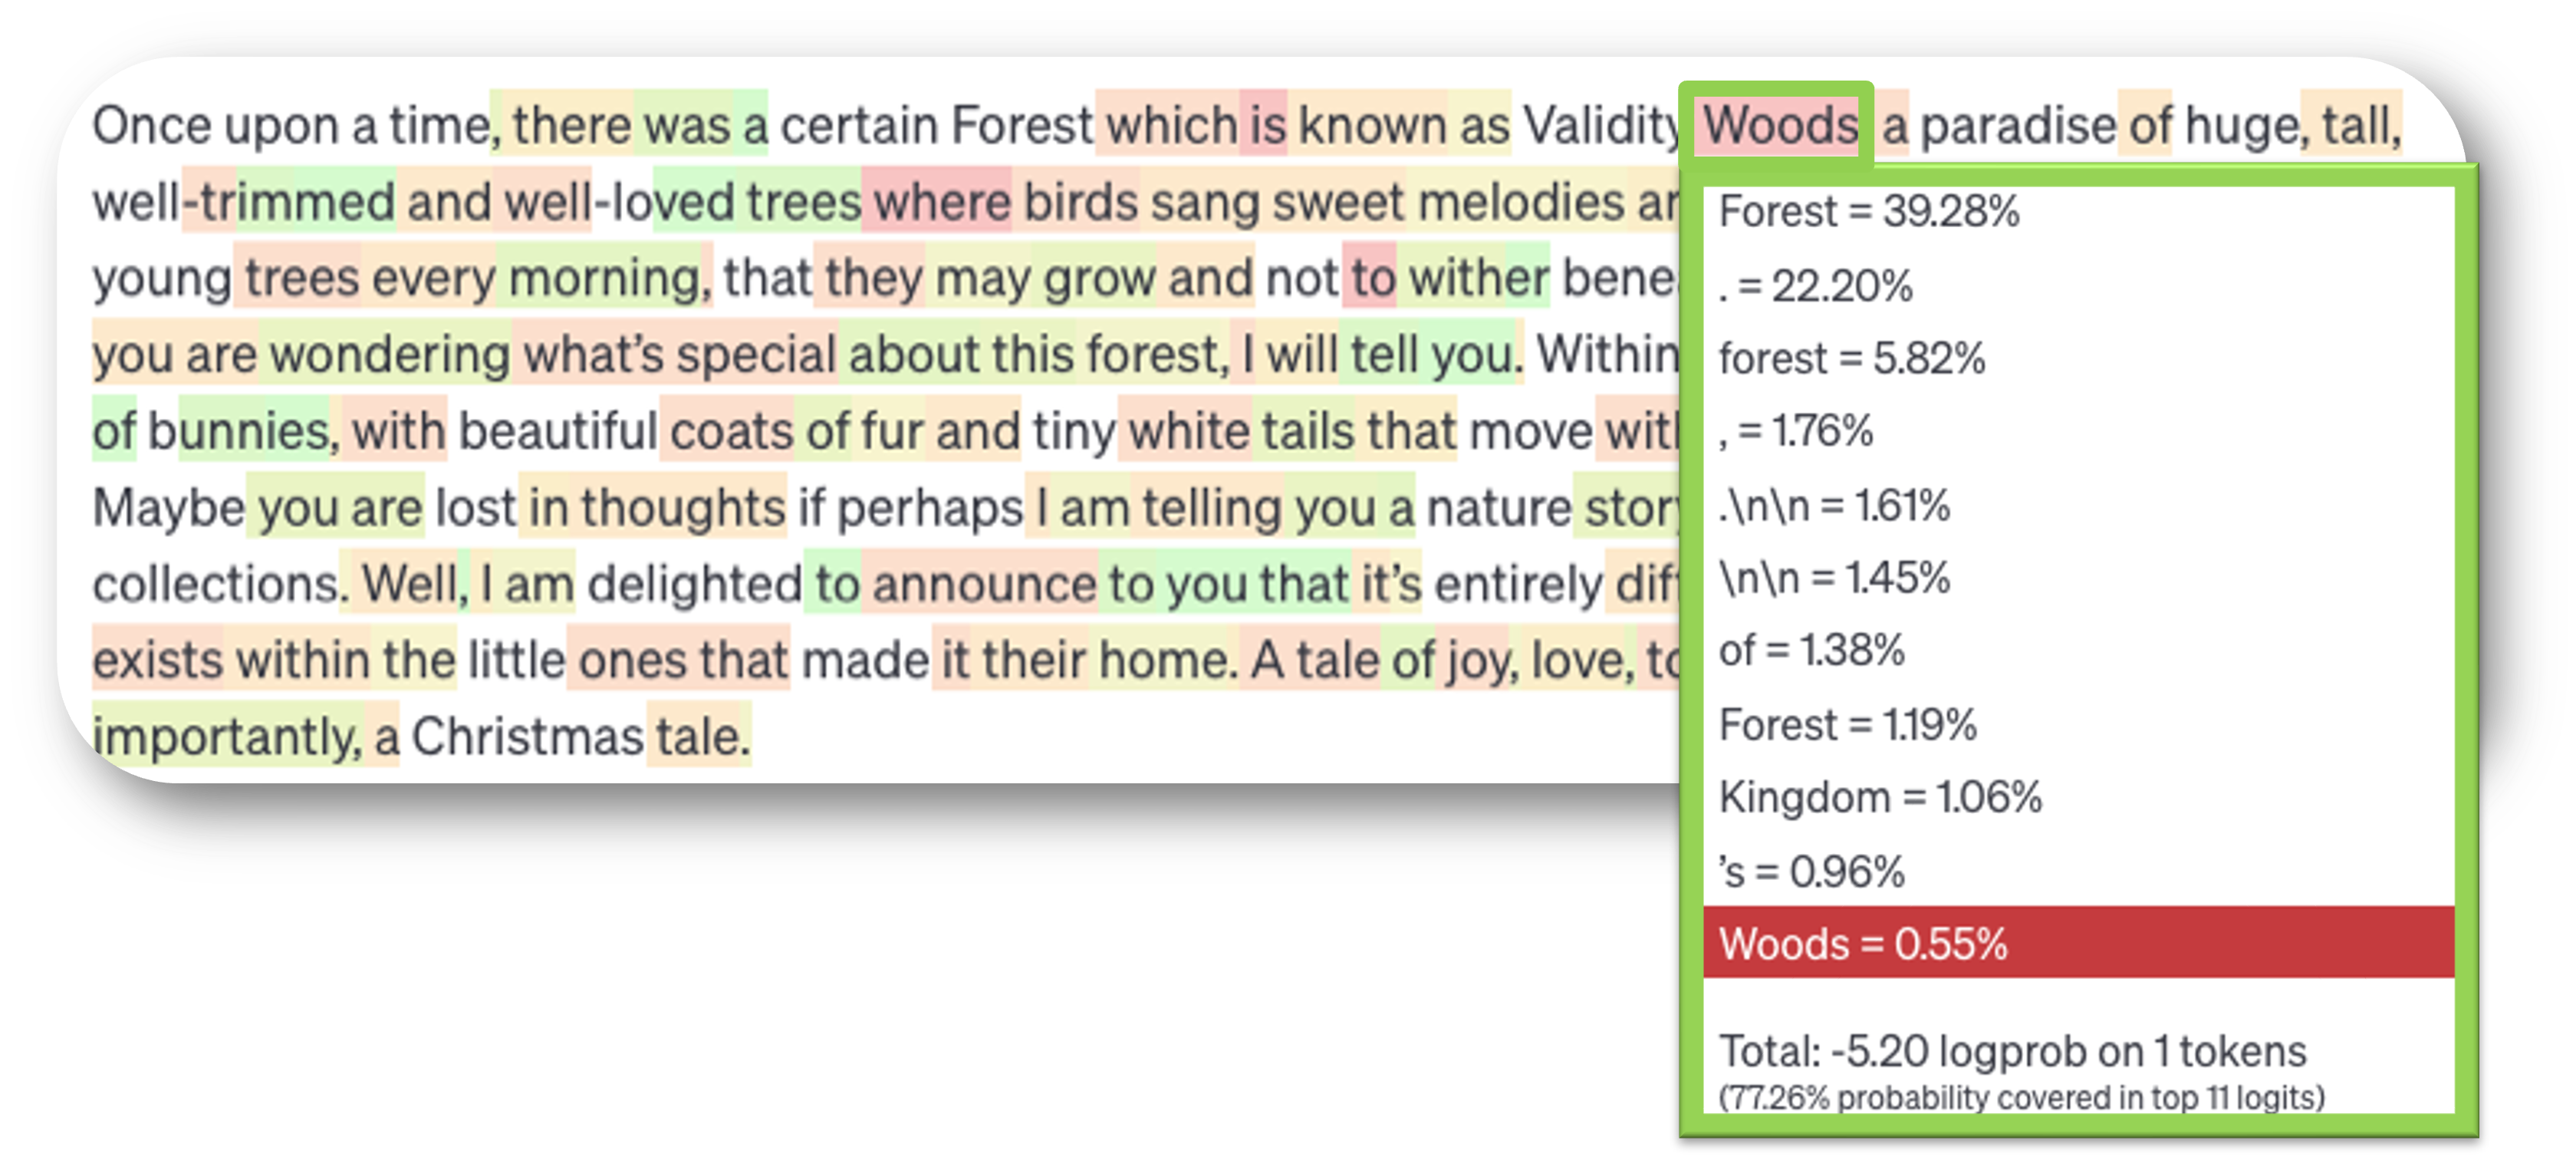
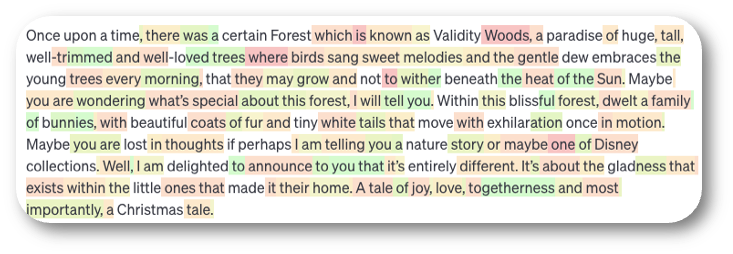
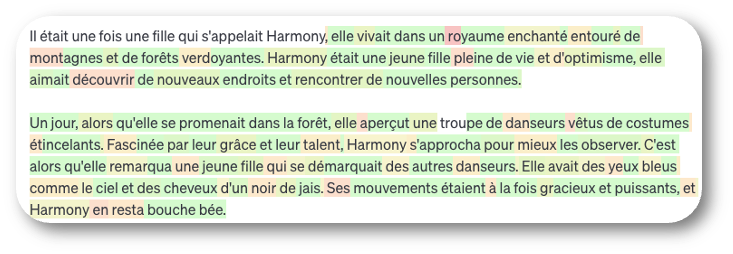
A model computes a probability for every token it knows, and a separate step then picks one of them, usually with an element of chance.
Because of that element of chance, chatbots are not : the same question can get different answers, so a single answer tells you little about a model.
Un modèle calcule une probabilité pour chaque jeton qu'il connaît, puis une étape distincte en choisit un, généralement avec une part de hasard.
En raison de cette part de hasard, les agents conversationnels ne sont pas : une même question peut obtenir des réponses différentes, si bien qu'une seule réponse en dit peu sur un modèle.
deterministic · fr: déterministe déterministe · en : deterministic computinginformatique : Describes a process, algorithm, or system that, under the same initial conditions and with the same input, always produces the same output.Se dit d'un processus, d'un algorithme ou d'un système qui, dans les mêmes conditions initiales et avec la même entrée, produit toujours la même sortie.
Page 3Page 3
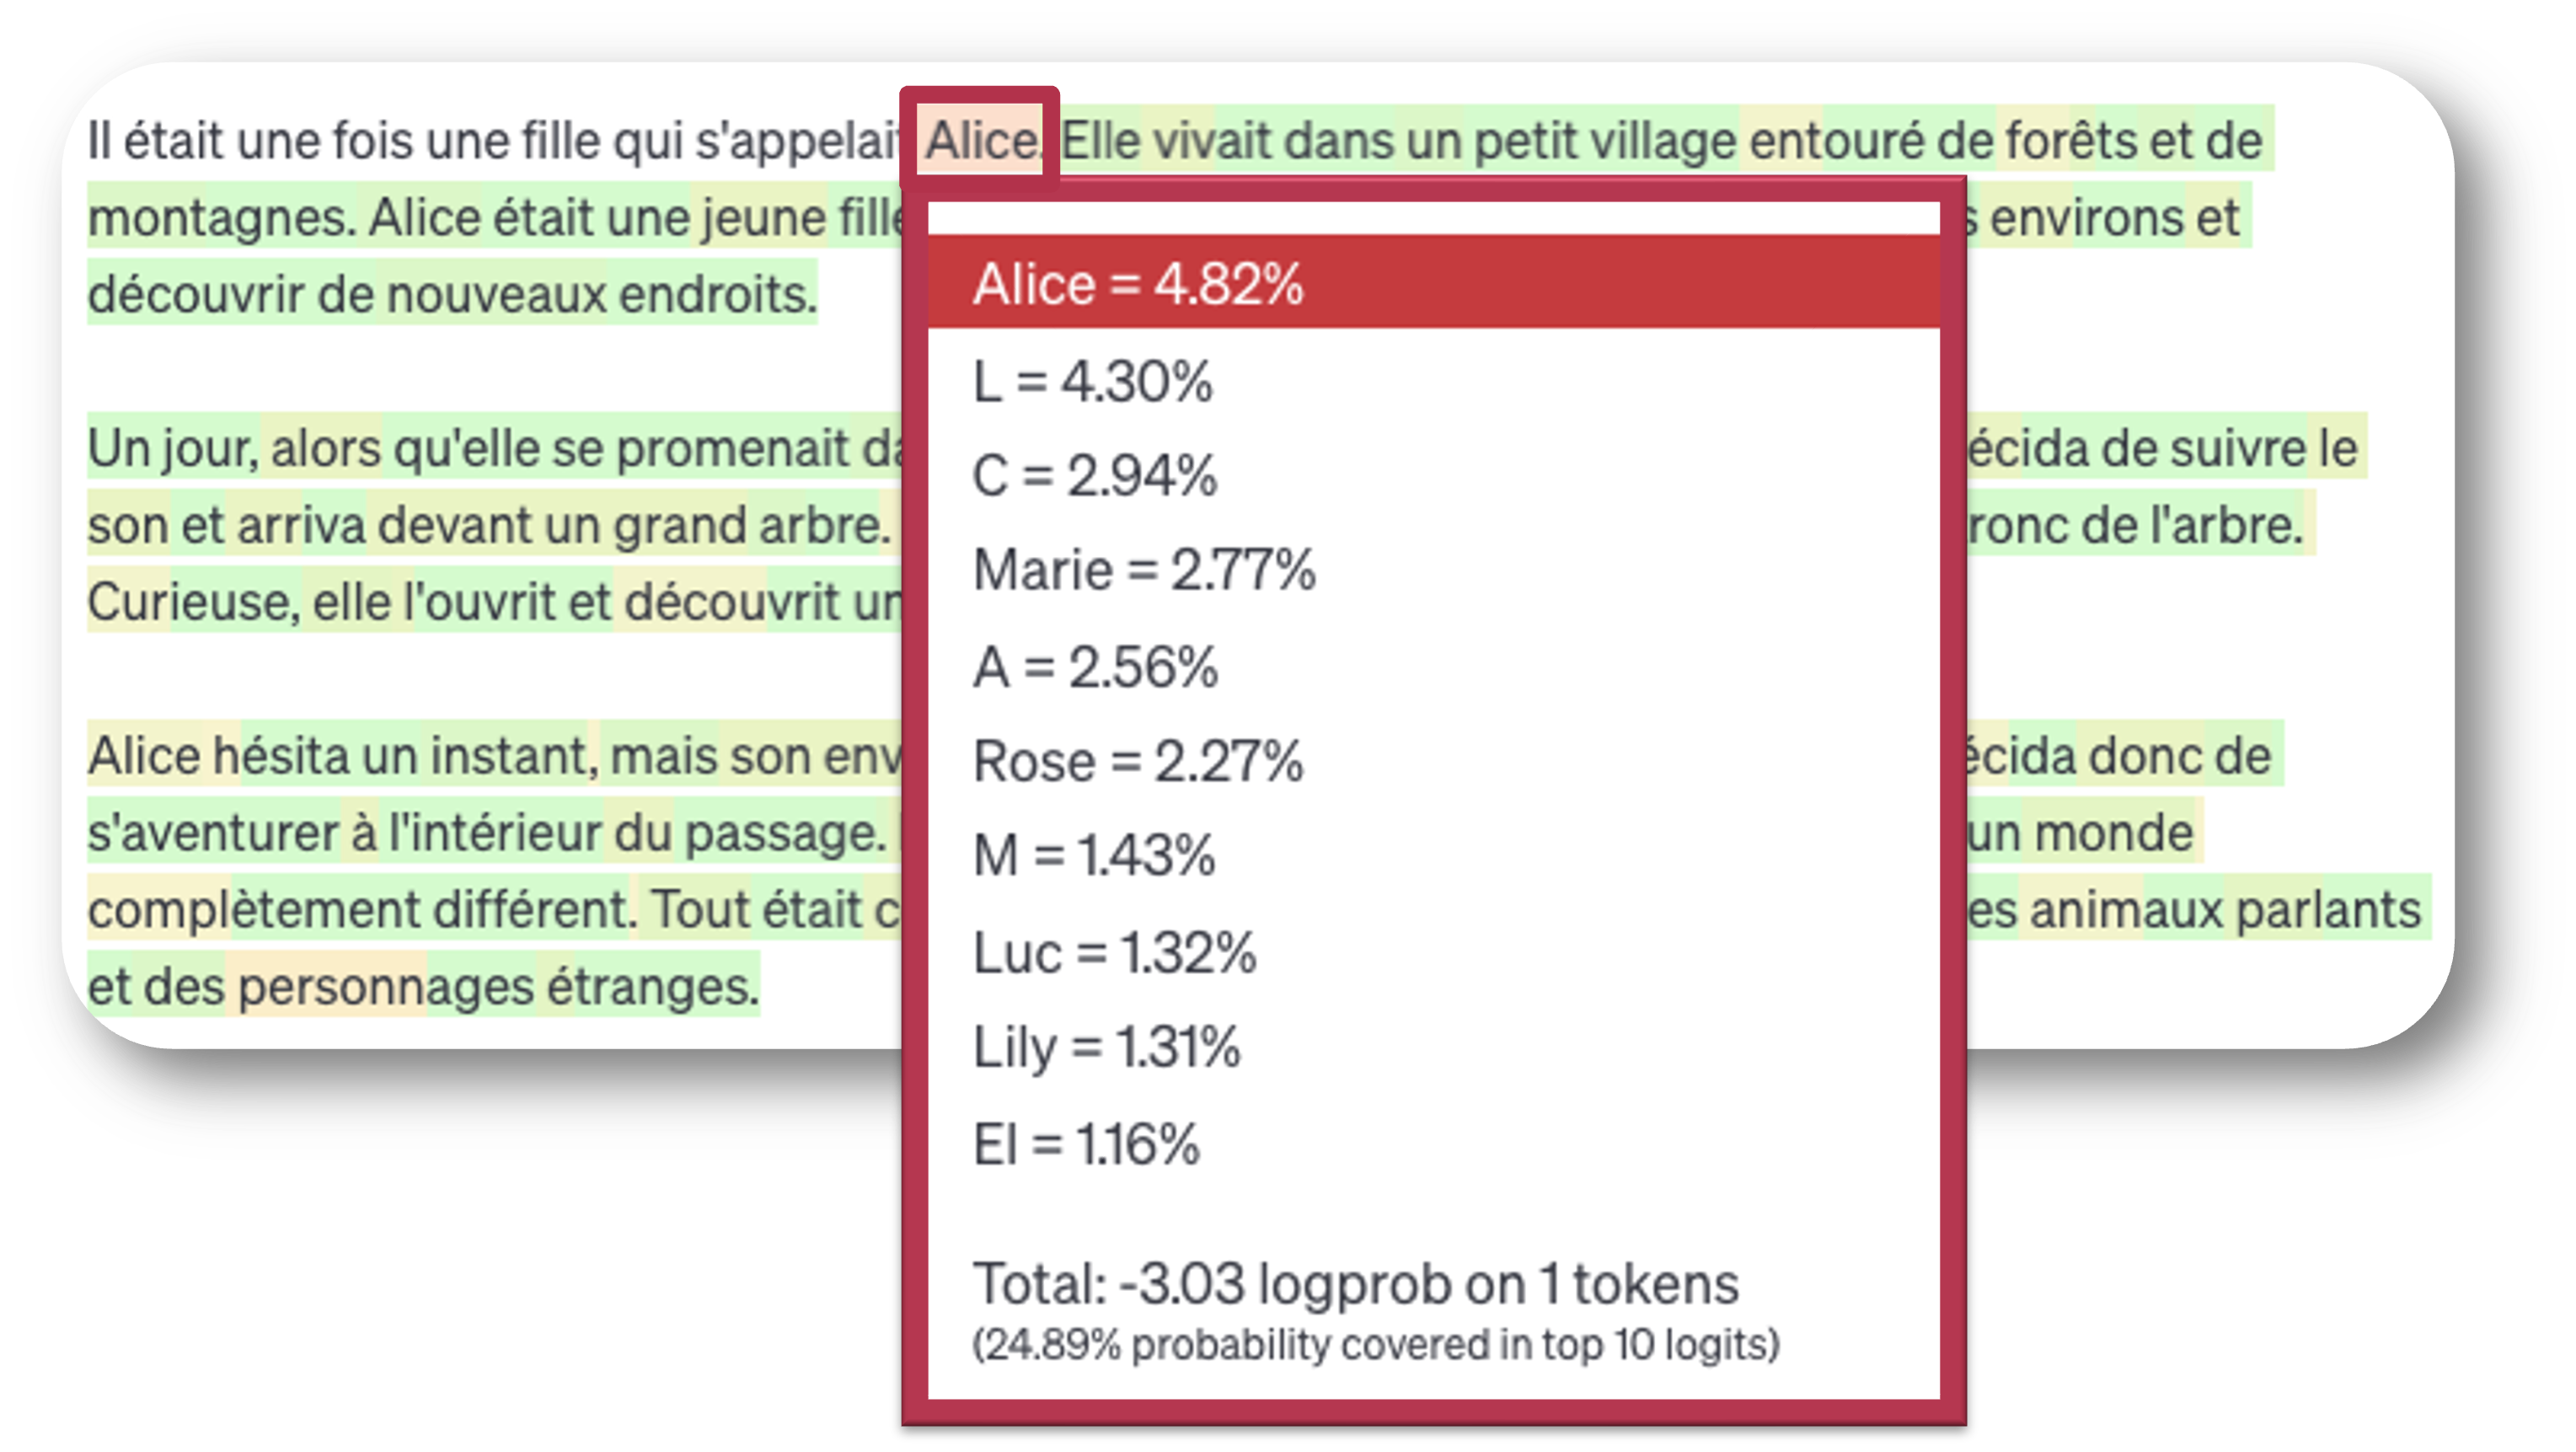
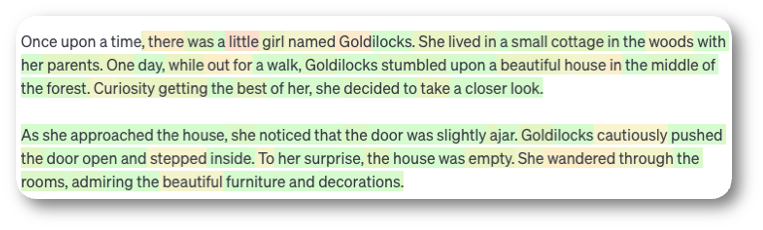
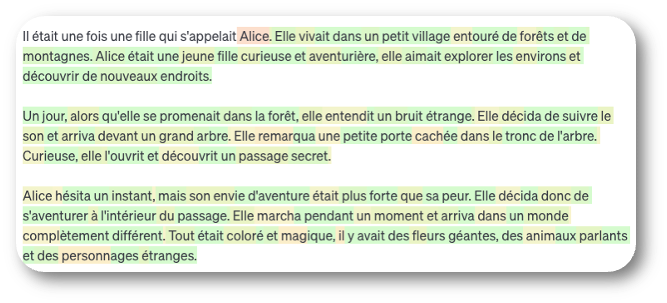
Figure 5. Without an element of chance: the most probable token, Gold, is taken. Figure 7. Sans part de hasard : le jeton le plus probable, Alice, est retenu.
Page 3Page 3
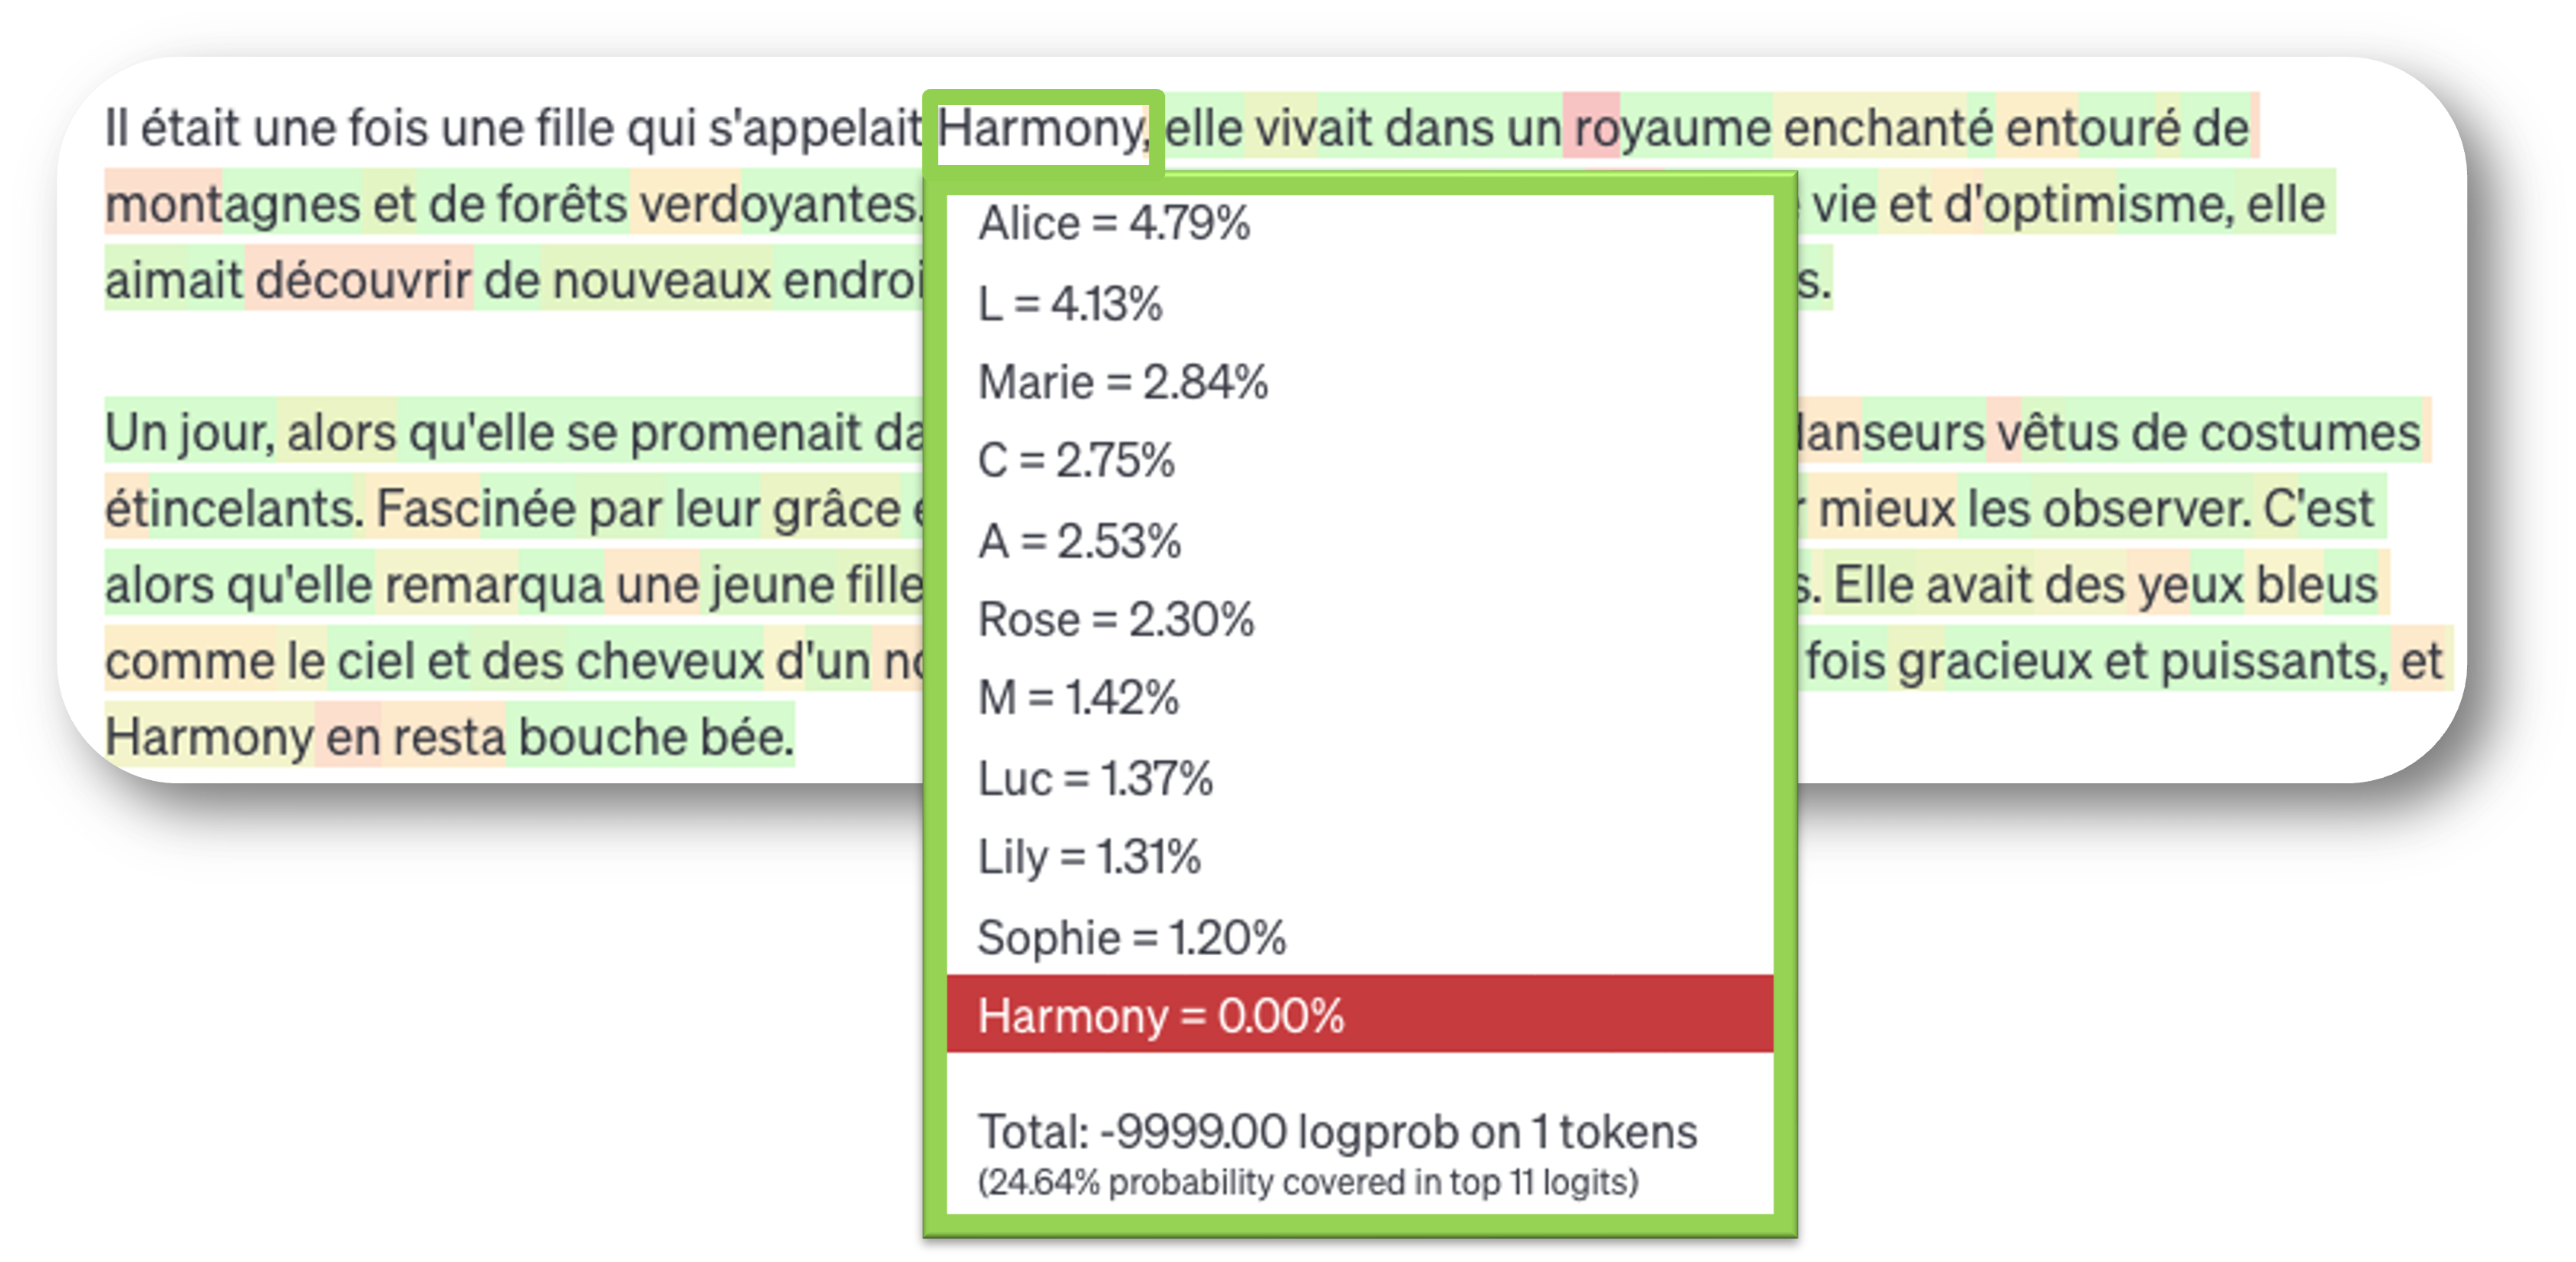
Figure 6. With sampling: a token with a probability of 0.55%, Woods, is taken. Figure 8. Avec échantillonnage : un jeton très peu probable, Harmony, est retenu.
Page 4Page 4
Temperature, top-p and top-kTempérature, top-p et top-k
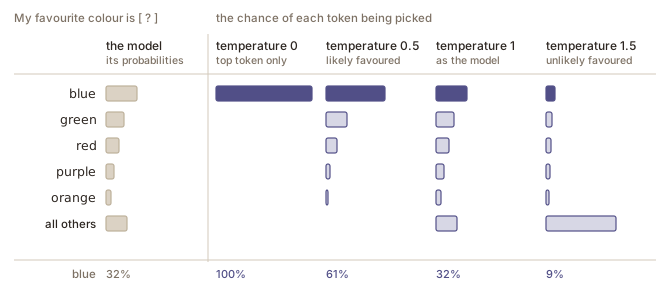
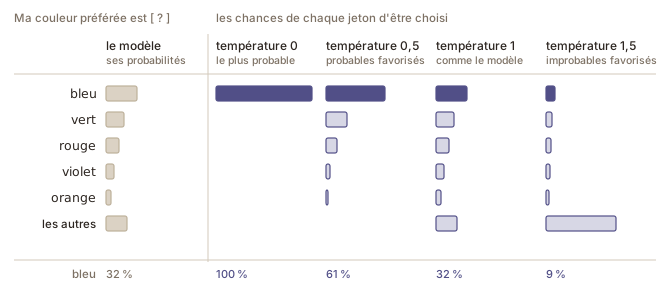
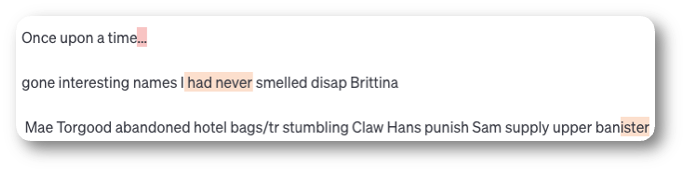
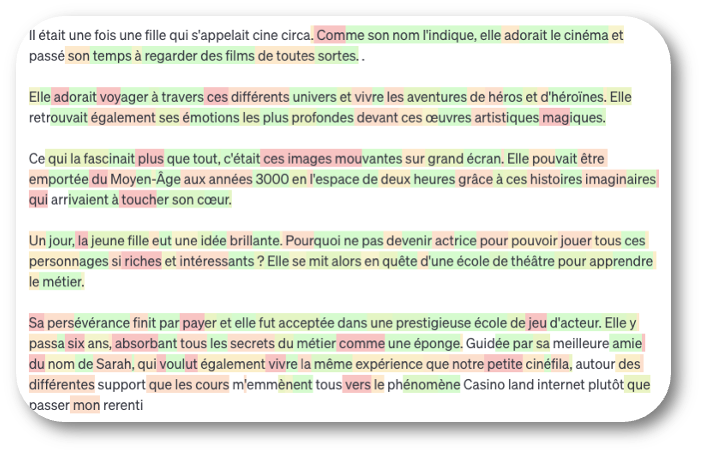
One setting changes the chance each token has of being picked; two others limit the list of tokens that can be picked.
Chat interfaces generally do not show these settings, and on their newest models providers are withdrawing them from their APIs too; the model still picks tokens with an element of chance.
Un réglage modifie les chances qu'a chaque jeton d'être choisi ; deux autres limitent la liste des jetons qui peuvent être choisis.
Les interfaces conversationnelles n'affichent généralement pas ces réglages, et pour leurs modèles les plus récents, les fournisseurs les retirent aussi de leurs API ; le modèle choisit toujours ses jetons avec une part de hasard.
Page 4Page 4
Figure 9. Illustrative probabilities for the next token, and the chance of each token being picked at four temperatures. Figure 9. Probabilités données à titre d'exemple pour le jeton suivant, et chances de chaque jeton d'être choisi à quatre températures.
Page 4Page 4
Figure 10. The same beginning at temperature 0. Figure 15. Le même début à une température de 0.
Page 4Page 4
Figure 11. The same beginning at temperature 1. Figure 16. Le même début à une température de 1.
Page 4Page 4
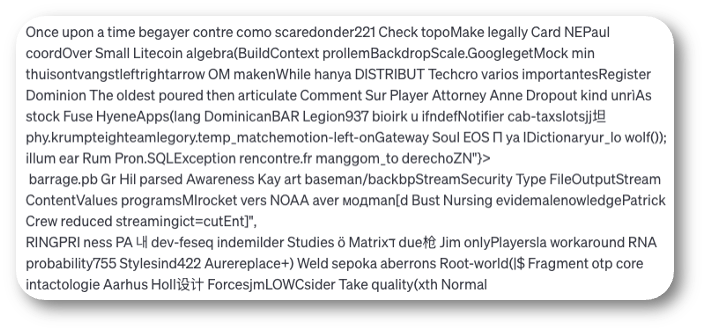
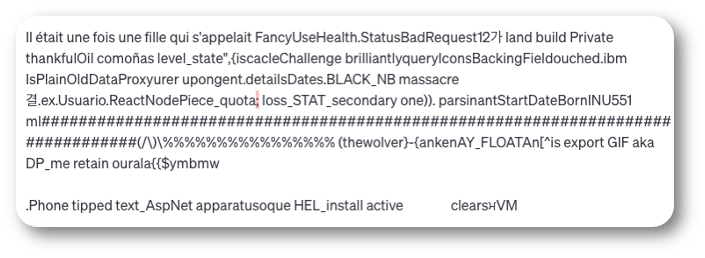
Figure 12. The same beginning at temperature 1.5. Figure 17. Le même début à une température de 1,5.
Page 4Page 4
Figure 13. The same beginning at temperature 2. Figure 18. Le même début à une température de 2.
Page 4Page 4
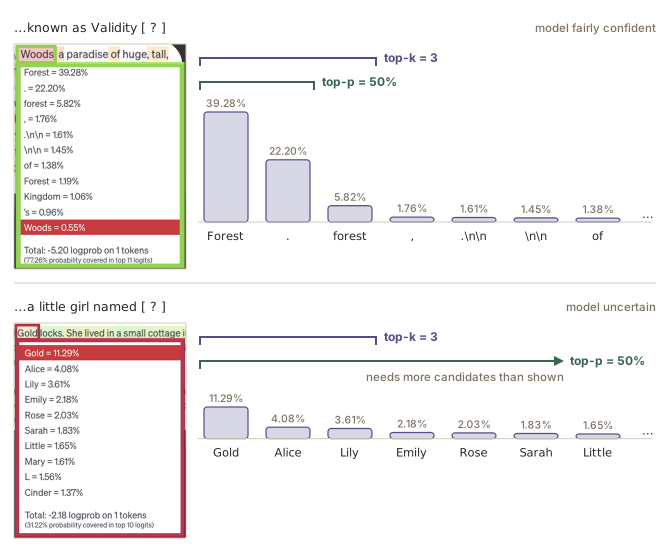
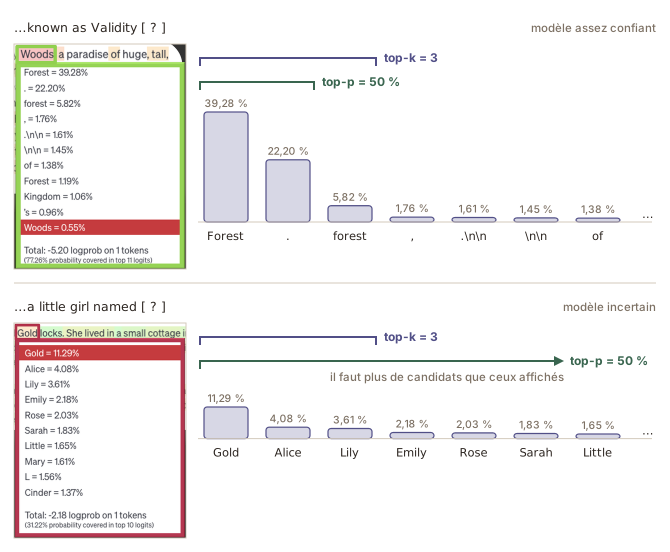
Figure 14. Top-k = 3 and top-p = 50% on two sets of probabilities shown by OpenAI's Playground in 2024, with gpt-3.5-turbo-instruct. The values 3 and 50% are chosen to make the difference visible, not typical settings. Figure 14. Top-k = 3 et top-p = 50 % appliqués à deux ensembles de probabilités affichés par le Playground d'OpenAI en 2024, avec gpt-3.5-turbo-instruct. Les valeurs 3 et 50 % sont choisies pour rendre la différence visible ; ce ne sont pas des réglages habituels.
Page 5Page 5
Errors spread through contextLes erreurs se propagent dans le contexte
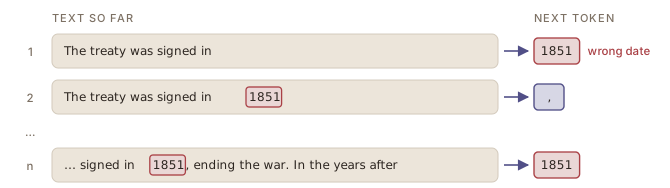
An LLM writes one token at a time and cannot change a token once it is written: every next token is predicted from everything written so far, mistakes included.
A wrong detail early in an answer becomes part of what the rest of the answer is written to agree with.
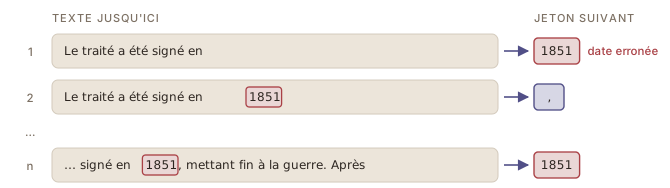
Un GML écrit un jeton à la fois et ne peut plus modifier un jeton une fois écrit : chaque jeton suivant est prédit à partir de tout ce qui a été écrit jusque-là, erreurs comprises.
Un détail erroné au début d'une réponse devient une base avec laquelle le reste de la réponse est rédigé pour s'accorder.
Page 5Page 5
Figure 19. Each step reads everything written so far, including an earlier mistake, which makes it more likely that the mistake is repeated and that the rest of the text builds on it. Figure 19. Chaque étape lit tout ce qui a été écrit jusque-là, y compris une erreur antérieure, ce qui rend plus probable que l'erreur soit répétée et que la suite du texte s'appuie sur elle.
Page 6Page 6
Reasoning step by stepRaisonner étape par étape
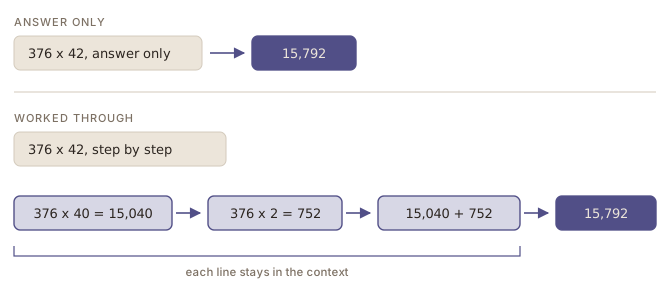
During inference, an LLM only predicts one token at a time. Asked for an answer straight away, it has to do all the work in the prediction of a few tokens; working step by step spreads that work over many tokens, each building on the ones before.
Asking a model to work through its steps helps most where an answer can be calculated or checked by rule, but much less where the judgement is about language.
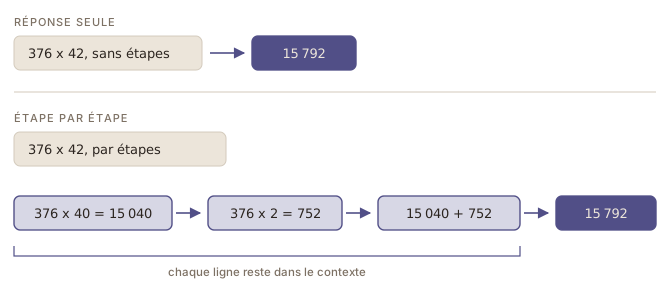
Pendant l'inférence, un GML ne fait que prédire un jeton à la fois. S'il doit répondre directement, tout le travail doit se faire dans la prédiction de quelques jetons ; résoudre le problème étape par étape répartit ce travail sur de nombreux jetons, chacun s'appuyant sur les précédents.
Demander à un modèle de détailler les étapes aide surtout quand la réponse peut être calculée ou vérifiée selon une règle, mais beaucoup moins quand il s'agit de juger la langue.
Page 6Page 6
Figure 20. The same multiplication, answered directly and step by step. Figure 20. La même multiplication, avec une réponse directe et étape par étape.
The page behind this slideLa page derrière cette diapositive
1 / 28The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter