Numbers that say how words relate. So far cat is exactly as far from
dog as it is from democracy.
A representation that stays manageable and still says something.
Giving every word its own slot takes tens of thousands of numbers to say one
thing, and all but one of them are zero.
A representation that can change with the sentence.Bank does not mean
the same thing in every sentence it appears in, and one fixed set of numbers
per word cannot follow that.
Suppose you want to place words in a two-dimensional space. You give the
horizontal axis one meaning and the vertical axis another, then put each word
where it belongs relative to those two meanings. Every word ends up with
coordinates, which is to say a vectorvectorvecteurmachine learningapprentissage automatiqueAn ordered list of numbers.Liste ordonnée de nombres.: here a list of
two numbers, one per axis. Those numbers do more than locate the word. They say
how it stands on each of the two meanings, and how far it is from every other
word in the same space.
Speed and capacity
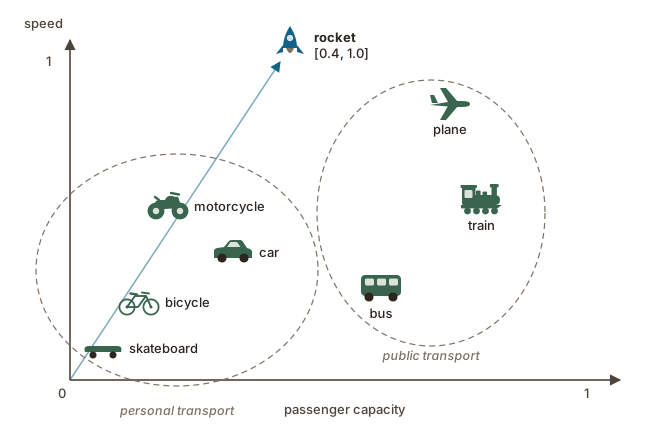
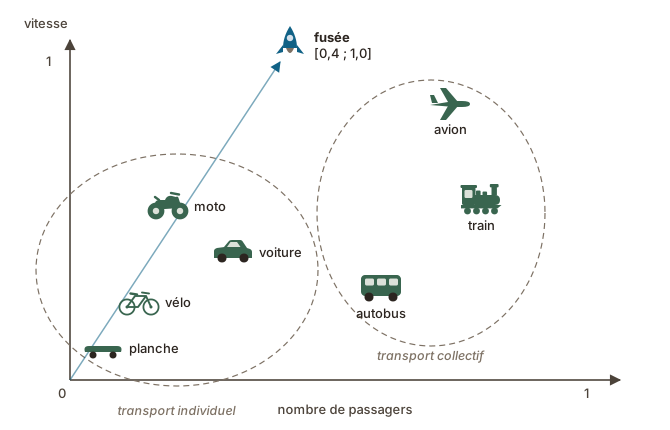
Figure 1. Two hand-picked dimensions, passenger capacity and speed. Every vehicle gets a vector, and groups form that nobody drew.
The idea is worked out for means of transport in
Figure 1figure 1.
The horizontal axis is passenger capacity and the vertical axis is speed, and
most people would agree on roughly where each vehicle goes. A skateboard scores
low on both: it does not travel fast and it carries one person. A rocket has
maximal speed and more moderate capacity, giving it the vector [0.4, 1.0]. Where
a one-hot vector only identified a word, that pair of numbers says something
about the thing named, and it fixes how far the rocket stands from every other
vehicle in the space.
Placing words this way also makes groups form on their own. Personal transport
gathers on the left, public transport on the right, and the rocket sits apart,
which is where it belongs. Nobody drew those groups; they follow from the
coordinates.
Where the apple goes
So far this looks like a promising way to turn words into lists of numbers that
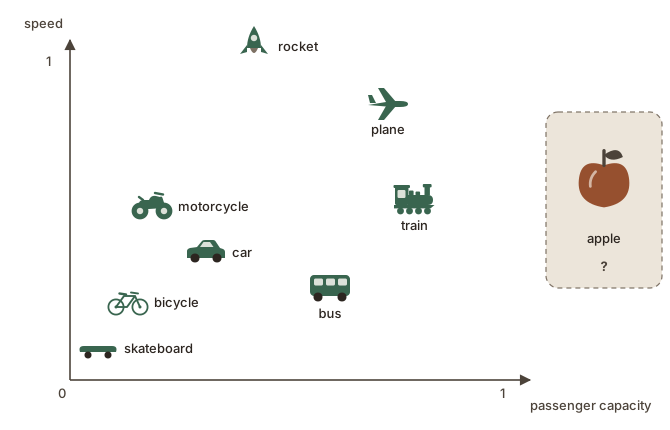
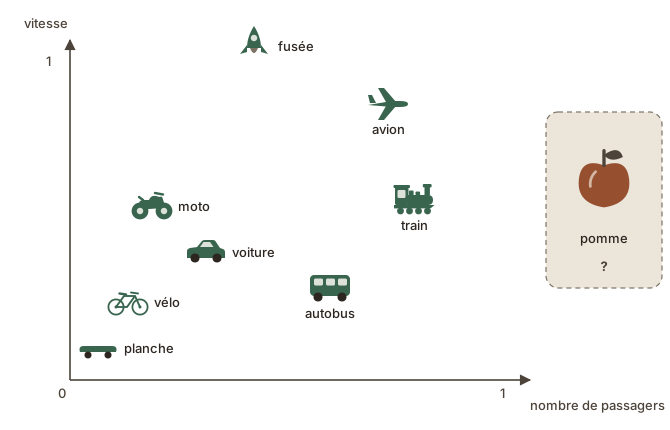
mean something. Then: where would you put an apple in this space? The
question makes no sense, because speed and capacity say nothing about an apple.
Figure 2. The same two axes, and an apple that neither of them measures.
Two things follow. A space that fits a whole vocabulary needs many more than
two dimensions, since it has to suit everything from skateboard to ardour.
And once there are hundreds of dimensions and tens of thousands of words,
neither the axes nor the positions can be chosen by a person.
Which leaves the question: how can numbers like these be found automatically,
for every word in a vocabulary?
Dimensions with meaning
Build the transport space with the room before showing it: speed on one
axis, capacity on the other, then ask where a skateboard, a bus and a
rocket go. The apple is the screen after it, and the question that kills
the hand-made version.
The company a word keeps
Five blanks
have a ___ as pet
pet the ___ of the
and the ___ purrs loudly
walk your ___ on a leash
does the ___ love music
Five blanks
Suppose you are given five fragments of text, each with one word missing:
have a ___ as pet
pet the ___ of the
and the ___ purrs loudly
walk your ___ on a leash
does the ___ love music
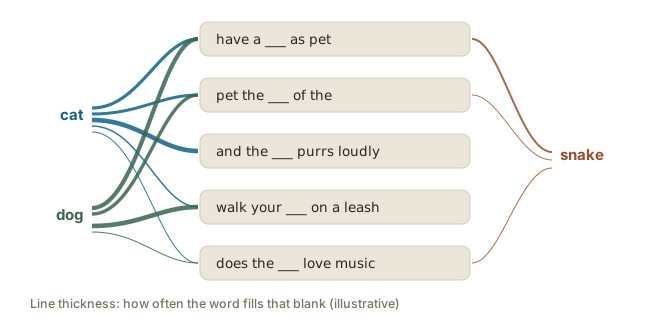
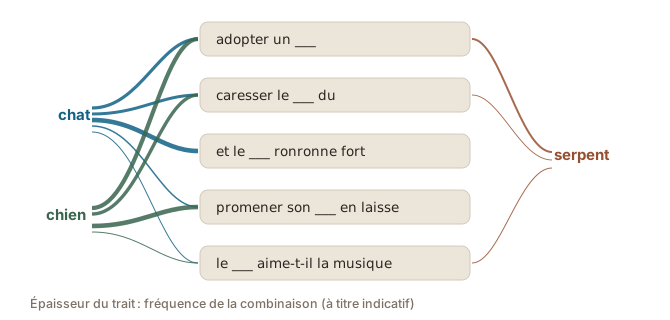
Which words could fill the blank? Cat goes into the first three without any
trouble; the leash makes you hesitate. Dog goes into the pet, the petting and
the leash, and fails at the purring. The last fragment takes any of them, which
is why it tells you so little. So the two words share most of their contexts,
and the ones they do not share are exactly the ones you would expect: a cat
purrs, a dog is walked.
Now try snake. It fits have a ___ as pet, and after that it gets harder: a
snake does not purr, and a snake on a leash is a very big stretch. Snake
shares one or two contexts with cat and dog and not the rest. A word like
democracy fits none of the five.
Not only whether a word can fill a blank counts, but how often it does.
Cat turns up before purrs far more often than after walk your, and a
system that counts contexts in a large collection of text sees that difference
directly.
Figure 3. Similar words fill similar blanks, and how often they do is the part that counts. Cat and dog share most of their contexts; snake shares far fewer.
What the blanks show
Words with related meanings turn up in similar contexts, and the more two
words’ contexts overlap, the closer their meanings tend to be. Linguists
formulated this in the 1950s, Joos, Harris and Firth among them (Jurafsky &
Martin, 2026), and Firth put it in one sentence: “You shall know a word by the
company it keeps” (Firth, 1957).
Why this suits a machine
The idea is useful for a machine because of what it does not require:
No definitions. Nobody has to say what cat means.
No labels. Nobody has to mark examples by hand.
No hand-picked axes. Nobody chooses the dimensions of the space, or where
each word goes on them.
It does require text, in quantity. Contexts are observable: any large
collection of text shows directly which words surround which. So a system can
build a workable stand-in for meaning just by reading enough text.
The company a word keeps
Run the five blanks out loud and let the room fill them, one word at a time:
cat, then dog, then snake, then democracy. Then the figure, then the Firth
sentence.
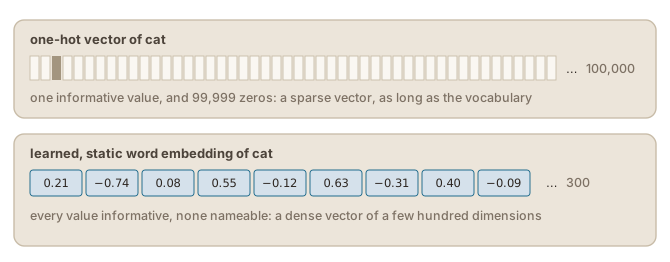
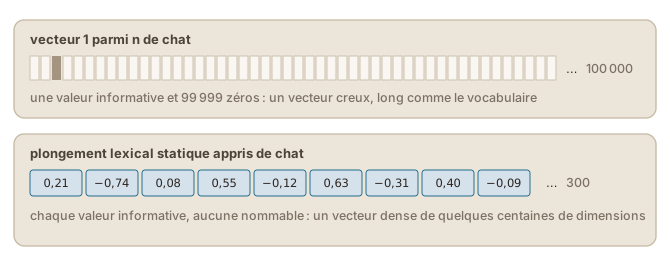
Every property of these vectors contrasts with the one-hot representation:
Short instead of vocabulary-sized. Typically 100 to 300 dimensions rather
than one per word.
Dense instead of sparse. Every position has a meaningful value rather
than a zero.
Distance means something.Cat and dog end up close, snake farther,
democracy elsewhere entirely, because their contexts imposed it
during training.
Figure 4. The same word in the two representations. The learned vector is short and dense, and no single one of its values can be read on its own.
No readable axes
The example with our means of transport showed axes that were interpretable:
speed and capacity. The learned dimensions are not. They do not correspond to
any nameable property, and looking at one value tells you nothing. In this
representation a word’s meaning is the whole pattern of all its values
together, and only comparisons between whole vectors are meaningful.
Embeddings learned from text
Embeddings learned from text
The habit to break: no single dimension stands for anything nameable. Only
whole vectors compare. Say it explicitly, because the transport figure has
just taught the opposite.
Take the vector for king, subtract the vector for man, and add the vector
for woman. The point you land on is nearest the word queen (Mikolov et al.,
2013b). Nothing in the training aimed at this. It falls out of the geometry:
the displacement from man to king encodes something like royalty, and
applying that same displacement to woman arrives near queen.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. Subtracting man from king leaves the crown, and adding woman to the crown arrives at queen.
One direction among many
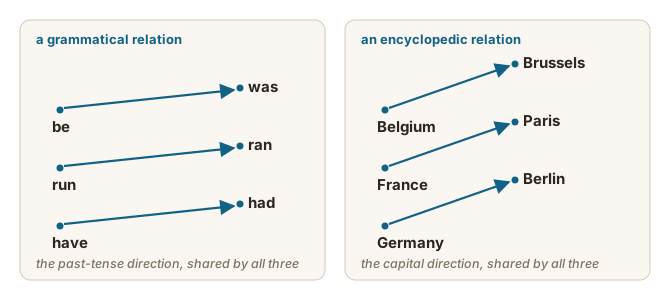
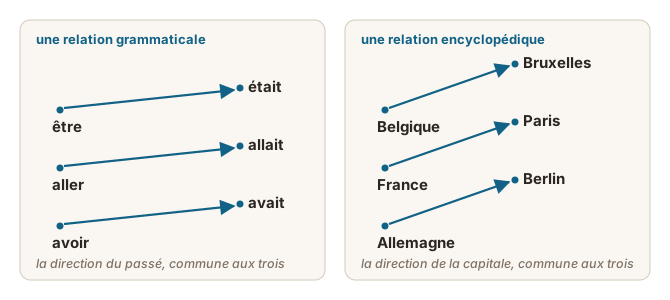
The royalty direction is one of many. Mikolov et al. (2013b) tested the pattern
systematically on grammatical relations, a thousand questions each for
comparatives (good is to better as rough is to rougher), plurals (year
is to years) and verb tense (see is to saw as return is to returned),
and found it there too. Encyclopedic relations behave the
same way, a country and its capital among them (Jurafsky & Martin, 2026). The
axes are still unreadable. The meaning is in the directions between whole
vectors, and those can be looked for after the fact.
Figure 6. A grammatical relation and an encyclopedic one, each a direction that every pair shares.
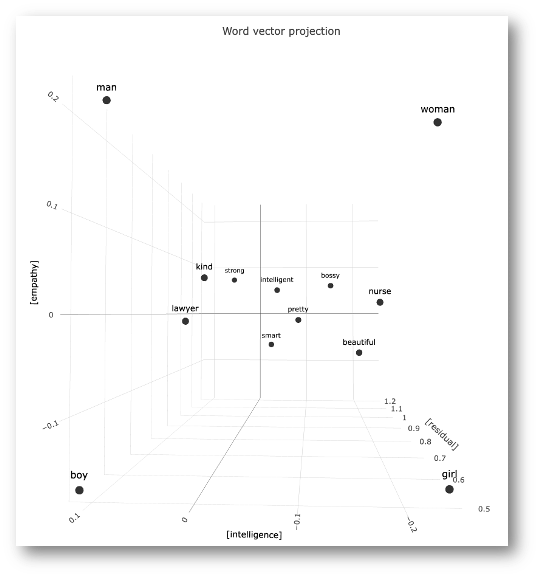
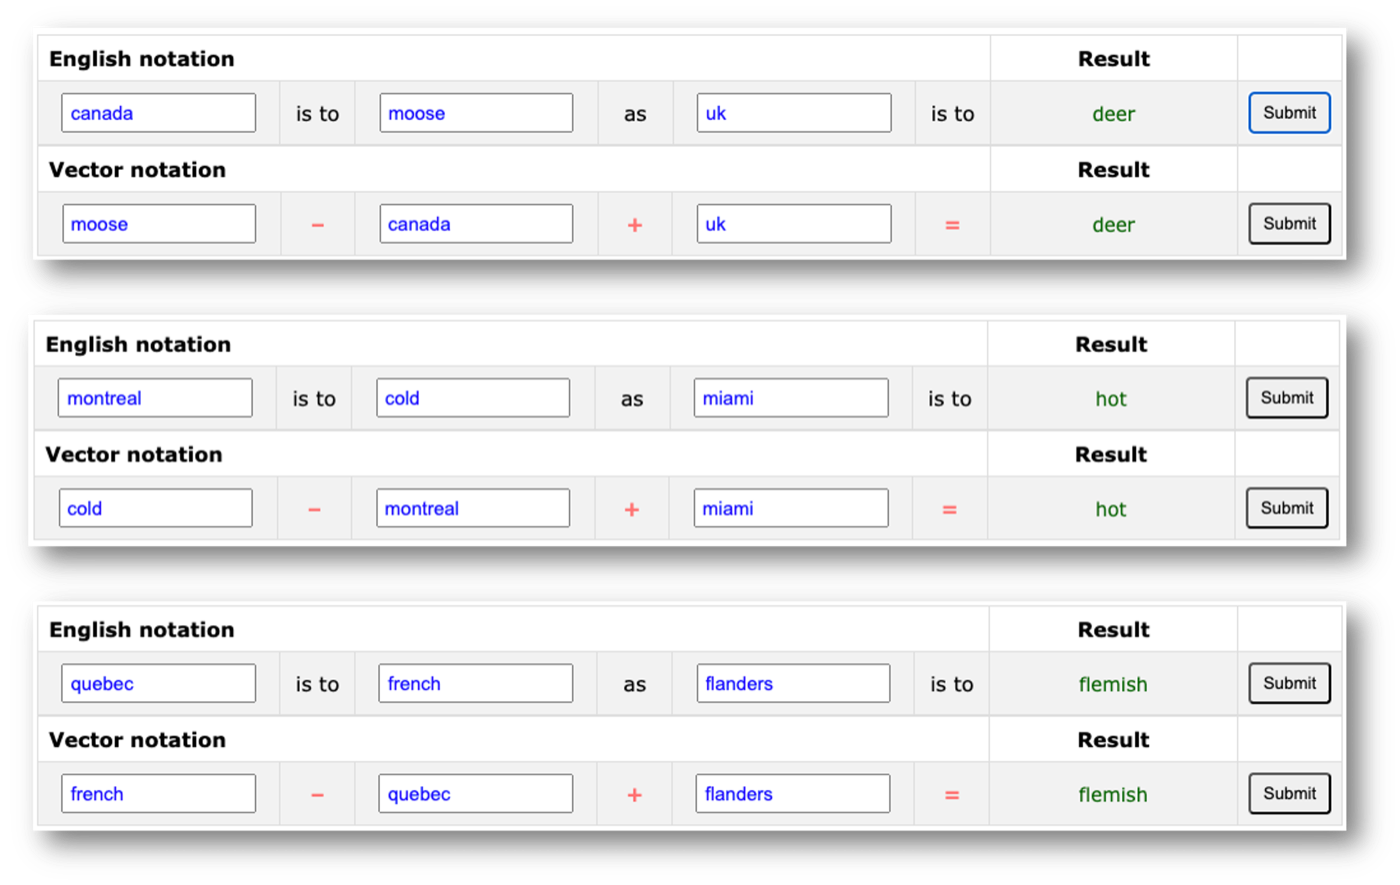
Carnegie Mellon’s browser demo does exactly that. The three screenshots below
were taken from it on 9 September 2026, and the demo can change. They are dense, and
a click opens each one larger.
Figure 7. The space projected onto two directions named by words: intelligence and empathy. The axes were chosen after training, not built into it. Figure 8. Three analogies on the demo's word2vec vectors. Canada is to moose as UK is to deer, Montreal is to cold as Miami is to hot, Quebec is to French as Flanders is to Flemish. Each analogy is typed in words above and as vector arithmetic below, and the two forms return the same word.
The same arithmetic on stereotypes
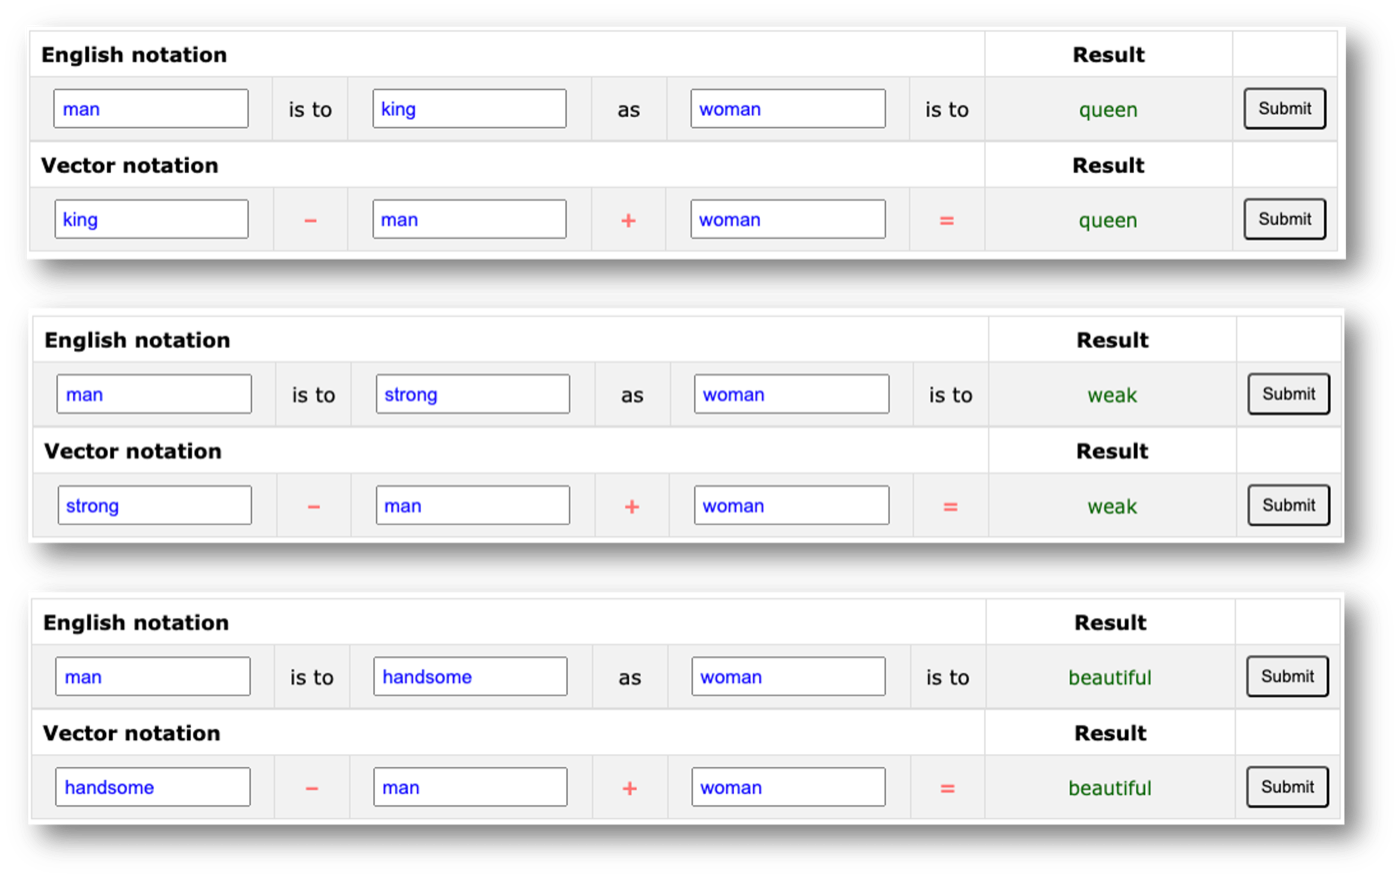
The arithmetic works on stereotypes too. In embeddings trained on Google News
articles, man is to computer programmer as woman is to homemaker, and
occupation words divide along a gender direction the same way king and
queen divide along a royalty one (Bolukbasi et al., 2016).
Figure 9. The same demo, on the same word2vec vectors. Man is to king as woman is to queen, the textbook analogy. Then man is to strong as woman is to weak, and man is to handsome as woman is to beautiful.
No programmer decided to put woman further from doctor and closer to
nurse. The bias comes from the text: the vectors record how the words are
used across millions of sentences, and people wrote those sentences. The method
is working as designed. The consequences reach everything built on embeddings
since (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
Arithmetic with meanings
Arithmetic with meanings
Try it live
cs.cmu.edu/~dst/WordEmbeddingDemo/, on real word2vec and GloVe vectors
king − man + woman, then an analogy from the room’s working languages
an occupation analogy, before the Bolukbasi result
The CMU demo runs in a browser on word2vec and GloVe: try king − man +
woman live, then take an analogy from the room’s working languages. Ask
for an occupation analogy before showing the Bolukbasi result, so the bias
arrives as something the room produced rather than as a warning.
Three limitations
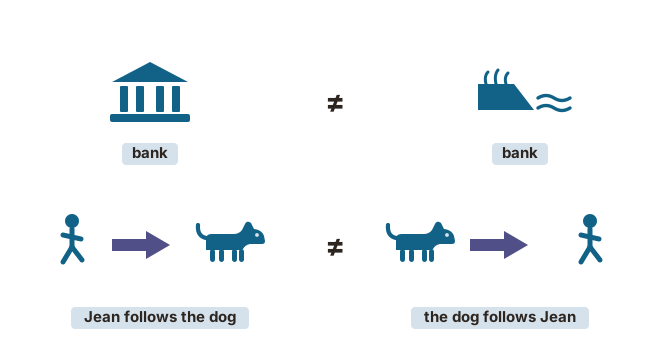
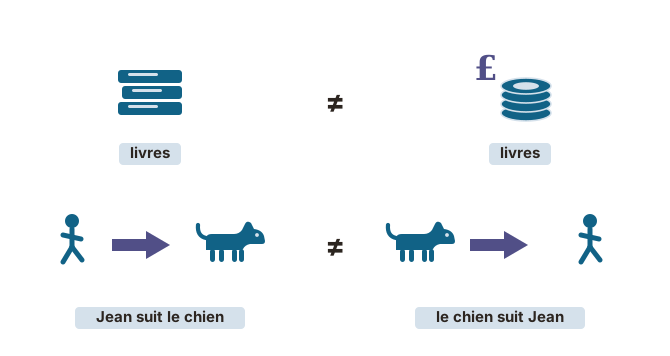
Figure 10. One form carrying two senses, and one set of words in two orders. A fixed vector per word can tell neither pair apart.
New words get nothing
An embedding model has one vector for each word that occurred in its training text, so a word
coined last year, a rare technical term or a typo has no vector and no
representation at all. Morphologically rich languages make this worse, since
their productive compounds and inflections produce forms no training corpus
contains. Modern systems dissolve the problem by working with pieces of words
instead (see also the Tokenization chapter) (voir aussi le chapitre Jetonisation).
One vector averages every sense
Bank is a financial institution in I deposited money at the bank and a
strip of riverside in we picnicked on the river bank. A single vector for
bank has to serve both sentences, so it lands somewhere between finance and
geography, a compromise that is wrong everywhere. It is not even a fair
compromise: the vector is an average over occurrences, so it sits nearest
whichever sense is commonest in the training text, and the rarer sense is
served worst. Translation feels this early, since choosing between rive and
banque is exactly a decision about which sense is active.
Order is invisible
The dog follows Jean and Jean follows the dog contain the same words and do
not describe the same walk, so any representation built by combining fixed
word vectors struggles to tell them apart. Meaning depends on arrangement, and
per-word vectors have nowhere to put arrangement.
The limits of static vectors
Three issues, one cause
New words get no vector at all
One vector averages every sense: rive or banque?
Order is invisible: same words, different walk
The vector is computed once and frozen, before the word is ever used in
a sentence.
Ce que les deux chapitres précédents ont établi
L’idée
Ce qu’elle apporte
Ce qu’elle coûte
Un nombre par mot, par ordre alphabétique
Un identifiant
Un ordre et une arithmétique qui ne veulent rien dire
Des coordonnées dans un espace, donc des distances
Rien encore : l’espace reste à construire
Un vecteur 1 parmi n
Une identité sans faux ordre
Toutes les paires à égale distance ; 99 999 zéros par mot
Ce qui manque encore
Des nombres qui disent comment les mots se rapportent. Jusqu’ici, chat
est exactement aussi loin de chien que de démocratie.
Une représentation qui reste maniable et qui dit quelque chose. Donner à
chaque mot sa propre case demande des dizaines de milliers de nombres pour
dire une seule chose, et tous sauf un valent zéro.
Une représentation qui peut changer avec la phrase.Livres ne veut pas
dire la même chose dans toutes les phrases où le mot apparaît, et un seul jeu
de nombres fixe par mot ne peut pas suivre.
Ce chapitre répond aux deux premiers points. Le troisième demande un chapitre
à lui seul (see also the Contextual embeddings chapter) (voir aussi le chapitre Plongements contextuels).
Les mots comme coordonnées
Supposons que vous vouliez placer des mots dans un espace à deux dimensions.
Vous donnez un sens à l’axe horizontal et un autre à l’axe vertical, puis vous
posez chaque mot là où il se situe par rapport à ces deux sens. Chaque mot se
retrouve avec des coordonnées, c’est-à-dire un vecteurvectorvecteurmachine learningapprentissage automatiqueAn ordered list of numbers.Liste ordonnée de nombres. :
ici une liste de deux nombres, un par axe. Ces nombres font plus que localiser
le mot. Ils disent comment il se situe sur chacun des deux sens, et à quelle
distance il se trouve de tous les autres mots du même espace.
La vitesse et le nombre de passagers
Figure 1. Deux dimensions choisies à la main, le nombre de passagers et la vitesse. Chaque véhicule reçoit un vecteur, et des groupes se forment que personne n'a dessinés.
L’idée est développée pour des moyens de transport dans la
Figure 1figure 1.
L’axe horizontal est le nombre de passagers et l’axe vertical la vitesse, et la
plupart des gens s’entendraient sur la place approximative de chaque véhicule.
La planche est basse sur les deux : elle ne va pas vite et elle transporte une
personne. La fusée a une vitesse maximale et une capacité plus modeste, ce qui
lui donne le vecteur [0,4 ; 1,0]. Là où un vecteur 1 parmi n ne faisait
qu’identifier un mot, cette paire de nombres dit quelque chose de la chose
nommée, et elle fixe la distance entre la fusée et tous les autres véhicules de
l’espace.
Placer les mots de cette façon fait aussi apparaître des groupes d’eux-mêmes.
Le transport individuel se rassemble à gauche, le transport collectif à droite,
et la fusée reste à part, là où elle a sa place. Personne n’a dessiné ces
groupes ; ils découlent des coordonnées.
Où placer la pomme
Jusqu’ici, voilà une manière prometteuse de transformer des mots en listes de
nombres qui veulent dire quelque chose. Puis : où placeriez-vous une pomme dans
cet espace ? La question n’a aucun sens, parce que la vitesse et le nombre de
passagers ne disent rien d’une pomme.
Figure 2. Les deux mêmes axes, et une pomme que ni l'un ni l'autre ne mesure.
Deux conséquences. Un espace qui accueille un vocabulaire entier a besoin de
bien plus de deux dimensions, puisqu’il doit convenir à tout, de planche à
ardeur. Et dès qu’il y a des centaines de dimensions et des dizaines de
milliers de mots, ni les axes ni les positions ne peuvent être choisis par une
personne.
Reste la question : comment trouver automatiquement de tels nombres, pour
chaque mot d’un vocabulaire ?
Des dimensions qui veulent dire quelque chose
Construire l’espace des transports avec le groupe avant de le montrer : la
vitesse sur un axe, le nombre de passagers sur l’autre, puis demander où
vont une planche, un autobus et une fusée. La pomme arrive à l’écran
suivant, avec la question qui tue la version faite à la main.
La compagnie que tient un mot
Cinq trous
adopter un ___
caresser le ___ du
et le ___ ronronne fort
promener son ___ en laisse
le ___ aime-t-il la musique
Cinq trous
Supposons qu’on vous donne cinq fragments de texte, chacun avec un mot
manquant :
adopter un ___
caresser le ___ du
et le ___ ronronne fort
promener son ___ en laisse
le ___ aime-t-il la musique
Quels mots pourraient remplir le trou ? Chat entre sans peine dans les trois
premiers ; la laisse fait hésiter. Chien entre dans l’adoption, la caresse et
la laisse, et échoue sur le ronronnement. Le dernier fragment accepte n’importe
lequel des trois, et c’est pourquoi il vous apprend si peu. Les deux mots
partagent donc la plupart de leurs contextes, et ceux qu’ils ne partagent pas
sont exactement ceux qu’on attendrait : un chat ronronne, on promène un chien.
Essayez maintenant serpent. Il va avec adopter un ___, et ensuite, cela se
complique : un serpent ne ronronne pas, et un serpent en laisse, c’est
vraiment tiré par les cheveux. Serpent partage un ou deux contextes avec
chat et chien, et pas le reste. Un mot comme démocratie ne remplit
aucun des cinq.
Il ne suffit pas qu’un mot puisse remplir un trou : la fréquence à laquelle
il le fait compte aussi. Chat précède ronronne bien plus souvent
qu’il ne suit promener son, et un système qui compte les contextes dans un
grand ensemble de textes voit cette différence directement.
Figure 3. Des mots semblables remplissent des trous semblables, et la fréquence est la part qui compte. Chat et chien partagent la plupart de leurs contextes ; serpent en partage bien moins.
Ce que montrent les trous
Les mots dont le sens est apparenté apparaissent dans des contextes semblables,
et plus les contextes de deux mots se recoupent, plus leurs sens ont tendance à
être proches. Des linguistes l’ont formulé dans les années 1950, Joos, Harris
et Firth parmi eux (Jurafsky et Martin, 2026), et Firth l’a résumé en une
phrase : « You shall know a word by the company it keeps » (Firth, 1957).
Pourquoi cela convient à une machine
L’idée est utile à une machine par ce qu’elle n’exige pas :
Aucune définition. Personne n’a à dire ce que chat veut dire.
Aucune annotation. Personne n’a à marquer des exemples à la main.
Aucun axe choisi à la main. Personne ne choisit les dimensions de
l’espace, ni la place de chaque mot sur celles-ci.
Il faut en revanche du texte, en quantité. Les contextes sont observables :
n’importe quel grand ensemble de textes montre directement quels mots
entourent quels autres. Un système peut donc se construire un substitut
utilisable du sens simplement en lisant assez de texte.
La compagnie que tient un mot
Lire les cinq trous à voix haute et laisser le groupe les remplir, un mot à
la fois : chat, puis chien, puis serpent, puis démocratie. Ensuite la
figure, puis la phrase de Firth.
Court, dense, et des distances qui veulent dire quelque chose
Chaque propriété de ces vecteurs contraste avec la représentation 1 parmi n :
Court plutôt que long comme le vocabulaire. Typiquement de 100 à 300
dimensions, plutôt qu’une par mot.
Dense plutôt que creux. Chaque position porte une valeur informative
plutôt qu’un zéro.
La distance veut dire quelque chose.Chat et chien se retrouvent
proches, serpent plus loin, démocratie tout à fait ailleurs, parce que
leurs contextes l’ont imposé pendant l’entraînement.
Figure 4. Le même mot dans les deux représentations. Le vecteur appris est court et dense, et aucune de ses valeurs ne se lit isolément.
Des axes illisibles
L’exemple des moyens de transport montrait des axes interprétables : la vitesse
et le nombre de passagers. Les dimensions apprises ne le sont pas. Elles ne
correspondent à aucune propriété nommable, et regarder une seule valeur ne dit
rien. Dans cette représentation, le sens d’un mot est le motif complet de
toutes ses valeurs prises ensemble, et seules les comparaisons entre vecteurs
entiers ont un sens.
Des plongements appris à partir de textes
Des plongements appris à partir de textes
L’habitude à casser : aucune dimension ne représente quoi que ce soit de
nommable. Seuls des vecteurs entiers se comparent. Le dire explicitement,
parce que la figure des transports vient d’enseigner le contraire.
Prenez le vecteur de roi, soustrayez le vecteur de homme, puis ajoutez le
vecteur de femme. Le point où vous arrivez a pour plus proche voisin le mot
reine (Mikolov et al., 2013b). Rien dans l’entraînement ne visait ce
résultat. Il découle de la géométrie : le déplacement de homme vers roi
encode quelque chose comme la royauté, et appliquer ce même déplacement à
femme arrive près de reine.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. Soustraire homme de roi laisse la couronne, et ajouter femme à la couronne arrive à reine.
Une direction parmi bien d’autres
La direction de la royauté est l’une parmi bien d’autres. Mikolov et al.
(2013b) ont éprouvé le motif de façon systématique sur des relations
grammaticales, mille questions chacune pour les comparatifs (good est à
better ce que rough est à rougher), les pluriels (year est à years)
et le temps des verbes (see est à saw ce que return est à returned), et
il tenait. Les relations encyclopédiques se comportent
de la même manière, dont celle d’un pays et de sa capitale (Jurafsky et Martin,
2026). Les axes restent illisibles. Le sens est dans les directions entre
vecteurs entiers, et celles-ci peuvent se chercher après coup.
Figure 6. Une relation grammaticale et une relation encyclopédique, chacune une direction que toutes les paires partagent.
La démonstration en ligne de Carnegie Mellon fait exactement cela. Les trois
captures ci-dessous en viennent, prises le 9 septembre 2026, et la démonstration peut
changer. Elles sont denses ; un clic ouvre chacune en plus grand.
Figure 7. L'espace projeté sur deux directions nommées par des mots : l'intelligence et l'empathie. Les axes ont été choisis après l'entraînement, ils n'y étaient pas intégrés. Figure 8. Trois analogies sur les vecteurs word2vec de la démonstration. Canada est à moose ce que UK est à deer, Montreal est à cold ce que Miami est à hot, Quebec est à French ce que Flanders est à Flemish. Chaque analogie est saisie en mots au-dessus et en arithmétique vectorielle au-dessous, et les deux formes renvoient le même mot.
La même arithmétique sur les stéréotypes
L’arithmétique fonctionne aussi sur les stéréotypes. Dans des plongements
entraînés sur des articles de Google News, man est à computer programmer ce
que woman est à homemaker, et les noms de métiers se répartissent selon une
direction de genre exactement comme roi et reine se répartissent selon une
direction de royauté (Bolukbasi et al., 2016).
Figure 9. La même démonstration, sur les mêmes vecteurs word2vec. Man est à king ce que woman est à queen, l'analogie des manuels. Puis man est à strong ce que woman est à weak, et man est à handsome ce que woman est à beautiful.
Aucun programmeur n’a décidé d’éloigner woman de doctor et de la rapprocher
de nurse. Le biais vient des textes : les vecteurs enregistrent la manière
dont les mots sont employés à travers des millions de phrases, et ce sont des
personnes qui ont écrit ces phrases. La méthode fonctionne comme prévu. Les
conséquences touchent tout ce qui a été construit sur des plongements
depuis (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
De l'arithmétique avec des sens
De l'arithmétique avec des sens
À essayer en direct
cs.cmu.edu/~dst/WordEmbeddingDemo/, sur de vrais vecteurs word2vec et GloVe
roi − homme + femme, puis une analogie dans les langues de travail du groupe
une analogie de métiers, avant le résultat de Bolukbasi
La démonstration de CMU tourne dans un navigateur sur word2vec et GloVe :
essayer roi − homme + femme en direct, puis prendre une analogie dans les
langues de travail du groupe. Demander une analogie de métiers avant de
montrer le résultat de Bolukbasi, pour que le biais arrive comme quelque
chose que le groupe a produit et non comme un avertissement.
Trois limites
Figure 10. Une forme pour deux sens, et un même ensemble de mots dans deux ordres. Un vecteur fixe par mot ne distingue ni l'une ni l'autre paire.
Les mots nouveaux n’obtiennent rien
Un modèle de plongements a un vecteur pour chaque mot rencontré à
l’entraînement : un mot forgé l’an dernier, un terme technique rare ou une
coquille n’a donc aucun vecteur et aucune représentation. Les langues à
morphologie riche aggravent la situation, puisque leurs composés et leurs
flexions productives produisent des formes qu’aucune base d’apprentissage ne
contient. Les systèmes modernes dissolvent le problème en travaillant sur des
morceaux de mots (see also the Tokenization chapter) (voir aussi le chapitre Jetonisation).
Un seul vecteur fait la moyenne de tous les sens
Livres désigne une monnaie dans j’ai changé mille livres et des ouvrages
dans j’ai emprunté trois livres. Un vecteur unique pour livres doit servir
aux deux phrases : il atterrit donc quelque part entre la finance et la
lecture, un compromis qui a tort partout. Ce n’est même pas un compromis
équitable : le vecteur est une moyenne sur les occurrences, il se place donc au
plus près du sens le plus fréquent dans les textes d’entraînement, et c’est le
sens le plus rare qui est le plus mal servi. La traduction s’en aperçoit tôt,
puisque choisir entre pounds et books est exactement une décision sur le
sens actif.
L’ordre est invisible
Jean suit le chien et le chien suit Jean contiennent les mêmes mots et ne
décrivent pas la même promenade ; toute représentation construite en combinant
des vecteurs de mots fixes a donc du mal à les distinguer. Le sens dépend de
l’agencement, et des vecteurs par mot n’ont nulle part où mettre l’agencement.
Les limites des vecteurs statiques
Trois problèmes, une seule cause
Les mots nouveaux n’obtiennent aucun vecteur
Un vecteur fait la moyenne de tous les sens : pounds ou books ?
L’ordre est invisible : mêmes mots, autre promenade
Le vecteur est calculé une fois puis figé, avant que le mot serve dans une
phrase.
The page behind this slideLa page derrière cette diapositive
1 / 2The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter