What a score measures
A new model is usually announced with a list of benchmarks on which it beats the last one (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). The best-known benchmark for general knowledge, MMLU (Massive Multitask Language Understanding), tests models on about 14,000 multiple-choice questions across 57 subjects, from elementary mathematics to professional law, and a model’s score is the share it answers correctly (Hendrycks et al., 2021).
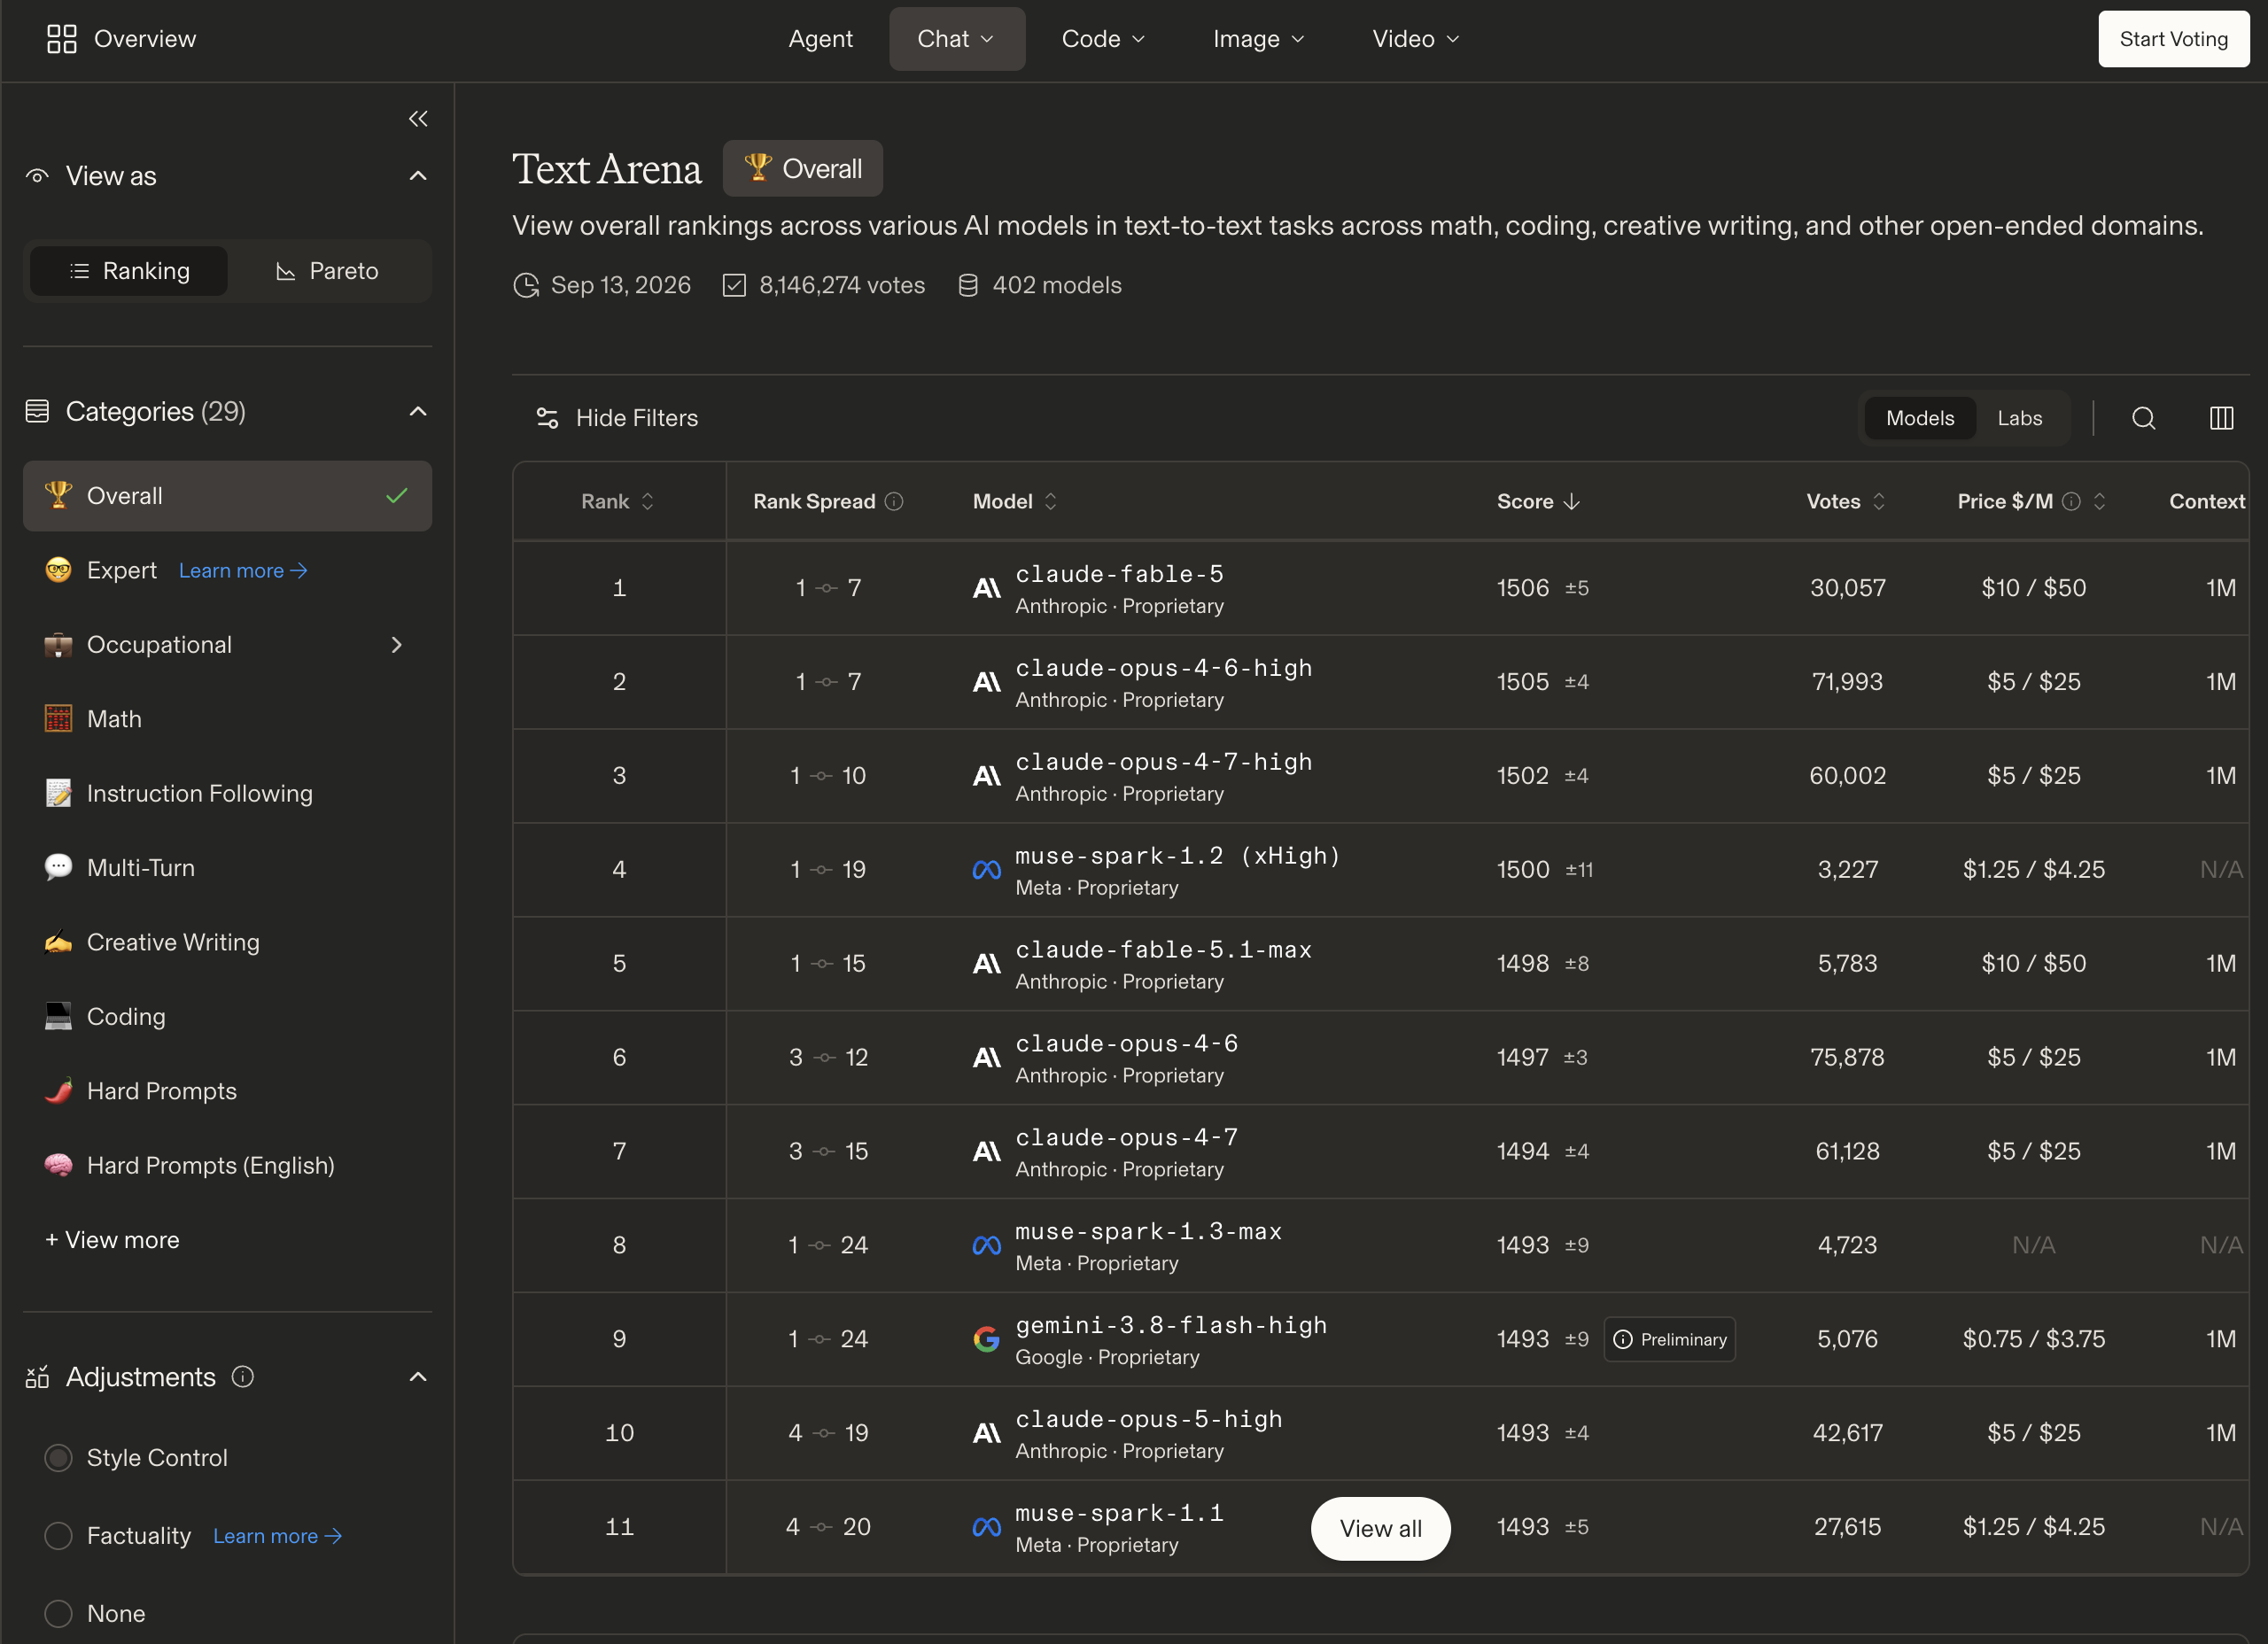
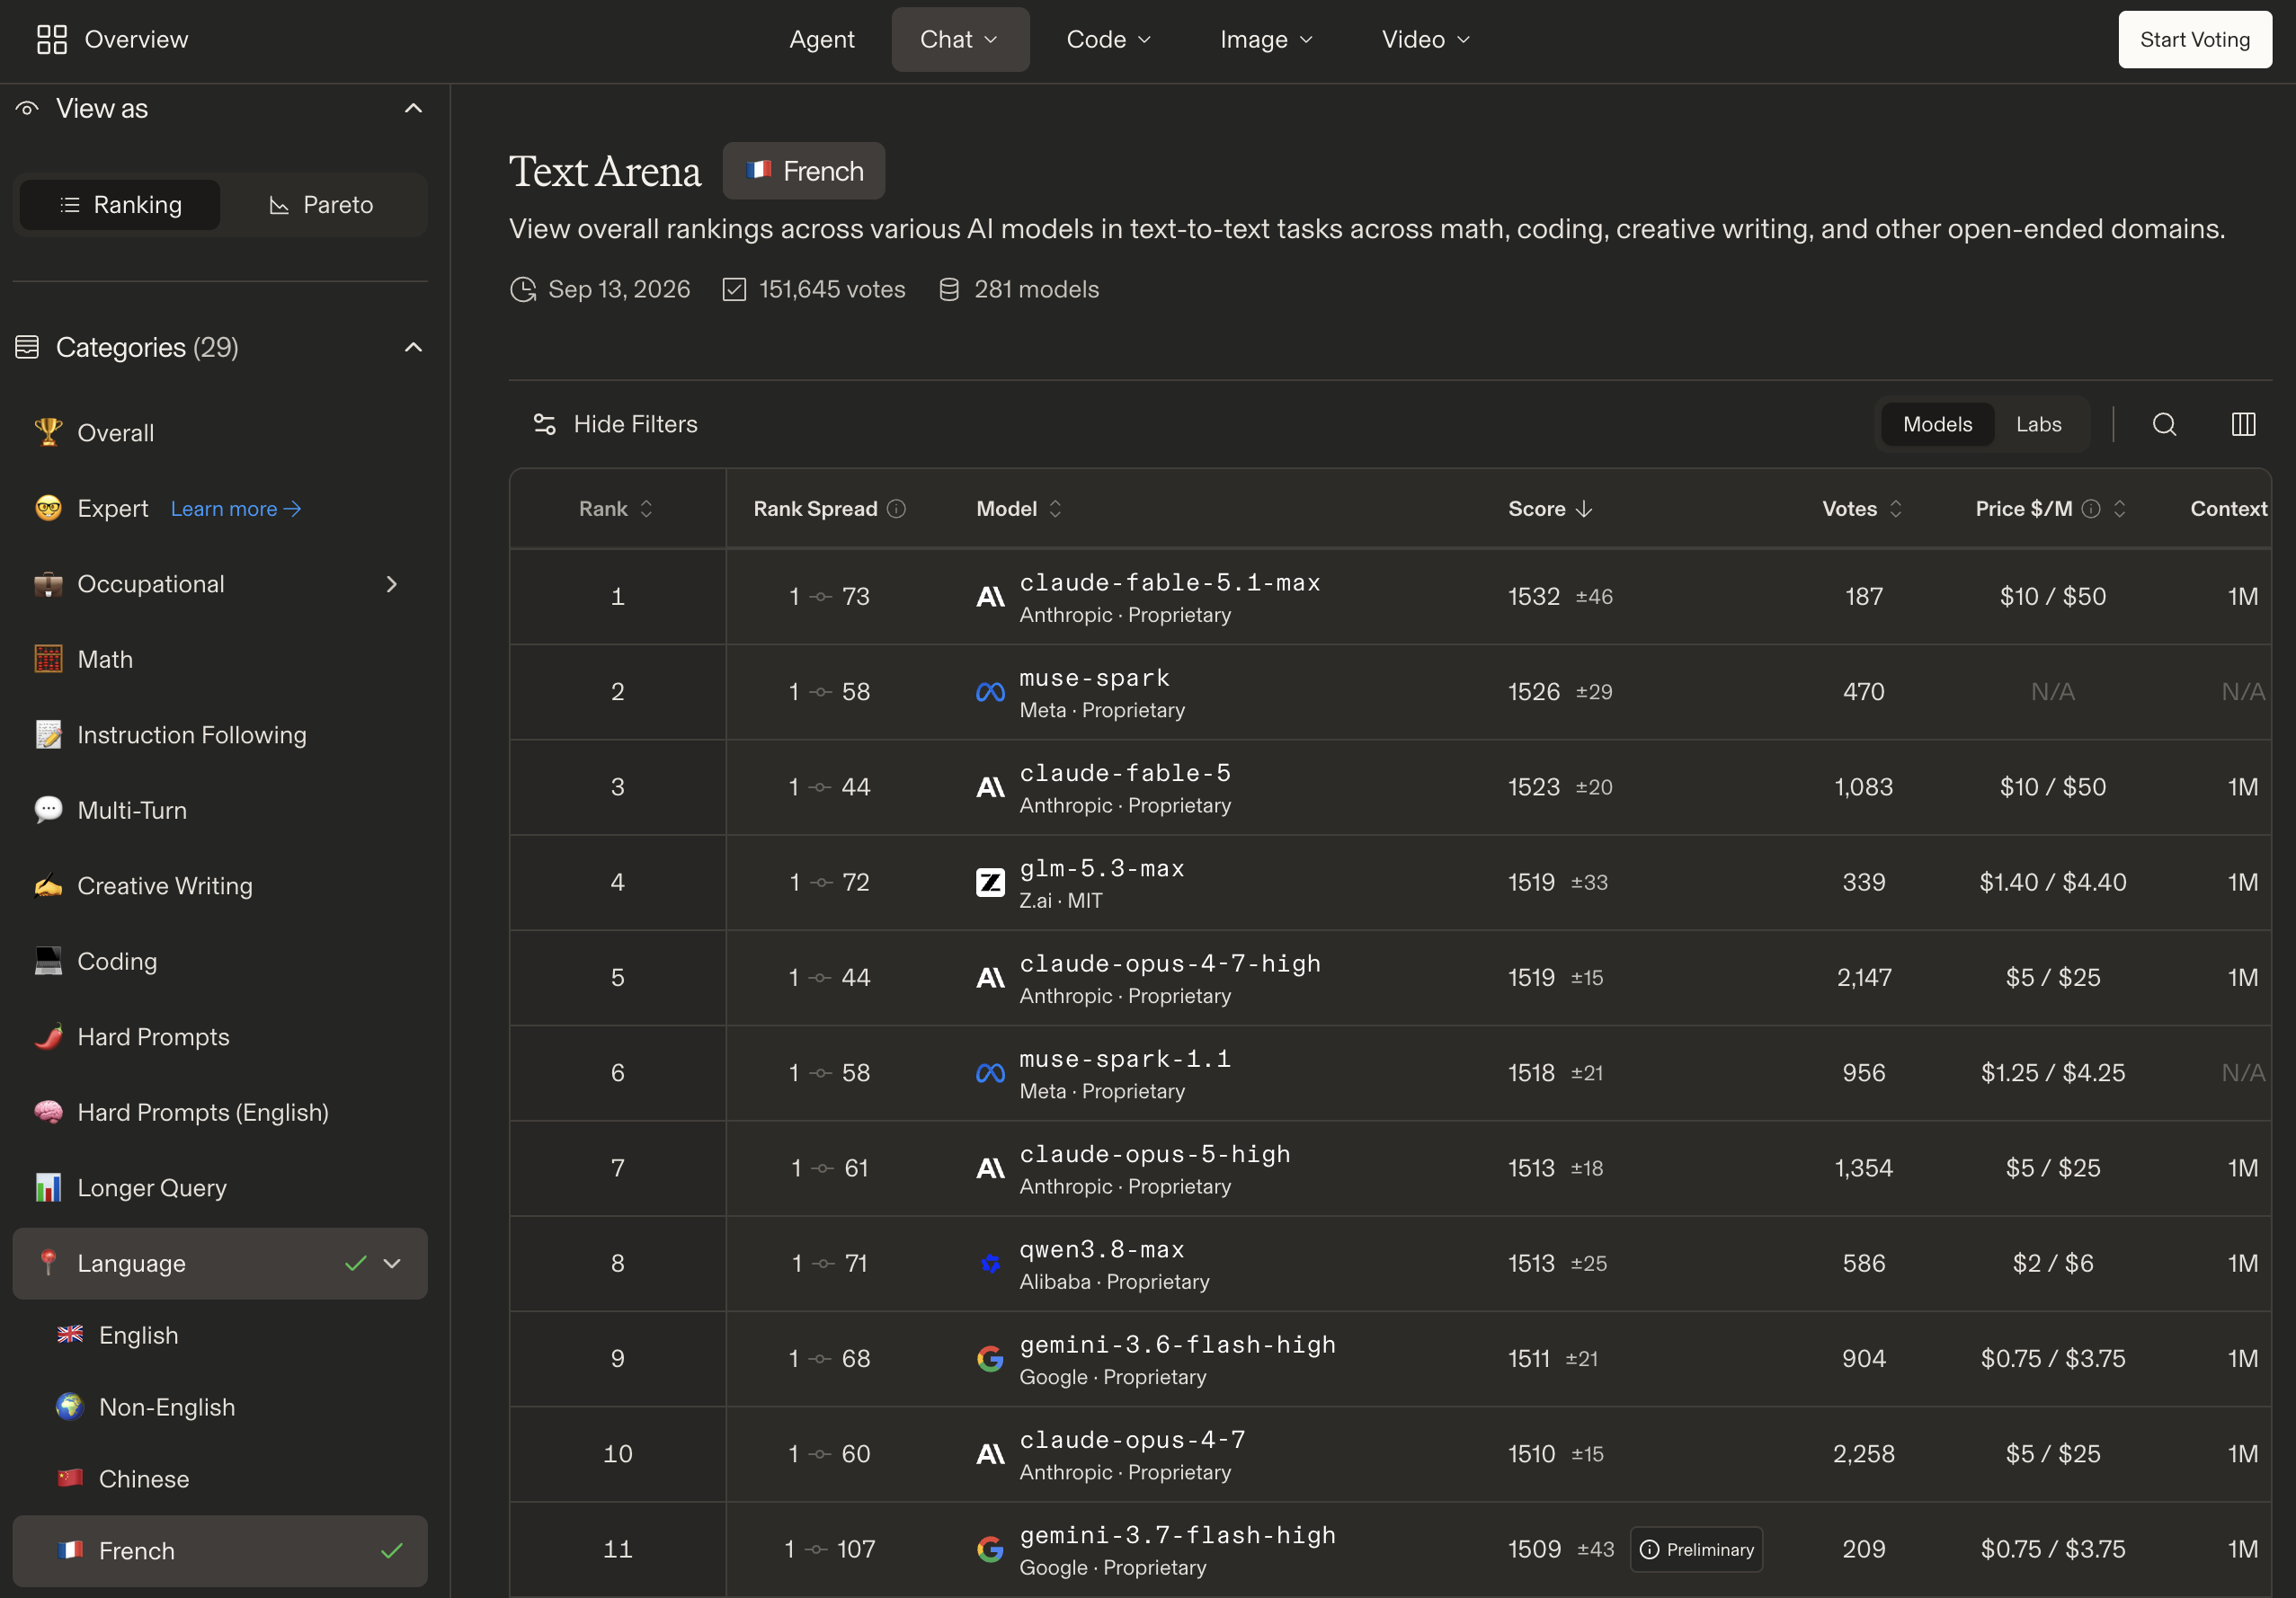
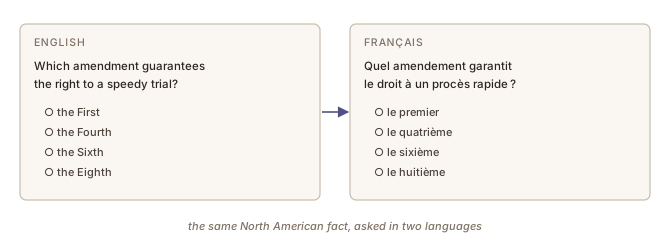
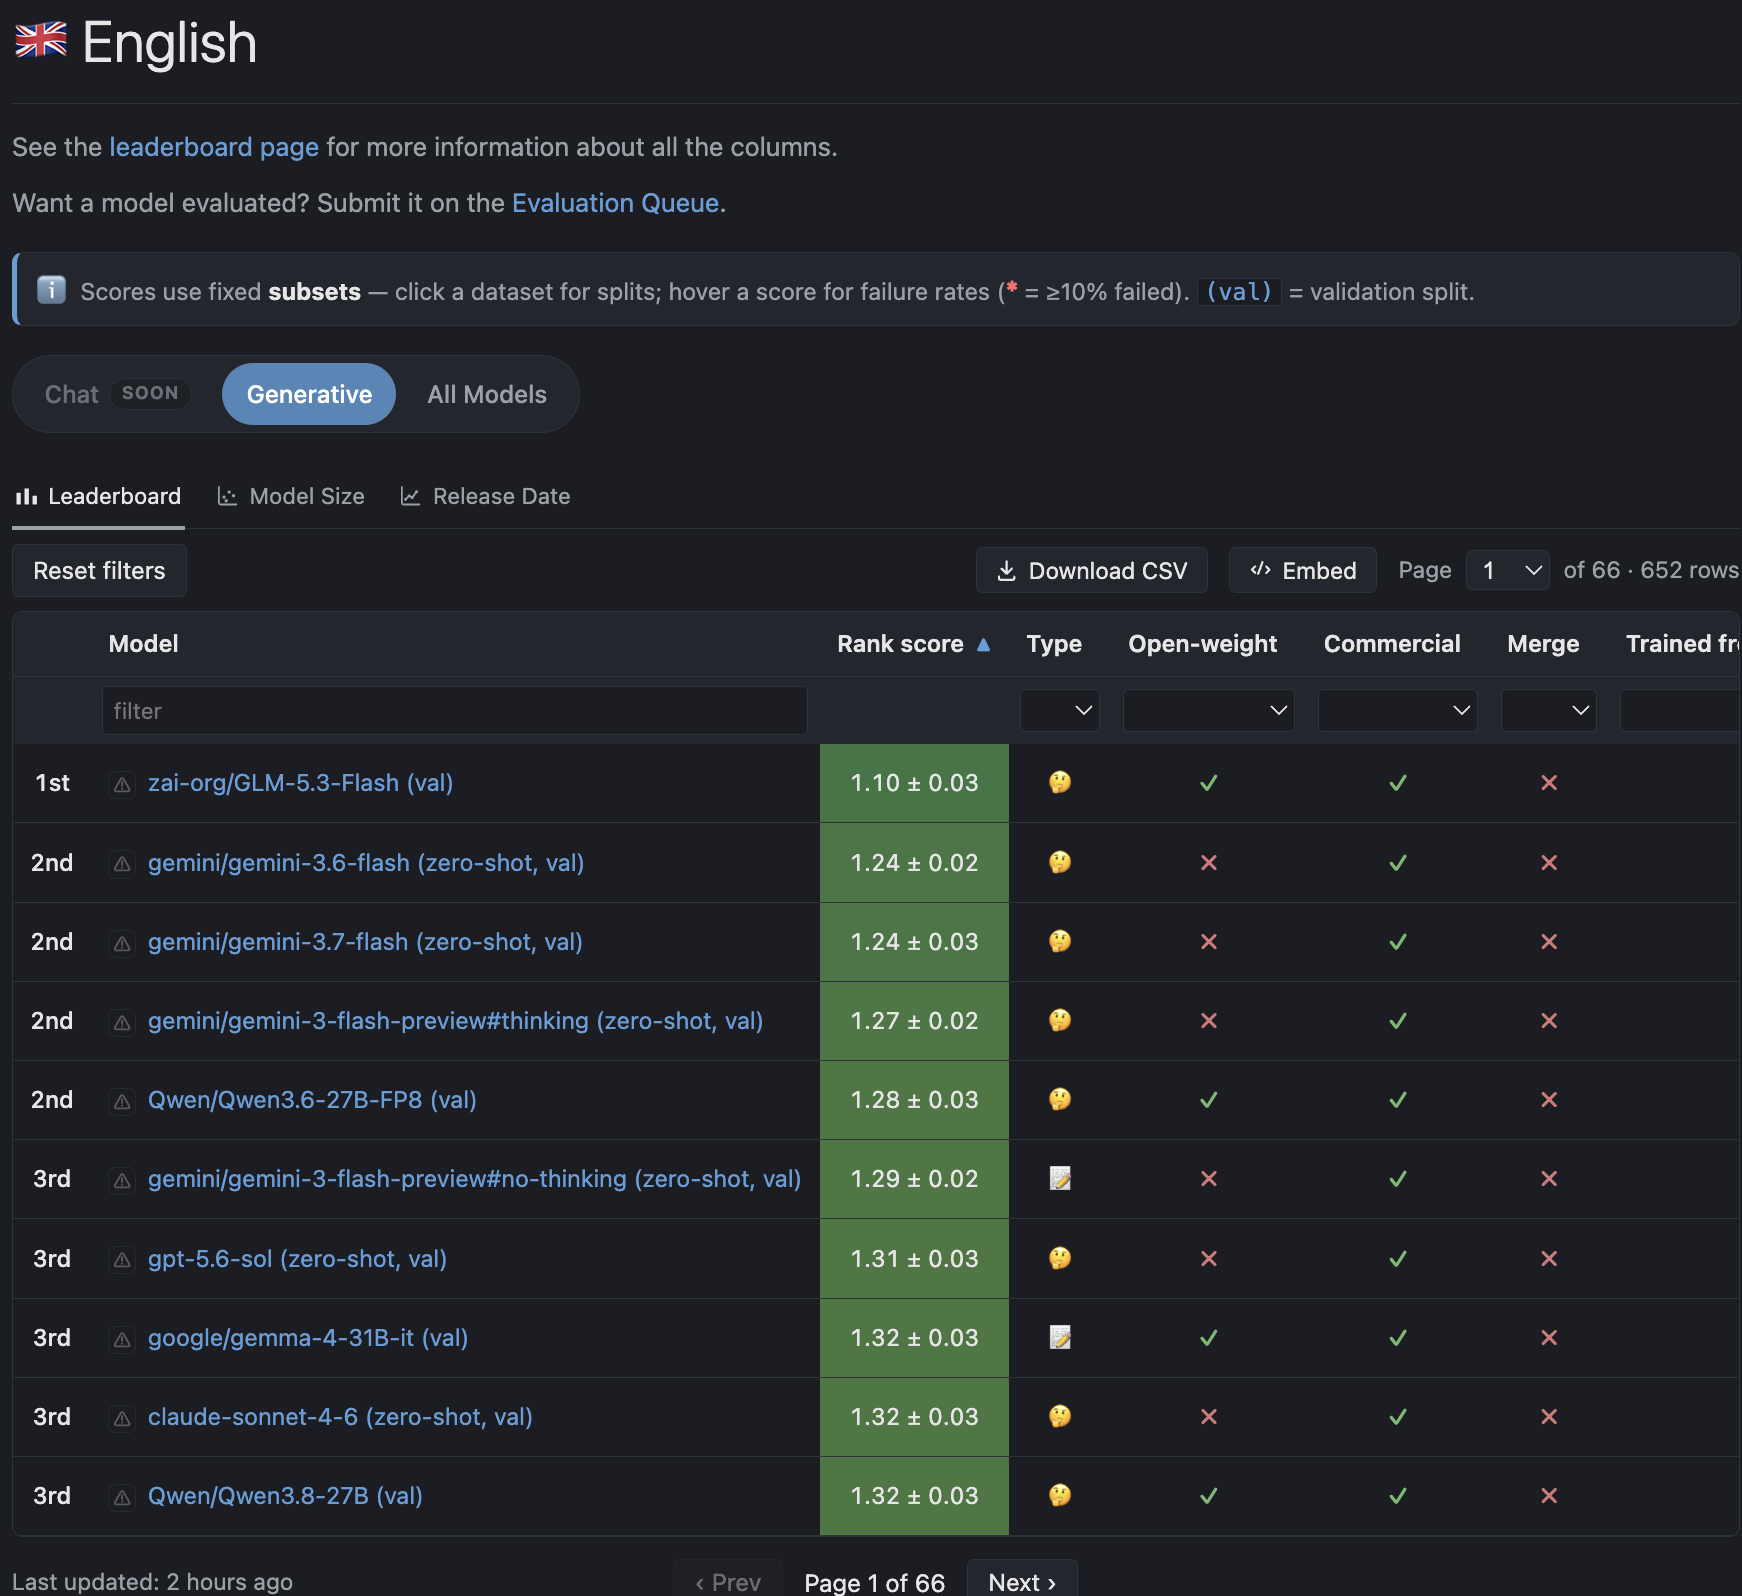
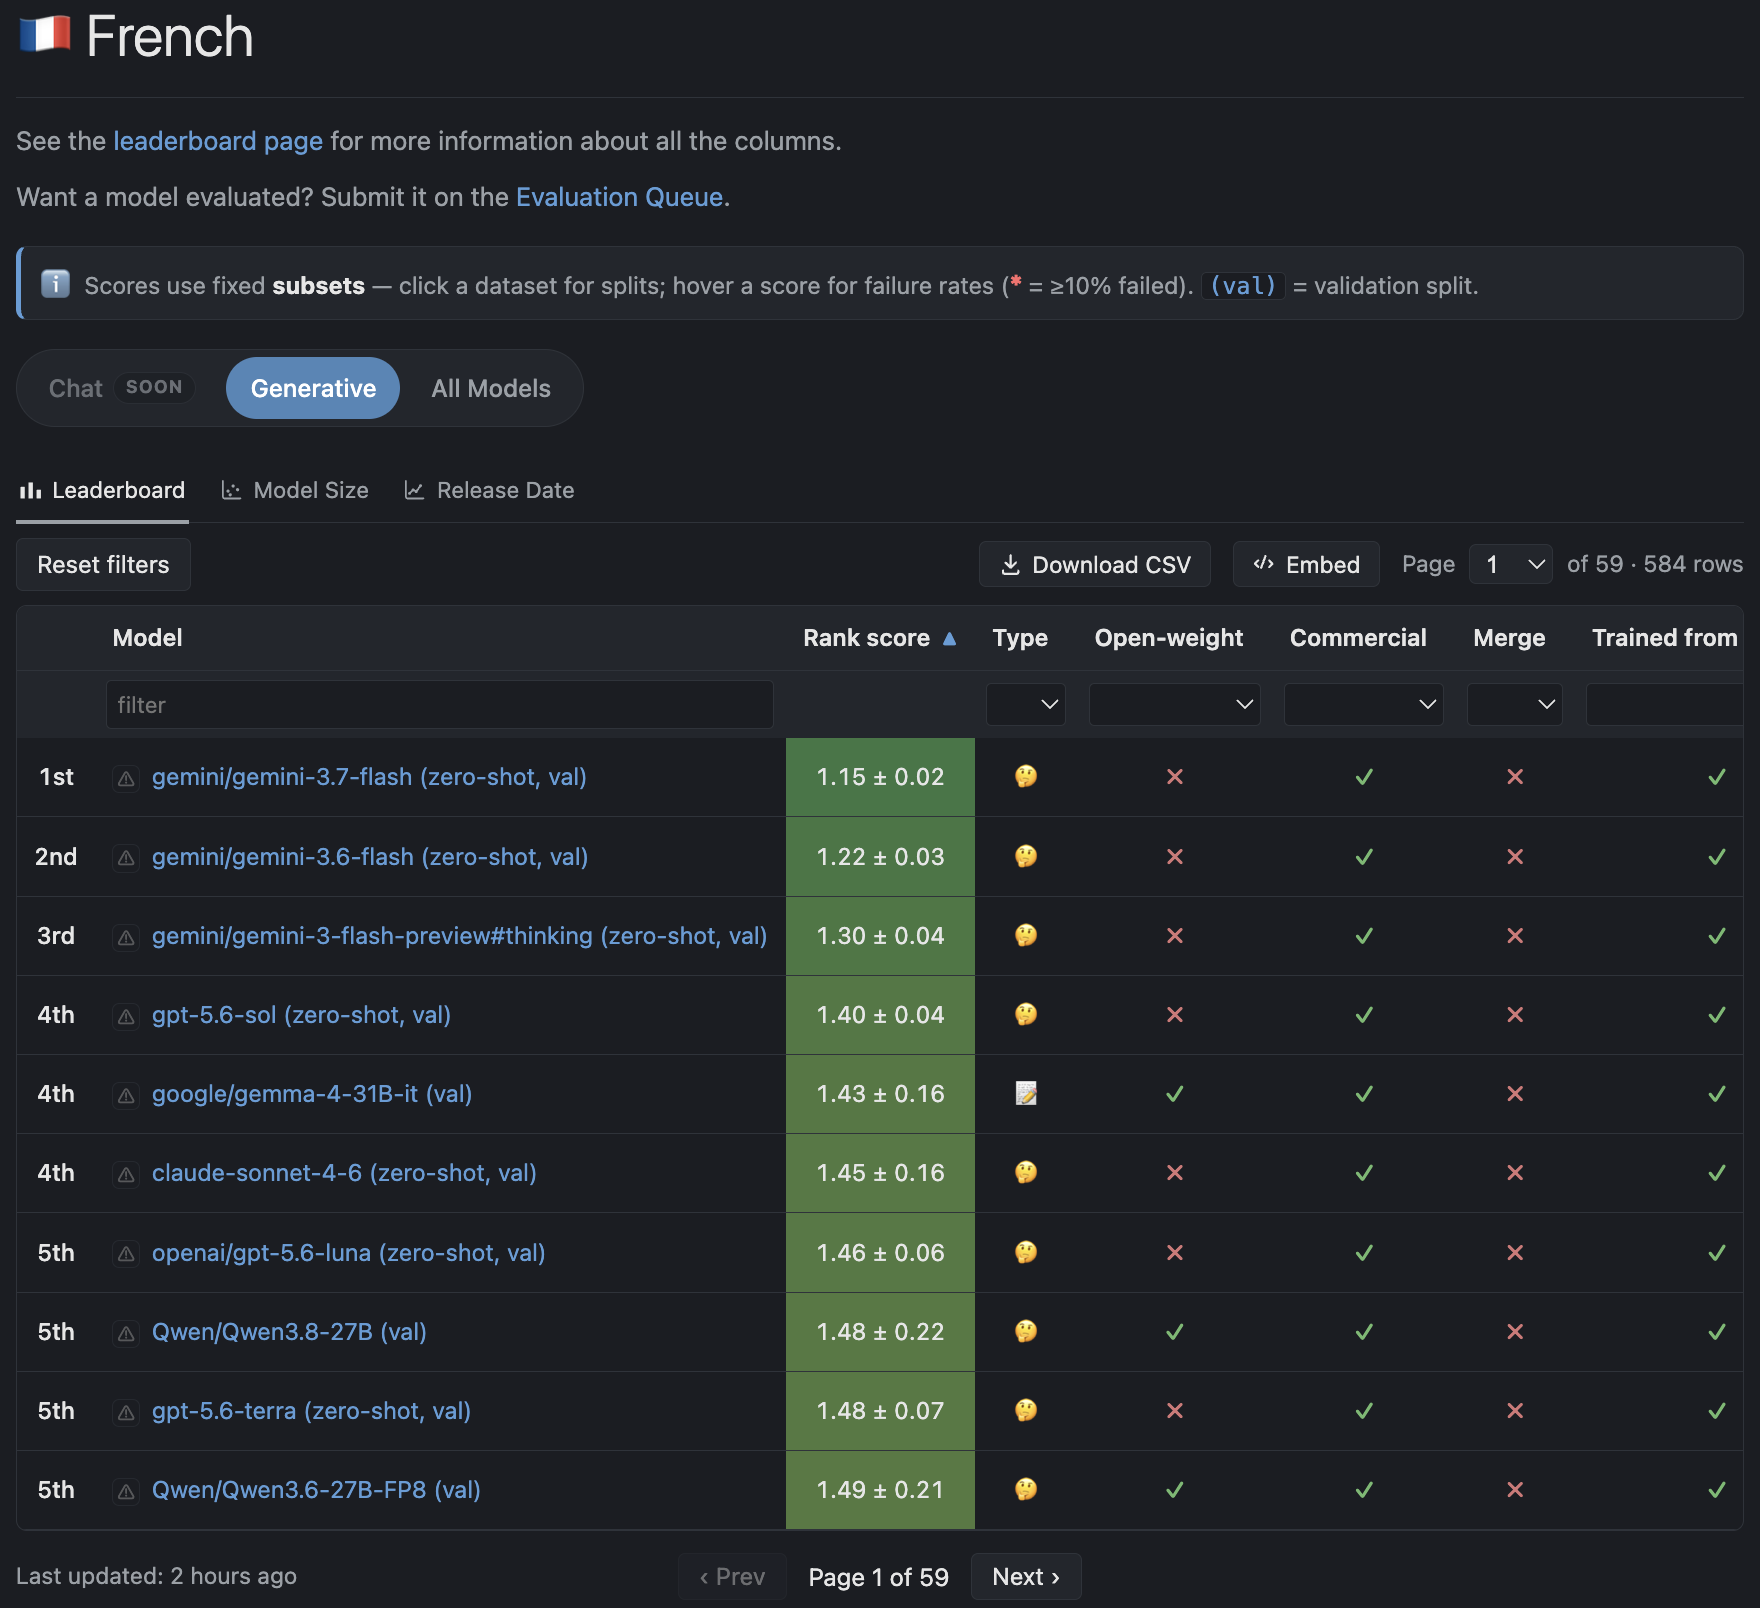
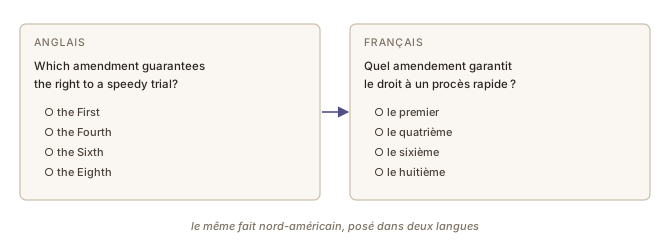
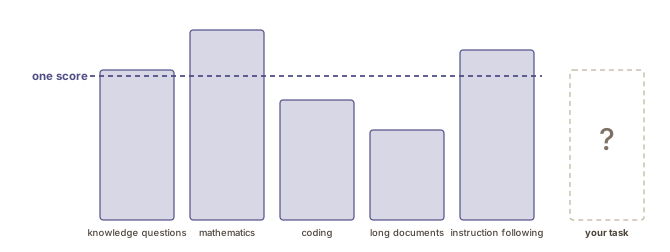
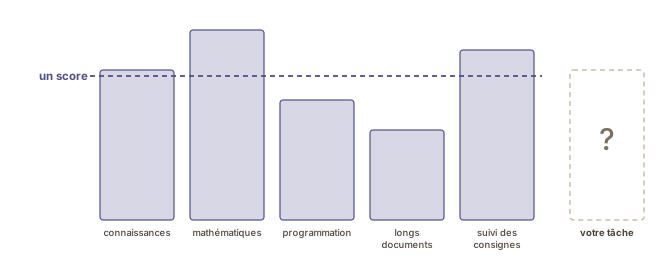
So the first thing to check about any score is the questions behind it. A multiple-choice knowledge test says nothing about writing, a coding test nothing about translation, and a test of English says little about French. A leaderboard that averages several benchmarks into one number hides which of them a model did well on (Figure 1figure 1). The Artificial Analysis Intelligence Index, for instance, averages ten tests (see also the Families, generations and tiers page) (voir aussi la page Familles, générations et niveaux).
Three reasons a score means less than it looks
The test was in the training data
A public benchmark is text on the web, and models are trained on web text. A model that has seen the questions, or papers discussing the answers, scores higher without being better. This is data contamination.
It is hard to check from outside, because the training data is rarely disclosed (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML), but it has to be checked benchmark by benchmark rather than assumed absent (Sainz et al., 2023).
Researchers have also leaked test sets themselves, by pasting benchmark questions into a chat interface that may train on its conversations. Balloccu et al. (2024) went through 255 papers and estimated that about 4.7 million test items from 263 benchmarks had reached OpenAI’s GPT-3.5 and GPT-4 that way.
The test became the target
A benchmark with commercial weight invites providers to train toward it, and a model tuned to a test improves on the test faster than on the ability the test was meant to stand for. The pattern is old enough to have a name.
When a measure becomes a target, it ceases to be a good measure.
Strathern (1997, p. 308), whose sentence is usually quoted as Goodhart’s law
When the best models reach the ceiling, a harder benchmark replaces it. MMLU gave way to tests written to be failed, such as Humanity’s Last Exam: 2,500 expert-level questions, kept only if the models of the day answered them wrongly. In the evaluation published with it, no model answered more than about a quarter correctly (Phan et al., 2026). By September 2026, the best score measured by Artificial Analysis was above half.Artificial Analysis, Humanity’s Last Exam Benchmark Leaderboard, read 17 September 2026: best score 59.1%. The leaderboard kept by the benchmark’s authors at agi.safe.ai listed 38.3% as its best score on the same day, but had not added the newest models.
The test is not your task
A benchmark measures a defined skill on defined material. Your work involves particular kinds of text, in particular languages, with conventions of your own or of the people you work for, and no public benchmark is about that.
The score tells you which model did better on that test; only your own cases tell you which does better for you (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests).
Sources
- Balloccu, S., Schmidtová, P., Lango, M., & Dušek, O. (2024). Leak, Cheat, Repeat: Data Contamination and Evaluation Malpractices in Closed-Source LLMs. Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers), 67–93. https://doi.org/10.18653/v1/2024.eacl-long.5
- Hendrycks, D., Burns, C., Basart, S., Zou, A., Mazeika, M., Song, D., & Steinhardt, J. (2021). Measuring Massive Multitask Language Understanding. Proceedings of the Ninth International Conference on Learning Representations (ICLR 2021). https://openreview.net/forum?id=d7KBjmI3GmQ
- Phan, L., Gatti, A., Li, N., Khoja, A., Kim, R., Ren, R., et al. (2026). A benchmark of expert-level academic questions to assess AI capabilities. Nature, 649(8099), 1139–1146. https://doi.org/10.1038/s41586-025-09962-4
- Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
- Strathern, M. (1997). 'Improving ratings': audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4
Ce que mesure un score
Un nouveau modèle est d’habitude annoncé avec une liste de tests sur lesquels il fait mieux que le précédent (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). Le plus connu pour les connaissances générales, MMLU (Massive Multitask Language Understanding), soumet les modèles à environ 14 000 questions à choix multiple réparties dans 57 matières, des mathématiques élémentaires au droit professionnel ; le score d’un modèle est la proportion de bonnes réponses (Hendrycks et al., 2021).
La première chose à vérifier, pour tout score, ce sont donc les questions qui le produisent. Un test de connaissances à choix multiple ne dit rien de l’écriture, un test de programmation rien de la traduction, et un test en anglais dit peu de chose du français. Un classement qui fait la moyenne de plusieurs tests en un seul chiffre cache ceux sur lesquels un modèle a réussi (Figure 1figure 1). L’Artificial Analysis Intelligence Index, par exemple, fait la moyenne de dix tests (see also the Families, generations and tiers page) (voir aussi la page Familles, générations et niveaux).
Trois raisons pour lesquelles un score veut dire moins qu’il n’y paraît
Le test figurait dans les données d’entraînement
Un test public est du texte sur le Web, et les modèles sont entraînés sur du texte du Web. Un modèle qui a vu les questions, ou des articles qui discutent des réponses, obtient un meilleur score sans être meilleur. C’est la contamination des données.
Elle est difficile à vérifier de l’extérieur, parce que les données d’entraînement sont rarement rendues publiques (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML), mais elle doit être vérifiée test par test plutôt que supposée absente (Sainz et al., 2023).
Des chercheurs ont aussi eux-mêmes fait fuiter des jeux de test, en collant des questions de tests dans une interface de clavardage qui peut s’entraîner sur ses conversations. Balloccu et al. (2024) ont passé en revue 255 articles et estimé qu’environ 4,7 millions d’éléments de test tirés de 263 tests étaient parvenus de cette façon à GPT-3.5 et à GPT-4 d’OpenAI.
Le test est devenu la cible
Un test qui compte commercialement incite les fournisseurs à entraîner leurs modèles en vue de ce test, et un modèle ajusté à un test progresse plus vite sur le test que sur la compétence que le test était censé représenter. Le phénomène est assez ancien pour porter un nom.
« Lorsqu’une mesure devient un objectif, elle cesse d’être une bonne mesure. »
Strathern (1997, p. 308), dont la phrase est habituellement citée comme la loi de Goodhart (ma traduction)
Quand les meilleurs modèles atteignent le plafond, un test plus difficile prend la relève. MMLU a cédé la place à des tests conçus pour être échoués, comme Humanity’s Last Exam : 2 500 questions de niveau expert, conservées seulement si les modèles de l’époque y répondaient mal. Dans l’évaluation publiée avec ce test, aucun modèle n’a répondu correctement à plus d’environ un quart des questions (Phan et al., 2026). En septembre 2026, le meilleur score mesuré par Artificial Analysis dépassait la moitié.Artificial Analysis, Humanity’s Last Exam Benchmark Leaderboard, consulté le 17 septembre 2026 : meilleur score de 59,1 %. Le classement tenu par les auteurs du test sur agi.safe.ai indiquait 38,3 % comme meilleur score le même jour, mais n’avait pas encore ajouté les modèles les plus récents.
Le test n’est pas votre tâche
Un test mesure une compétence définie sur un matériau défini. Votre travail porte sur des types de textes particuliers, dans des langues particulières, avec des conventions qui sont les vôtres ou celles des personnes pour qui vous travaillez, et aucun test public ne porte là-dessus.
Le score vous dit quel modèle a fait mieux sur ce test ; seuls vos propres cas vous disent lequel fait mieux pour vous (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests).
Sources
- Balloccu, S., Schmidtová, P., Lango, M., & Dušek, O. (2024). Leak, Cheat, Repeat: Data Contamination and Evaluation Malpractices in Closed-Source LLMs. Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers), 67–93. https://doi.org/10.18653/v1/2024.eacl-long.5
- Hendrycks, D., Burns, C., Basart, S., Zou, A., Mazeika, M., Song, D., & Steinhardt, J. (2021). Measuring Massive Multitask Language Understanding. Proceedings of the Ninth International Conference on Learning Representations (ICLR 2021). https://openreview.net/forum?id=d7KBjmI3GmQ
- Phan, L., Gatti, A., Li, N., Khoja, A., Kim, R., Ren, R., et al. (2026). A benchmark of expert-level academic questions to assess AI capabilities. Nature, 649(8099), 1139–1146. https://doi.org/10.1038/s41586-025-09962-4
- Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
- Strathern, M. (1997). 'Improving ratings': audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4