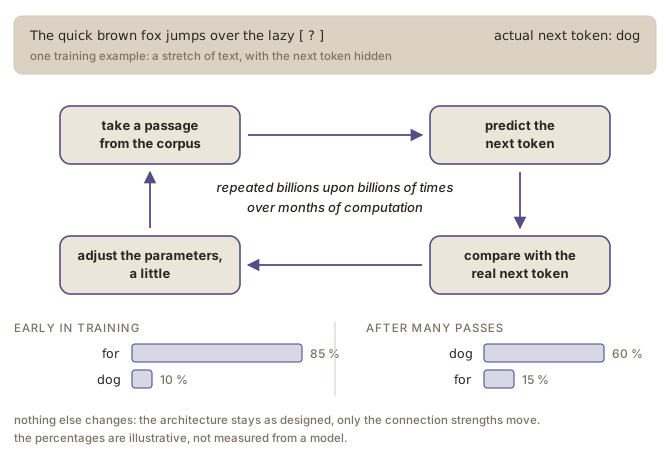
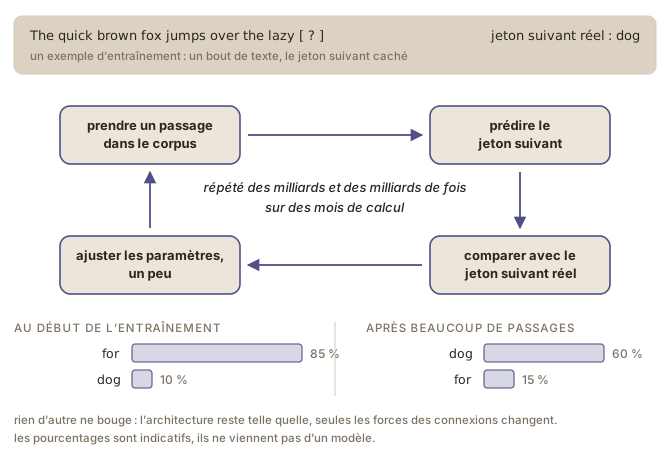
A stretch of text is taken from the corpus. The model is shown the beginning and
asked which token comes next. It produces its probabilities, and those get
compared against the token that actually came next. If the right token was given
a low probability, the parameters are adjusted so that the same context would
push that token a little higher next time.
Figure 1. One turn of the cycle, and what many turns change: early on the model prefers for, and ends up preferring dog.
Each adjustment is tiny. A usable model comes out of their number, across a
corpus of trillions of tokens.
Why the corpus needs no labels
Pretraining is affordable at all because the corpus needs no annotation. Every
position in every sentence is a ready-made exercise: cover the next token,
predict it, uncover it, compare. The text is both the question and the answer
key, so a trillion tokens of raw web text can be trained on without anyone
marking up a single example.
The human decisions are concentrated in assembling the corpus and deciding
what goes into it. The training itself is one arithmetic step repeated
until the budget runs out.
The training loop
Walk the loop once with the fox sentence, then the two bar groups: early in
training the model puts 85 % on “for” and 10 % on “dog”; after many passes it
is the other way round. That shift is what “learning” means here, and the
percentages are illustrative. Then the point the definition box makes: the
corpus needs no annotation, because the next token is already there.
Who can afford to pretrain
What a large run costs
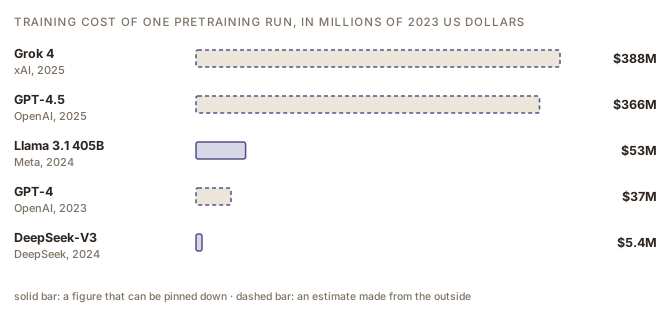
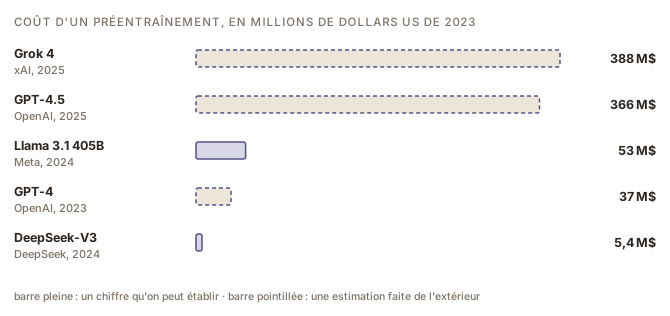
Training the largest of the Llama 3 models took up to 16 000 graphics processing
units (GPUs), each drawing 700 watts (Grattafiori et al., 2024).
Epoch AI (2026) puts that run at about 89 days and 53 million US dollars.
Figure 2. Figures from Epoch AI (2026).
What is settled before a run, and what is not
The budget is fixed before anything starts, together with the model’s
architecture and its number of parameters, and dividing that budget between the
size of the model and the amount of text it reads is the design question behind
it (Kaplan et al., 2020; Hoffmann et al., 2022).
The text itself is not settled. Grattafiori et al. (2024) report raising the
share of non-English data part way through Llama 3’s pretraining, to improve the
model in other languages, and dropping sources they had come to judge poor. The
run does not go straight through either: hardware fails at this size, and
training picks up from the last saved copy of the model’s numbers, a checkpoint.
How many organizations pretrain
Very few, and they are a small number of well-funded companies and labs in the
United States and in China, which concentrates a great deal of influence over
what these systems read and how they
behave (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML). A company releasing several models in a
year is usually not pretraining several times: the variants come from one run,
adapted afterwards by the cheaper steps that
follow (see also the Fine-tuning chapter) (voir aussi le chapitre Affinage).
Who can afford to pretrain
What is settled before a run, and what is not
settled in advance: the computing budget, the architecture, the
number of parameters
steered while the run goes: the mix of text, with the non-English share
raised part way through Llama 3’s pretraining
not continuous: hardware fails, and training resumes from the last
checkpoint
Who can afford to pretrain
How many organizations pretrain
very few: a small number of well-funded companies and labs, in the
United States and in China
a company releasing several models in a year is usually not pretraining
several times
nobody outside can repeat a run to check it
The figure first, and the point to draw out of it: the two most expensive runs
are the two nobody outside can put a firm number on, and the dashed bars say
so. Llama 3’s largest model: up to 16 000 GPUs at 700 watts each, about
89 days, about 53 million dollars.
What a base model does
Asking a base model a question
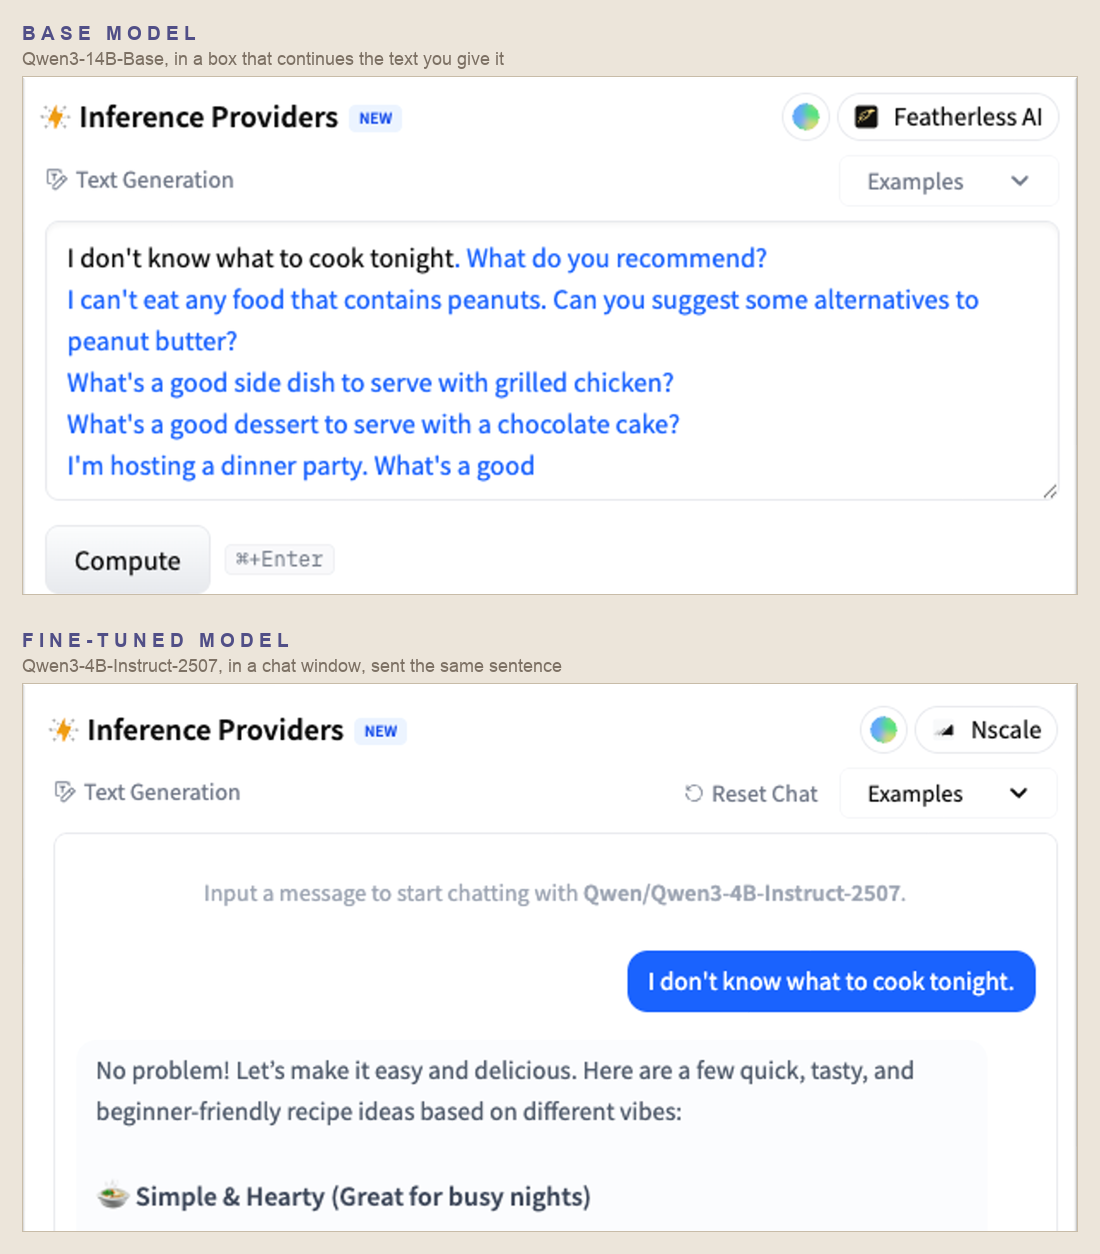
When you have a base model complete What is the capital of France? it may
generate Paris, or it may continue the text in different ways, e.g. what is
the capital of Germany?
The model is doing what it was trained for: continue the given text in a
plausible way. And there are certainly online sources where that question is
followed by more questions instead of an answer. To get the model to behave as a
helpful assistant, more training is
needed (see also the Fine-tuning chapter) (voir aussi le chapitre Affinage).
Figure 3. The same sentence, given to a base model and to a fine-tuned one (Yang et al., 2025b). The interfaces already say what each is for: a box that continues text, and a window you talk to. Captured in 2025; these interfaces change.
A base model will drift between registers within one response for the same
reason, continuing a news report, then drifting into something resembling a
forum reply, then into what looks like code, because nothing has told it where a
response ends or which voice to keep.
The knowledge is there and hard to reach
The model has read about French geography many times, and the association is in
its parameters. The difficulty is getting at it reliably: you would have to
write a prompt that makes the answer the most likely continuation, for instance
by starting the text yourself.
The capital of France is
That is a real technique. But since it is not as intuitive, base models are
rarely offered to the public. Most open families publish only an
instruction-following version and only some offer the base model checkpoint as
well: Meta released Llama 3 as both a pretrained and a post-trained version of
the same model (Grattafiori et al., 2024). The models behind ChatGPT and Claude
are not released at all.
The base model’s answer is correct by the only standard it was trained on:
somewhere in the corpus that question is followed by more questions on a
worksheet. Then the other half: the knowledge is there and hard to reach, and
starting the text yourself (“The capital of France is”) is a real technique.
The model you use in ChatGPT or Claude is never the base model.
Base models and foundation models
The difference between base and foundation
The two terms get used as though they were interchangeable, and they answer
different questions about a model.
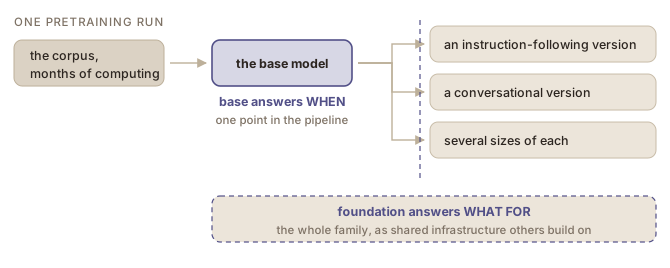
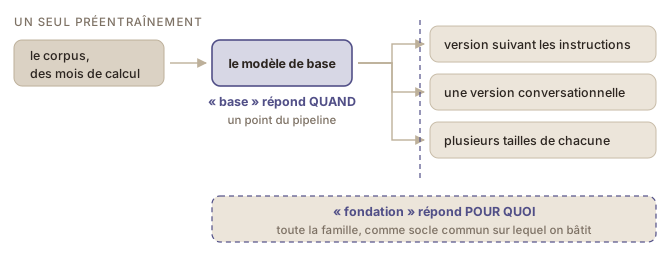
Base answers when. It identifies one point in a pipeline: pretraining has
finished, and no further training has happened.
Figure 4. Base names a point in the pipeline; foundation names what the family is used for.
Why a model comes in a family
Neither term names one artefact, in practice. A single pretraining run gives
rise to a group of released models: the base checkpoint, one or more
instruction-following versions, a version tuned for conversation and safety, and
often several sizes of each.
A company’s foundation-model name usually covers that whole group, and the
version you reach through a chat interface or an API is one member of it. Two of those members can behave quite differently while
sharing all of their pretraining, which is worth knowing when you compare
results and find you were not using the same thing
twice (see also the Choosing a model chapter, in the Using LLMs module) (voir aussi le chapitre Choisir un modèle, dans le module Utiliser les GML).
The consequence for their own work: two members of one family can behave quite
differently while sharing all of their pretraining, which is worth knowing when
a comparison gives odd results and it turns out the same thing was not being
used twice.
What happens to the training text
Nothing left to consult
Once pretraining ends, the corpus is gone: not shipped with the model, not
consultable, no article to reread and no document to retrieve. Everything it has
is in its parameters, as numbers.
The corpus also stopped somewhere. Whatever text went into it was gathered up to
a point in time, and nothing after that reached the model during training.
Systems that do search
Many systems you use do search. A chat assistant that browses the web, or that
answers from documents you upload, is running a search and putting the results
into its context before it answers. That search is a separate component around
the model, and the retrieved text arrives the way your own prompt does.
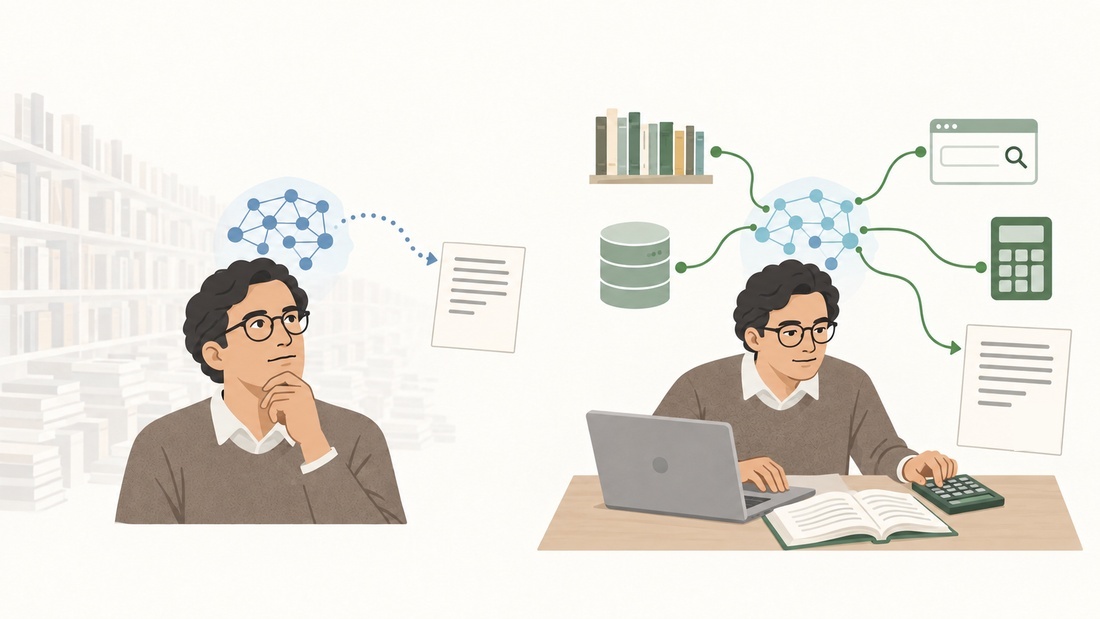
Figure 5. Left: the model on its own, with everything it read faded out behind it. Right: the same model with a search, a database and a calculator attached. Image generated withImage générée avec ChatGPT 5.6 Sol.
The promptLa requête
I want to generate a figure to illustrate how an LLM, without access to tools, might be compared to a human who has read a lot but no longer has access to all of the books they have read: you hope they are able to give a reasonable answer, but they cannot ground it in the resources. The point is to make clear that LLMs cannot look something up in a database: they construct from learned connections. Versus an LLM with tool use is like that same person, but now also with access to a library and internet and a calculator etc. to check its answers. Draft in a simple and clean style, without border lines and with soft colours. This is for academic purposes, so do not make it cutesy or spectacular: focus on accurate and illustrative.
Verbatim reproduction does happen all the same. Text repeated many times across
the corpus can be learned closely enough to come back out word for word, and
Nasr et al. (2025) showed that a deliberate attack can make a production model
emit training data at a far higher rate than ordinary use produces.
What happens to the training text
Learned parameters, not stored data
patterns and associations, not the text: the corpus is far bigger than
the model
text repeated many times can still come back out word for word
The illustration is the reader-with-the-books-put-away comparison from the
page, with its limit: it treats the model as a reader, which it is not. Say
the search half aloud from it: a browsing assistant runs a search around the
model, and what it finds arrives the way a prompt does. For the last bullet,
Nasr et al. (2025) is the evidence: a deliberate attack makes a production
model emit training data far more often than ordinary use does.
On prend un passage du corpus. On montre le début au modèle et on lui demande
quel jeton vient ensuite. Il produit ses probabilités, qui sont comparées au
jeton qui suivait réellement. Si le bon jeton a reçu une probabilité faible, les
paramètres sont ajustés de sorte que le même contexte pousse ce jeton un peu plus
haut la prochaine fois.
Figure 1. Un tour de la boucle, et ce que change un grand nombre de tours : au début le modèle préfère for, et il finit par préférer dog.
Chaque ajustement est minuscule. Un modèle utilisable naît de leur nombre, sur un
corpus de milliers de milliards de jetons.
Pourquoi le corpus n’a pas besoin d’étiquettes
Le préentraînement n’est abordable que parce que le corpus n’a besoin d’aucune
annotation. Chaque position de chaque phrase est un exercice tout prêt : cacher
le jeton suivant, le prédire, le découvrir, comparer. Le texte est à la fois la
question et le corrigé, si bien qu’on peut entraîner un modèle sur mille
milliards de jetons de texte brut tiré du Web sans que personne n’annote un seul
exemple.
Les décisions humaines se concentrent dans la constitution du corpus et le choix
de ce qui y entre. L’entraînement lui-même est une seule opération arithmétique,
répétée jusqu’à épuisement du budget.
La boucle d'entraînement
Parcourir la boucle une fois avec la phrase du renard, puis les deux groupes
de barres : au début, le modèle met 85 % sur « for » et 10 % sur « dog » ;
après de nombreux passages, c’est l’inverse. Ce déplacement, c’est ce que veut
dire « apprendre » ici, et les pourcentages sont illustratifs. Puis le point
que fait la définition : le corpus n’a besoin d’aucune annotation, parce que
le jeton suivant est déjà là.
Qui peut se permettre un préentraînement
Ce que coûte un grand entraînement
Entraîner le plus grand des modèles Llama 3 a mobilisé jusqu’à 16 000
processeurs graphiques (GPU), chacun consommant 700 watts (Grattafiori et al.,
2024).
Epoch AI (2026) estime cet entraînement à environ 89 jours et 53 millions de
dollars américains.
Figure 2. Chiffres tirés d'Epoch AI (2026).
Ce qui est fixé avant un entraînement, et ce qui ne l’est pas
Le budget est fixé avant que quoi que ce soit ne commence, tout comme
l’architecture du modèle et son nombre de paramètres. Répartir ce budget entre
la taille du modèle et la quantité de texte qu’il lit est la question de
conception qui le sous-tend (Kaplan et al., 2020 ; Hoffmann et al., 2022).
Le texte lui-même n’est pas fixé. Grattafiori et al. (2024) rapportent avoir
augmenté la part de données non anglaises en cours de préentraînement de
Llama 3, pour améliorer le modèle dans les autres langues, et avoir écarté des
sources qu’ils avaient fini par juger de mauvaise qualité. L’entraînement ne se
déroule pas non plus d’une traite : à cette taille, le matériel tombe en panne,
et l’entraînement reprend à partir de la dernière copie sauvegardée des nombres
du modèle, un point de contrôle (angl. checkpoint).
Combien d’organisations préentraînent
Très peu, et ce sont quelques entreprises et laboratoires bien financés, aux
États-Unis et en Chine, ce qui concentre une grande influence sur ce que ces
systèmes lisent et sur leur
comportement (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML). Une entreprise qui publie
plusieurs modèles dans une année ne préentraîne généralement pas plusieurs fois :
les variantes sortent d’un seul entraînement, adaptées ensuite par les étapes
moins coûteuses qui suivent (see also the Fine-tuning chapter) (voir aussi le chapitre Affinage).
Qui peut se permettre un préentraînement
Ce qui est fixé avant un entraînement, et ce qui ne l’est pas
fixé d’avance : le budget de calcul, l’architecture, le nombre de
paramètres
piloté en cours de route : le mélange de textes, la part de non-anglais
relevée en cours de route pour Llama 3
pas d’une traite : le matériel tombe en panne, l’entraînement reprend au
dernier point de contrôle
Qui peut se permettre un préentraînement
Combien d’organisations préentraînent
très peu : quelques entreprises et laboratoires bien financés, aux
États-Unis et en Chine
une entreprise qui publie plusieurs modèles par année ne préentraîne
généralement pas plusieurs fois
personne de l’extérieur ne peut refaire un entraînement pour le vérifier
La figure d’abord, et le point à en tirer : les deux entraînements les plus
coûteux sont ceux dont personne de l’extérieur ne peut établir le chiffre, et
les barres en pointillés le disent. Le plus grand modèle Llama 3 : jusqu’à
16 000 GPU à 700 watts chacun, environ 89 jours, environ 53 millions de
dollars.
Ce que fait un modèle de base
Poser une question à un modèle de base
Quand vous faites compléter What is the capital of France? à un modèle de
base, il peut générer Paris, ou prolonger le texte autrement, par exemple
what is the capital of Germany?
Le modèle fait ce pour quoi il a été entraîné : prolonger le texte donné de
façon plausible. Et il existe certainement des sources en ligne où cette question
est suivie d’autres questions plutôt que d’une réponse. Pour que le modèle se
comporte en assistant utile, il faut un entraînement
supplémentaire (see also the Fine-tuning chapter) (voir aussi le chapitre Affinage).
Figure 3. La même phrase, donnée à un modèle de base et à un modèle affiné (Yang et al., 2025b). Les interfaces disent déjà à quoi sert chacun : une boîte qui prolonge du texte, et une fenêtre à laquelle on parle. Captures de 2025, en anglais ; ces interfaces changent.
Un modèle de base passe aussi d’un registre à l’autre au sein d’une même
réponse, pour la même raison : il prolonge un article de presse, puis glisse
vers quelque chose qui ressemble à une réponse de forum, puis vers ce qui
ressemble à du code, parce que rien ne lui a dit où finit une réponse ni quelle
voix garder.
Les connaissances sont là, mais difficiles à atteindre
Le modèle a lu bien des textes sur la géographie de la France, et l’association
est dans ses paramètres. La difficulté est de l’atteindre de façon fiable : il
faudrait écrire une requête qui fasse de la réponse la suite la plus probable,
par exemple en commençant vous-même le texte.
The capital of France is
C’est une vraie technique. Mais comme elle est moins intuitive, les modèles de
base sont rarement offerts au public. La plupart des familles ouvertes ne
publient qu’une version qui suit les instructions, et seules certaines offrent
aussi le point de contrôle du modèle de base : Meta a publié Llama 3 à la fois
en version préentraînée et en version postentraînée du même modèle (Grattafiori
et al., 2024). Les modèles derrière ChatGPT et Claude ne sont pas publiés du
tout.
La capture est en anglais. Le modèle de base fait ce pour quoi il a été
entraîné, prolonger le texte de façon plausible, et il existe des sources en
ligne où une question est suivie d’autres questions. Puis l’autre moitié : les
connaissances sont là, mais difficiles à atteindre, et commencer soi-même le
texte (« The capital of France is ») est une vraie technique. Les modèles
derrière ChatGPT et Claude ne sont jamais publiés.
Modèles de base et modèles de fondation
La différence entre base et fondation
Les deux termes s’emploient comme s’ils étaient interchangeables, et ils
répondent à des questions différentes sur un modèle.
De base répond à la question quand. Il désigne un point d’une chaîne : le
préentraînement est terminé, et aucun autre entraînement n’a eu lieu.
Figure 4. De base nomme un point de la chaîne ; de fondation nomme ce à quoi sert la famille.
Pourquoi un modèle vient en famille
En pratique, aucun des deux termes ne nomme un seul objet. Un seul
préentraînement donne naissance à un groupe de modèles publiés : le point de
contrôle de base, une ou plusieurs versions qui suivent les instructions, une
version ajustée pour la conversation et la sécurité, et souvent plusieurs
tailles de chacune.
Le nom de modèle de fondation d’une entreprise couvre généralement tout ce
groupe, et la version que vous atteignez par une interface de conversation ou
une API en est un membre. Deux de ces membres peuvent se comporter très
différemment tout en partageant tout leur préentraînement, ce qui vaut la peine
d’être su quand vous comparez des résultats et découvrez que vous n’utilisiez
pas deux fois la même chose (see also the Choosing a model chapter, in the Using LLMs module) (voir aussi le chapitre Choisir un modèle, dans le module Utiliser les GML).
Ce ne sont pas les mêmes ensembles : une application est généralement
construite sur un modèle postentraîné, pas sur le point de contrôle de base.
La conséquence pour leur propre travail : deux membres d’une même famille
peuvent se comporter très différemment tout en partageant tout leur
préentraînement, ce qui compte quand une comparaison donne des résultats
bizarres et qu’on découvre qu’on n’utilisait pas deux fois la même chose.
Ce qu'il advient du texte d'entraînement
Plus rien à consulter
Une fois le préentraînement terminé, le corpus a disparu : il n’est pas livré
avec le modèle, il n’est pas consultable, il n’y a aucun article à relire ni
aucun document à récupérer. Tout ce que le modèle possède est dans ses
paramètres, sous forme de nombres.
Le corpus s’est aussi arrêté quelque part. Le texte qui y est entré a été
rassemblé jusqu’à un moment donné, et rien de postérieur n’est parvenu au modèle
pendant l’entraînement.
Les systèmes qui font des recherches
Bien des systèmes que vous utilisez font, eux, des recherches. Un assistant
conversationnel qui navigue sur le Web, ou qui répond à partir de documents que
vous téléversez, lance une recherche et met les résultats dans son contexte avant de
répondre. Cette recherche est un composant distinct, autour du modèle, et le
texte récupéré lui parvient comme votre propre requête.
Figure 5. À gauche : le modèle seul, avec tout ce qu'il a lu estompé derrière lui. À droite : le même modèle avec une recherche, une base de données et une calculatrice branchées. Image generated withImage générée avec ChatGPT 5.6 Sol.
The promptLa requête
I want to generate a figure to illustrate how an LLM, without access to tools, might be compared to a human who has read a lot but no longer has access to all of the books they have read: you hope they are able to give a reasonable answer, but they cannot ground it in the resources. The point is to make clear that LLMs cannot look something up in a database: they construct from learned connections. Versus an LLM with tool use is like that same person, but now also with access to a library and internet and a calculator etc. to check its answers. Draft in a simple and clean style, without border lines and with soft colours. This is for academic purposes, so do not make it cutesy or spectacular: focus on accurate and illustrative.
Des paramètres appris, pas des données stockées
Le corpus est de plusieurs ordres de grandeur plus gros que le modèle, si bien
que ses paramètres gardent des régularités et des associations plutôt que le
texte lui-même (see also the LLMs as next-word predictors chapter) (voir aussi le chapitre Les GML, prédicteurs du mot suivant).
La reproduction mot pour mot se produit tout de même. Un texte répété de
nombreuses fois dans le corpus peut être appris d’assez près pour ressortir mot
pour mot, et Nasr et al. (2025) ont montré qu’une attaque délibérée peut
amener un modèle en production à émettre des données d’entraînement à un taux
bien plus élevé que l’usage ordinaire n’en produit.
Ce qu'il advient du texte d'entraînement
Des paramètres appris, pas des données stockées
des régularités et des associations, pas le texte : le corpus est bien
plus gros que le modèle
un texte répété de nombreuses fois peut tout de même ressortir mot
pour mot
L’illustration, c’est la comparaison de la page avec la personne qui a
beaucoup lu mais dont les livres sont rangés, avec sa limite : elle traite le
modèle comme un lecteur, ce qu’il n’est pas. Dire la moitié « recherche » à
partir de l’image : un assistant qui navigue lance une recherche autour du
modèle, et ce qu’il trouve arrive comme une requête. Pour la dernière puce,
Nasr et al. (2025) est la preuve : une attaque délibérée fait émettre à un
modèle en production des données d’entraînement bien plus souvent que l’usage
ordinaire.
The page behind this slideLa page derrière cette diapositive
1 / 2The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter