This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
TRA6008 · Parcours en ligneTRA6008 · Parcours en ligne
Parcours d'apprentissage en ligneParcours d'apprentissage en ligne
TRA6008 · Parcours en ligneTRA6008 · Parcours en ligne
Parcours d'apprentissage en ligneParcours d'apprentissage en ligne
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Speech: exercisesParole : exercices
Speech technologyLes technologies de la parole
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Speech technologyLes technologies de la parole
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Three families of speech technologyTrois familles de technologies de la parole
Translating speech: cascade or end-to-endTraduire la parole : en cascade ou de bout en bout
Measuring speech recognition qualityMesurer la qualité de la reconnaissance
Speed vs. quality: live, offline and simultaneousVitesse contre qualité : en direct, en différé et en simultané
What affects speech recognition qualityCe qui influence la qualité de la reconnaissance
Speech technology in the language professionsLes technologies de la parole dans les professions langagières
Speech: exercisesParole : exercices
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
(speech-to-text) turns a voice into written text, (text-to-speech) does the reverse, and turns speech in one language into speech in another.
La (de la parole au texte) transforme une voix en texte écrit, la (du texte à la parole) fait l'inverse, et la transforme une parole dans une langue en parole dans une autre.
automatic speech recognition (ASR) · fr: reconnaissance automatique de la parole reconnaissance automatique de la parole (RAP) · en : automatic speech recognition speechparole : Technology that analyses the human voice captured by a microphone and transcribes it into machine-readable text; also called speech-to-text (STT).Technologie qui analyse la voix humaine captée au moyen d'un microphone pour la transcrire sous la forme d'un texte exploitable par une machine ; aussi appelée transcription de la parole en texte (angl. speech-to-text, STT).
speech synthesis (TTS) · fr: synthèse de la parole synthèse de la parole · en : speech synthesis speechparole : The generation of artificial speech from written text (text-to-speech), combining linguistic processing to derive a pronounceable phonetic form with signal processing to render it as audio; the inverse of automatic speech recognition.Production de parole artificielle à partir de n'importe quel texte (angl. text-to-speech, TTS), combinant un traitement linguistique, qui transforme le texte en une forme phonétique prononçable, et un traitement du signal, qui transforme cette forme en son ; l'inverse de la reconnaissance automatique de la parole.
speech-to-speech translation (S2ST) · fr: traduction parole à parole traduction parole à parole · en : speech-to-speech translation speechparole : The conversion of spoken input in one language into spoken output in another language, either by chaining speech recognition, machine translation and speech synthesis (cascade) or by a single end-to-end model.Conversion d'un énoncé oral dans une langue en énoncé oral dans une autre langue, soit en enchaînant reconnaissance de la parole, traduction automatique et synthèse de la parole (cascade), soit par un modèle unique de bout en bout.
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
The cascade approach chains the three stages, and each of them can go wrong; the end-to-end approach translates the audio directly, which can preserve the voice and reduce .
L'approche en cascade enchaîne les trois étapes, et chacune peut se tromper ; l'approche de bout en bout traduit l'audio directement, ce qui peut préserver la voix et réduire la .
latency · fr: latence latence · en : latency speechparole : The delay between an input and the system's response; in live speech recognition and interpreting, the time between the spoken words and their displayed transcription or translation.Délai entre une entrée et la réponse du système ; en reconnaissance de la parole en direct et en interprétation, temps qui s'écoule entre les mots prononcés et l'affichage de leur transcription ou de leur traduction.
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
For any speech technology, there is a trade-off between speed and quality.
Pour toute technologie de la parole, il y a un compromis entre la vitesse et la qualité.
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
(WER) measures how often errors occur, not how serious they are: one wrong word can change an amount or a name.
Le (WER) mesure la fréquence des erreurs, pas leur gravité : un seul mot erroné peut changer un montant ou un nom.
word error rate (WER) · fr: taux d'erreur de mots taux d'erreur de mots · en : word error rate speechparole : The standard metric of speech recognition quality: the proportion of substituted, deleted and inserted words in the automatic transcript relative to the number of words in a human reference; it measures how frequent errors are, not how serious.Indicateur standard de la qualité d'une reconnaissance de la parole : proportion de mots substitués, supprimés et insérés dans la transcription automatique par rapport au nombre de mots d'une référence humaine ; il mesure la fréquence des erreurs, pas leur gravité.
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Quality depends on the signal (microphone, noise), the content (accents, terminology, entities) and the processing mode, and most of that is partly under your control.
La qualité dépend du signal (micro, bruit), du contenu (accents, terminologie, entités) et du mode de traitement, et une bonne part se contrôle.
Key pointsL'essentiel
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Dictation does not automatically make translation faster, and it is automatic interpreting rather than a computer-assisted interpreting tool that replaces an interpreter.
La dictée n'accélère pas automatiquement la traduction, et c'est l'interprétation automatique, non l'outil d'interprétation assistée par ordinateur, qui remplace une interprète.
Page 1Page 1
Three families of speech technologyTrois familles de technologies de la parole
(or speech-to-text) turns a voice into written text.
(or text-to-speech) generates a spoken version of written text.
turns speech in one language into speech in another, either by chaining the two with or with a single end-to-end model.
For any speech technology, there is a trade-off between speed and quality.
La (de la parole au texte) transforme une voix en texte écrit.
La (du texte à la parole) génère une version orale d'un texte écrit.
La transforme une parole dans une langue en parole dans une autre, soit en enchaînant les deux avec la , soit au moyen d'un seul modèle de bout en bout.
Pour toute technologie de la parole, il y a un compromis entre la vitesse et la qualité.
automatic speech recognition (ASR) · fr: reconnaissance automatique de la parole reconnaissance automatique de la parole (RAP) · en : automatic speech recognition speechparole : Technology that analyses the human voice captured by a microphone and transcribes it into machine-readable text; also called speech-to-text (STT).Technologie qui analyse la voix humaine captée au moyen d'un microphone pour la transcrire sous la forme d'un texte exploitable par une machine ; aussi appelée transcription de la parole en texte (angl. speech-to-text, STT).
speech synthesis (TTS) · fr: synthèse de la parole synthèse de la parole · en : speech synthesis speechparole : The generation of artificial speech from written text (text-to-speech), combining linguistic processing to derive a pronounceable phonetic form with signal processing to render it as audio; the inverse of automatic speech recognition.Production de parole artificielle à partir de n'importe quel texte (angl. text-to-speech, TTS), combinant un traitement linguistique, qui transforme le texte en une forme phonétique prononçable, et un traitement du signal, qui transforme cette forme en son ; l'inverse de la reconnaissance automatique de la parole.
speech-to-speech translation (S2ST) · fr: traduction parole à parole traduction parole à parole · en : speech-to-speech translation speechparole : The conversion of spoken input in one language into spoken output in another language, either by chaining speech recognition, machine translation and speech synthesis (cascade) or by a single end-to-end model.Conversion d'un énoncé oral dans une langue en énoncé oral dans une autre langue, soit en enchaînant reconnaissance de la parole, traduction automatique et synthèse de la parole (cascade), soit par un modèle unique de bout en bout.
machine translation (MT) · fr: traduction automatique traduction automatique (TA) · en : machine translation translationtraduction : The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source.
Page 2Page 2
Translating speech: cascade or end-to-endTraduire la parole : en cascade ou de bout en bout
The cascade approach chains recognition, machine translation and synthesis; each stage can pass its errors on to the next.
The end-to-end approach translates the audio directly; it can preserve the voice and reduce , but it covers fewer language pairs.
L'approche en cascade enchaîne reconnaissance, traduction automatique et synthèse ; chaque étape peut propager ses erreurs à la suivante.
L'approche de bout en bout traduit l'audio directement ; elle peut préserver la voix et réduire la , mais couvre moins de paires de langues.
latency · fr: latence latence · en : latency speechparole : The delay between an input and the system's response; in live speech recognition and interpreting, the time between the spoken words and their displayed transcription or translation.Délai entre une entrée et la réponse du système ; en reconnaissance de la parole en direct et en interprétation, temps qui s'écoule entre les mots prononcés et l'affichage de leur transcription ou de leur traduction.
Page 3Page 3
Measuring speech recognition qualityMesurer la qualité de la reconnaissance
(WER) compares an automatic transcription against a human reference and counts three kinds of error: substitutions, deletions, insertions.
A WER of 5% means one word in twenty is wrong on average; the metric says nothing about how serious those errors are.
Performance varies widely with the recording conditions and with the speaker.
Le (WER) compare la transcription automatique à une référence humaine et compte trois types d'erreurs : substitutions, suppressions, insertions.
Un WER de 5 % signifie en moyenne un mot erroné sur vingt ; la métrique ne dit rien de la gravité de ces erreurs.
La performance varie fortement selon les conditions d'enregistrement et selon les locuteurs.
word error rate (WER) · fr: taux d'erreur de mots taux d'erreur de mots · en : word error rate speechparole : The standard metric of speech recognition quality: the proportion of substituted, deleted and inserted words in the automatic transcript relative to the number of words in a human reference; it measures how frequent errors are, not how serious.Indicateur standard de la qualité d'une reconnaissance de la parole : proportion de mots substitués, supprimés et insérés dans la transcription automatique par rapport au nombre de mots d'une référence humaine ; il mesure la fréquence des erreurs, pas leur gravité.
Page 4Page 4
Speed vs. quality: live, offline and simultaneousVitesse contre qualité : en direct, en différé et en simultané
In speech technology, there is always a trade-off between speed and quality: waiting for more context buys a better result at the cost of .
En technologie de la parole, il y a toujours un compromis entre la vitesse et la qualité : attendre plus de contexte achète un meilleur résultat au prix de la .
latency · fr: latence latence · en : latency speechparole : The delay between an input and the system's response; in live speech recognition and interpreting, the time between the spoken words and their displayed transcription or translation.Délai entre une entrée et la réponse du système ; en reconnaissance de la parole en direct et en interprétation, temps qui s'écoule entre les mots prononcés et l'affichage de leur transcription ou de leur traduction.
Page 5Page 5
What affects speech recognition qualityCe qui influence la qualité de la reconnaissance
Three groups of factors determine quality: the signal captured, the linguistic content, and the processing mode.
Critical entities (numbers, proper nouns, acronyms) are where the high-impact errors concentrate; stays fragile when voices overlap.
Most of these factors are partly under your control: microphone, environment, speaking rate, terminology preparation.
Trois groupes de facteurs déterminent la qualité : le signal capté, le contenu linguistique et le mode de traitement.
Les entités critiques (nombres, noms propres, sigles) concentrent les erreurs à fort impact ; la reste fragile quand les voix se chevauchent.
La plupart de ces facteurs se contrôlent en partie : micro, environnement, débit, préparation terminologique.
speaker diarization · fr: diarisation diarisation · en : speaker diarization speechparole : The automatic segmentation of an audio recording by speaker: determining who speaks when, so that each stretch of speech is attributed to the right person.Segmentation automatique d'un enregistrement audio par locuteur : déterminer qui parle quand, afin d'attribuer chaque segment de parole à la bonne personne.
Page 6Page 6
Speech technology in the language professionsLes technologies de la parole dans les professions langagières
Dictation does not automatically make translation faster: the time saved while drafting can go back into revision.
Computer-assisted interpreting tools support interpreters the way CAT tools support translators, whereas automatic interpreting can replace them in some settings.
and automatic dubbing are changing video localization; ideally a person checks the output.
La dictée n'accélère pas automatiquement la traduction : le temps gagné à la rédaction peut repartir dans la révision.
Les outils d'interprétation assistée par ordinateur soutiennent l'interprète comme un outil de TAO soutient un traducteur, alors que l'interprétation automatique peut le remplacer dans certains contextes.
Le et le doublage automatique transforment la localisation vidéo ; idéalement, une personne vérifie le résultat.
voice cloning · fr: clonage vocal clonage vocal · en : voice cloning speechparole : The use of AI models to build a digital copy of a person's voice and generate new speech in that voice; unlike generic speech synthesis, the goal is to reproduce a specific speaker.Utilisation de modèles d'intelligence artificielle pour créer une copie numérique de la voix d'une personne et générer de nouveaux énoncés avec cette voix ; contrairement à la synthèse de la parole générique, l'objectif est de reproduire un locuteur précis.
Speech technologyLes technologies de la parole
Speech: exercisesParole : exercices
Speech technologyLes technologies de la parole
Speech: exercisesParole : exercices
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Speech: exercisesParole : exercices
Demo: dictation in WordDémo : la dictée dans Word
Assignment: correcting a memo by voiceTravail : corriger un mémo à la voix
Demo: live captions in PowerPointDémo : sous-titres en direct dans PowerPoint
Assignment: captioning a presentationTravail : sous-titrer une présentation
Demo: video translation with HeyGenDémo : traduction vidéo avec HeyGen
Assignment: translating a videoTravail : traduire une vidéo
Key pointsL'essentiel
Speech: exercisesParole : exercices
Three demonstrations to run yourself: dictation in Word, automatic captioning in PowerPoint, and the translation of a video by HeyGen.
Trois démonstrations à faire vous-même : la dictée dans Word, le sous-titrage automatique dans PowerPoint, et la traduction d'une vidéo par HeyGen.
Key pointsL'essentiel
Speech: exercisesParole : exercices
They are there to let you judge what these tools give you and what they cost, on your own machine.
Elles servent à jauger ce que ces outils apportent et ce qu'ils coûtent, sur votre propre machine.
Page 1Page 1
Demo: dictation in WordDémo : la dictée dans Word
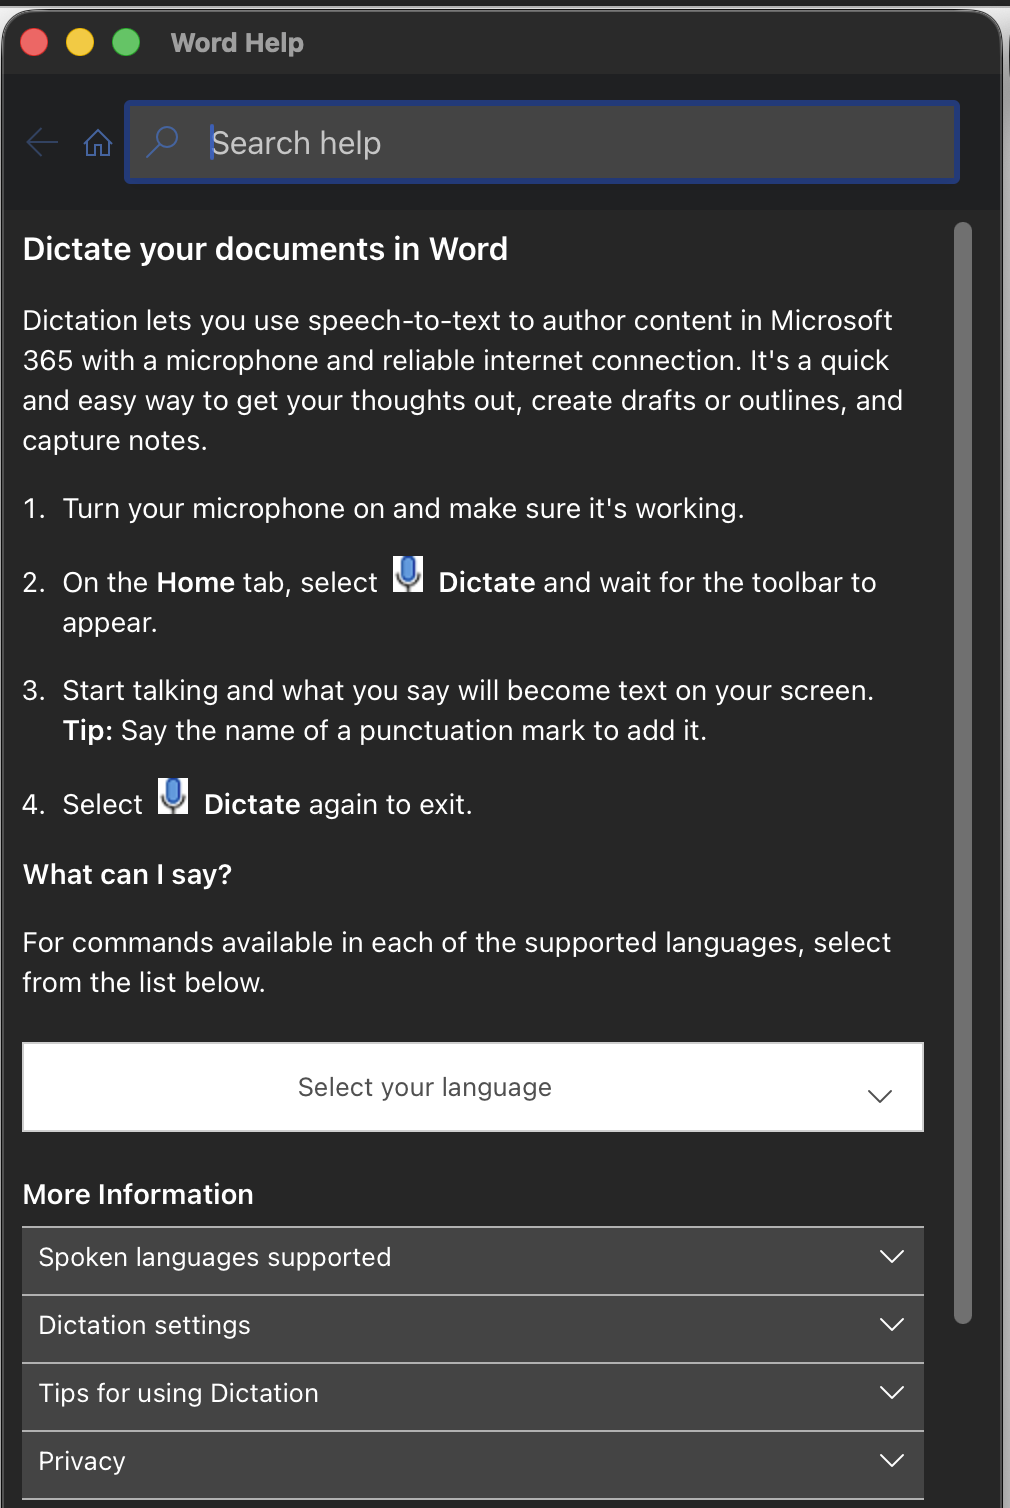
You dictate and correct a text in Word by voice alone: punctuation, corrections, additions, formatting.
The exercise is done in English, where voice commands are the most complete.
Vous dictez et corrigez un texte dans Word uniquement à la voix : ponctuation, corrections, ajouts, mise en forme.
L'exercice se fait en anglais, dont les commandes vocales sont les plus complètes.
Page 1Page 1
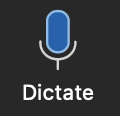
Figure 1. The Dictate button Figure 1. Le bouton Dicter
Page 1Page 1
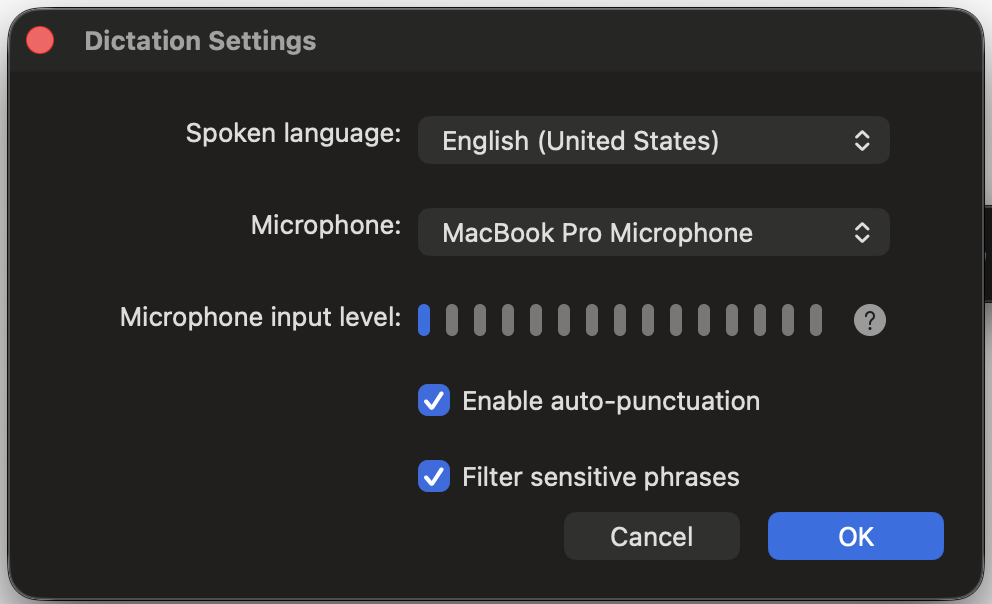
Figure 2. The settings of Word's Dictate feature Figure 2. Paramètres de la fonction Dicter dans Word
Page 1Page 1
Figure 3. Where the Dictate button sits on the Word ribbon (Home tab) Figure 3. Emplacement du bouton Dicter dans le ruban Word (onglet Accueil)
Page 1Page 1
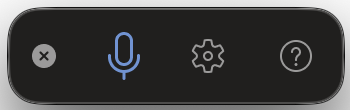
Figure 4. The floating toolbar of the Dictate feature Figure 4. La barre d'outils flottante de la fonction Dicter
Page 1Page 1
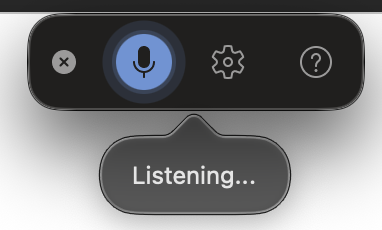
Figure 5. The same toolbar while dictation is running Figure 5. La même barre pendant que la dictée tourne
Page 1Page 1
Figure 6. The (?) button on the toolbar opens Word's own help, where the command list is given per language Figure 6. Le bouton (?) de la barre ouvre l'aide de Word, où la liste des commandes est donnée par langue
Page 3Page 3
Demo: live captions in PowerPointDémo : sous-titres en direct dans PowerPoint
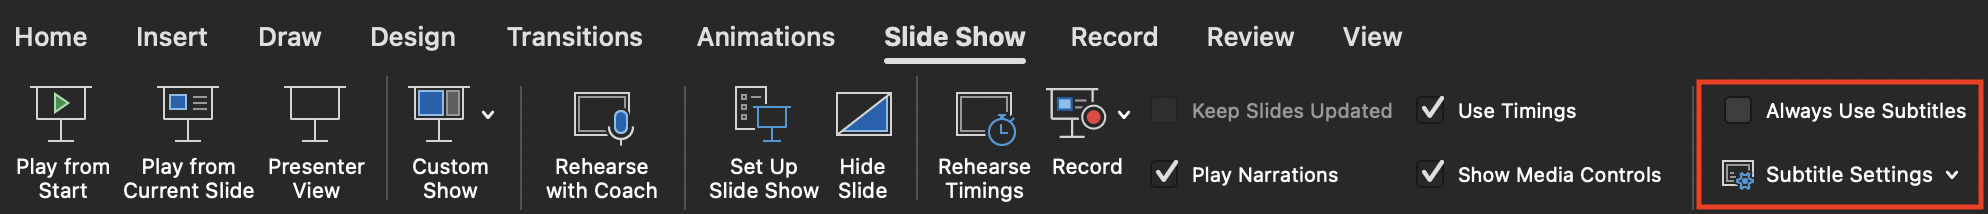
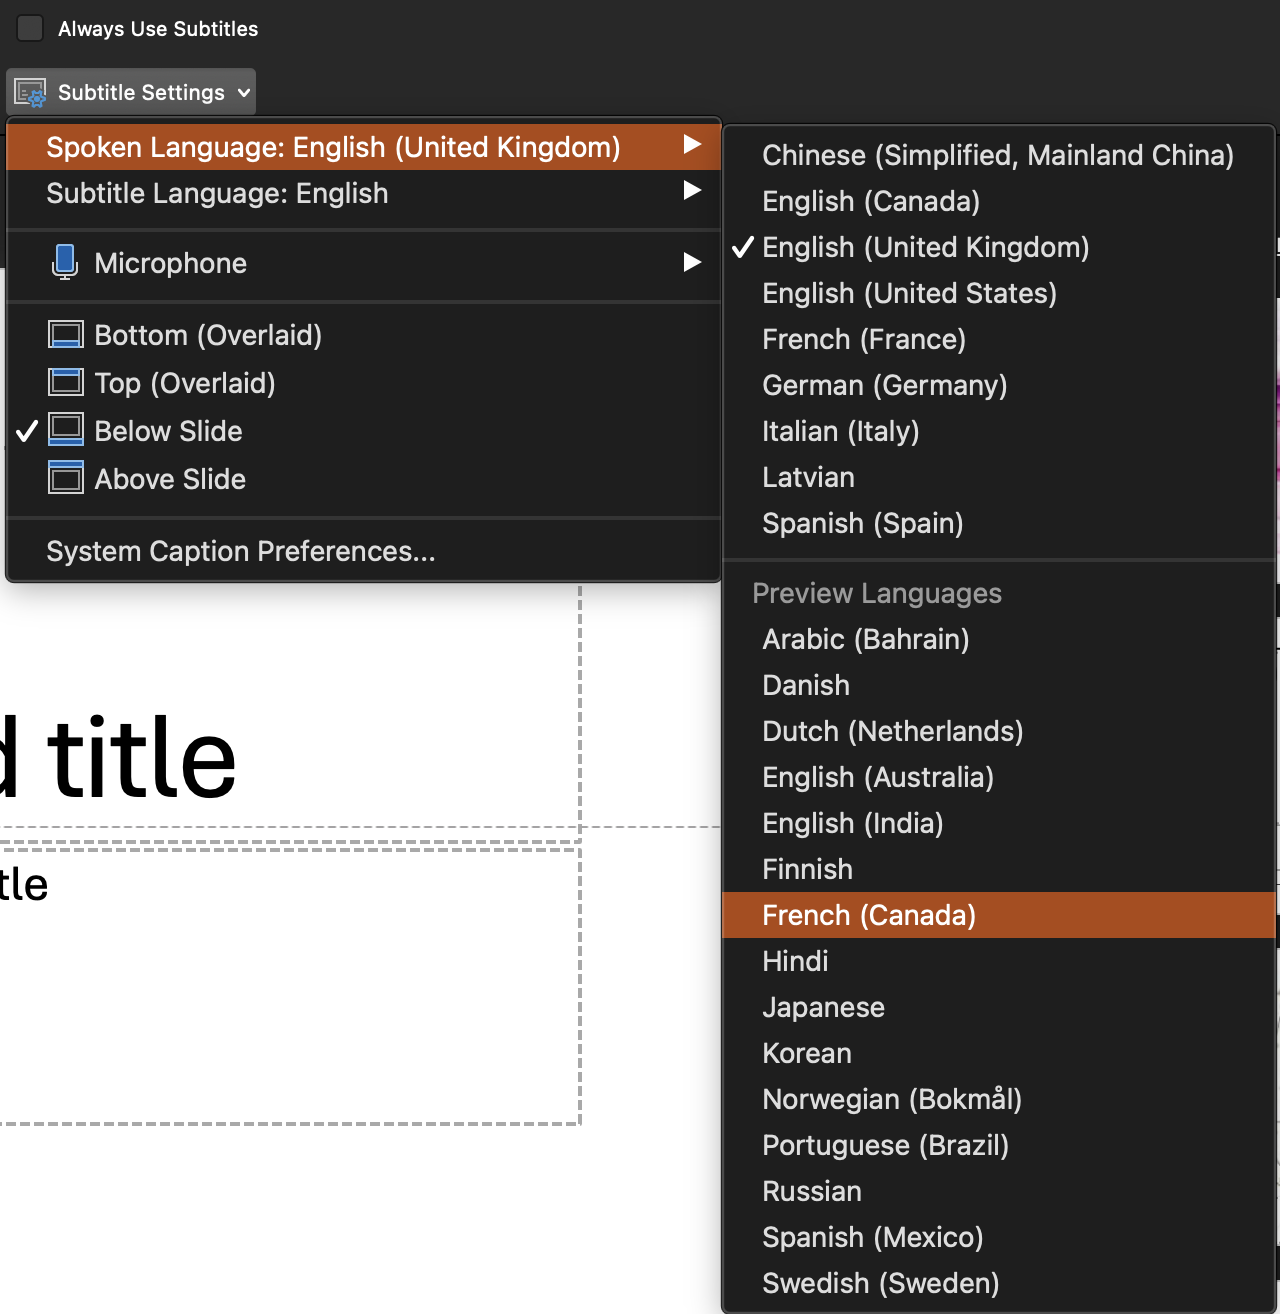
PowerPoint transcribes your presentation live and can translate the captions into another language while you speak.
You test two conditions: monolingual captioning (French to French), then live translation (French to English).
The slides whose text has been turned into an image show what recognition is worth with no contextual help.
PowerPoint transcrit votre présentation en direct et peut traduire les sous-titres dans une autre langue pendant que vous parlez.
Vous testez deux conditions : sous-titrage monolingue (français → français), puis traduction en direct (français → anglais).
Les diapositives dont le texte est converti en image montrent ce que vaut la reconnaissance sans aide contextuelle.
Page 3Page 3
Figure 7. The subtitle options on the Slide Show tab of the PowerPoint ribbon Figure 7. Les options de sous-titres dans l'onglet Diaporama du ruban PowerPoint
Page 3Page 3
Figure 8. Subtitle settings: spoken language, subtitle language, position, microphone Figure 8. Paramètres de sous-titres : langue parlée, langue des sous-titres, position, microphone
Page 5Page 5
Demo: video translation with HeyGenDémo : traduction vidéo avec HeyGen
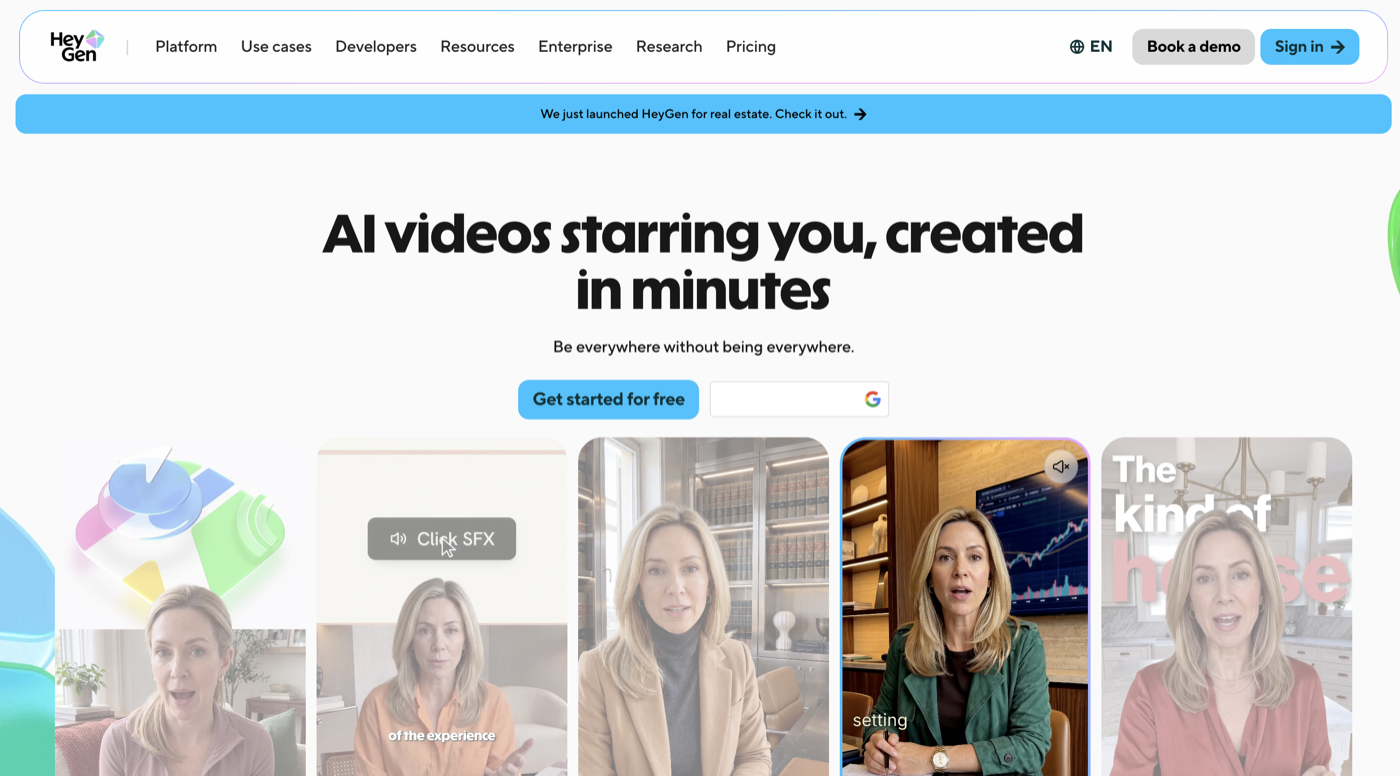
HeyGen translates a video by , with and lip synchronization; you assess the result on a short video.
On a free account, your data (face, voice, content) may be used to train HeyGen's models. Read the disclosure and decide whether you want to use the provided video or make one of your own.
HeyGen traduit une vidéo par , avec et synchronisation labiale ; vous évaluez le résultat sur une courte vidéo.
Avec un compte gratuit, vos données (visage, voix, contenu) peuvent servir à entraîner les modèles de HeyGen. Lisez la divulgation, puis décidez si vous utilisez la vidéo fournie ou si vous en faites une vous-même.
speech-to-speech translation (S2ST) · fr: traduction parole à parole traduction parole à parole · en : speech-to-speech translation speechparole : The conversion of spoken input in one language into spoken output in another language, either by chaining speech recognition, machine translation and speech synthesis (cascade) or by a single end-to-end model.Conversion d'un énoncé oral dans une langue en énoncé oral dans une autre langue, soit en enchaînant reconnaissance de la parole, traduction automatique et synthèse de la parole (cascade), soit par un modèle unique de bout en bout.
voice cloning · fr: clonage vocal clonage vocal · en : voice cloning speechparole : The use of AI models to build a digital copy of a person's voice and generate new speech in that voice; unlike generic speech synthesis, the goal is to reproduce a specific speaker.Utilisation de modèles d'intelligence artificielle pour créer une copie numérique de la voix d'une personne et générer de nouveaux énoncés avec cette voix ; contrairement à la synthèse de la parole générique, l'objectif est de reproduire un locuteur précis.
Page 5Page 5
Figure 9. On heygen.com, “Get started for free” or “Sign in” open the service. Figure 9. Sur heygen.com, « Get started for free » ou « Sign in » donnent accès au service.
Page 5Page 5
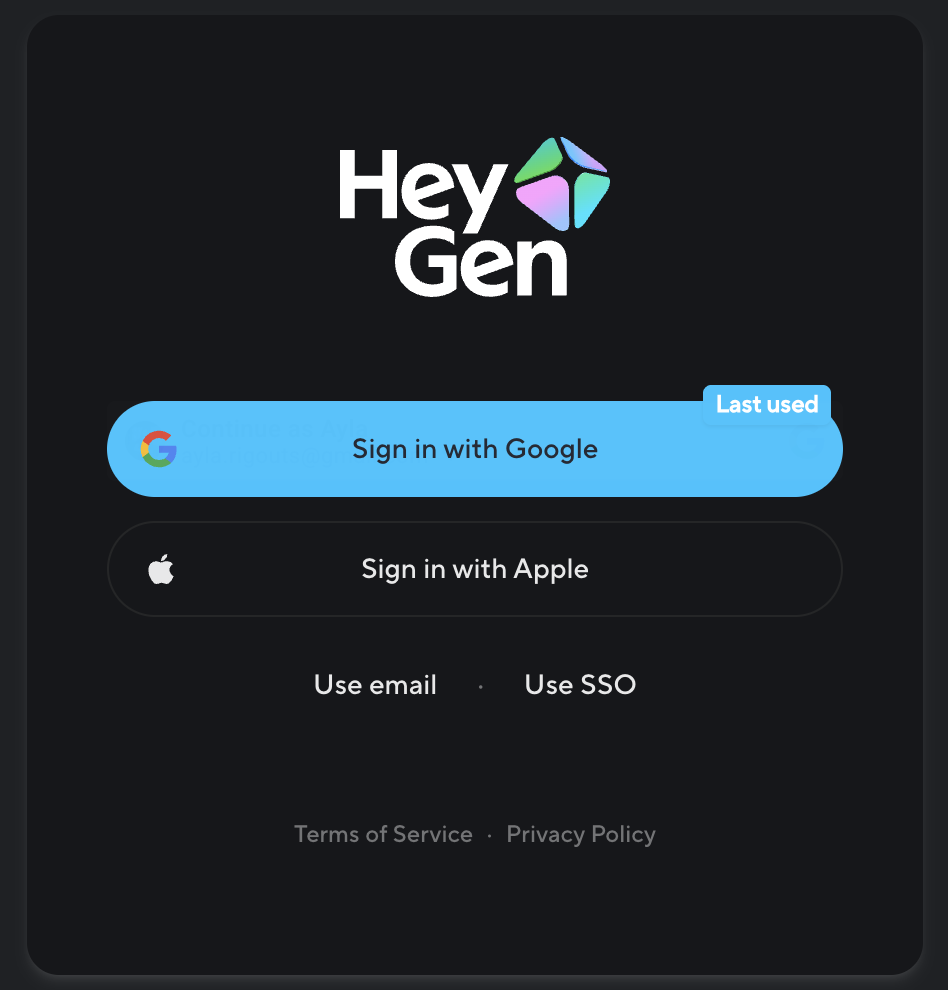
Figure 10. Signing in goes through Google, Apple, an email address (“Use email”) or an institutional account. Email avoids linking your Google or Apple account. Figure 10. L'authentification passe par Google, Apple, une adresse courriel (« Use email ») ou un compte institutionnel. Le courriel évite de lier votre compte Google ou Apple.
Page 5Page 5
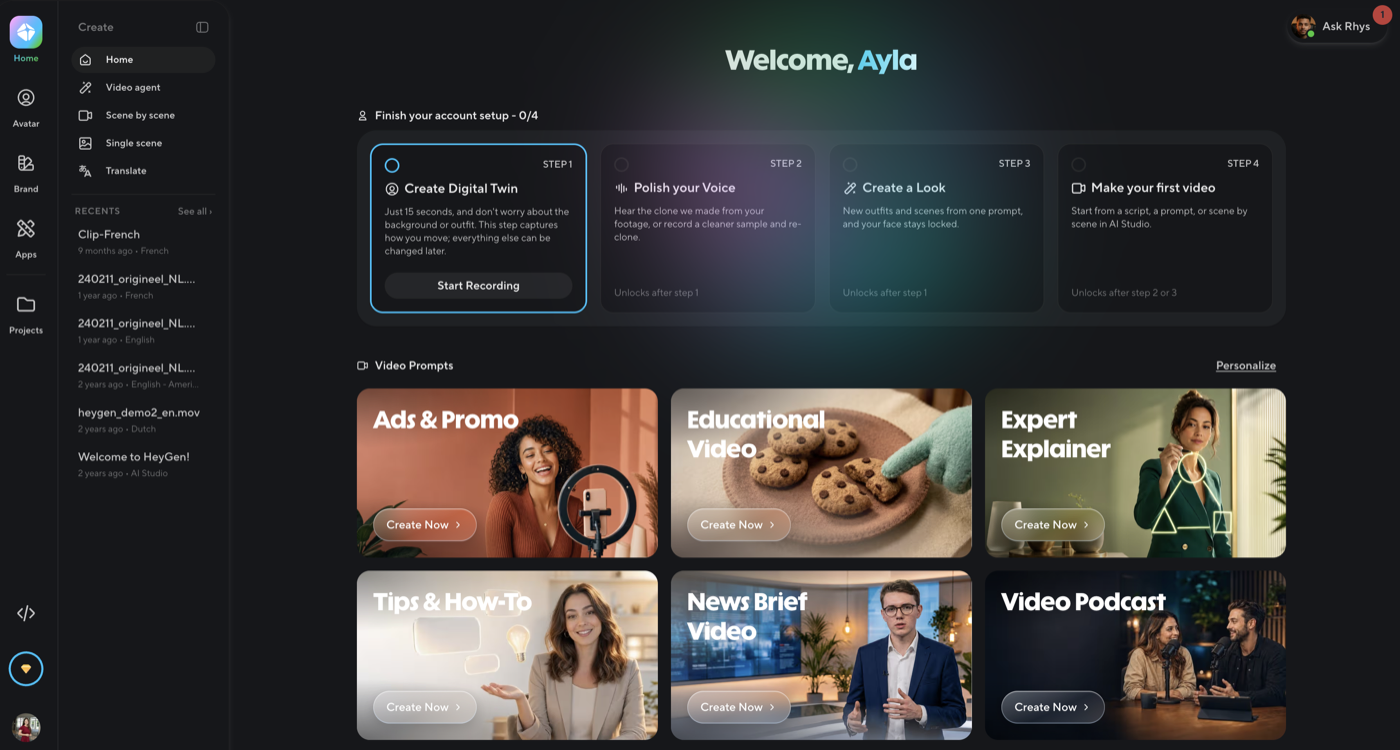
Figure 11. After signing in, the home screen is mostly about creating videos; translation sits in the menu on the left. Figure 11. Après la connexion, l'accueil propose surtout de créer des vidéos ; la traduction se trouve dans le menu de gauche.
Page 5Page 5
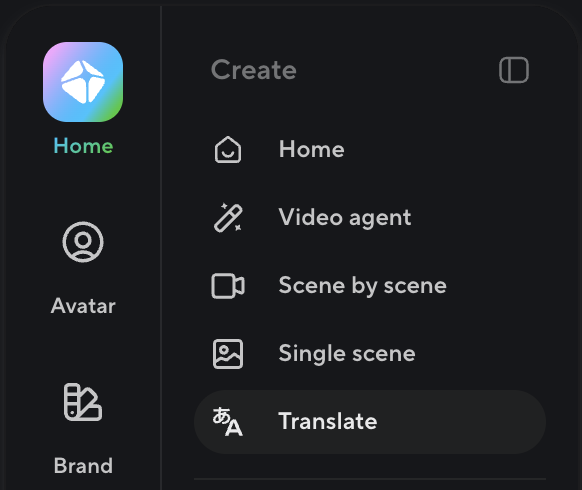
Figure 12. In the Create menu, choose Translate. Figure 12. Dans le menu Create, choisissez Translate.
Page 5Page 5
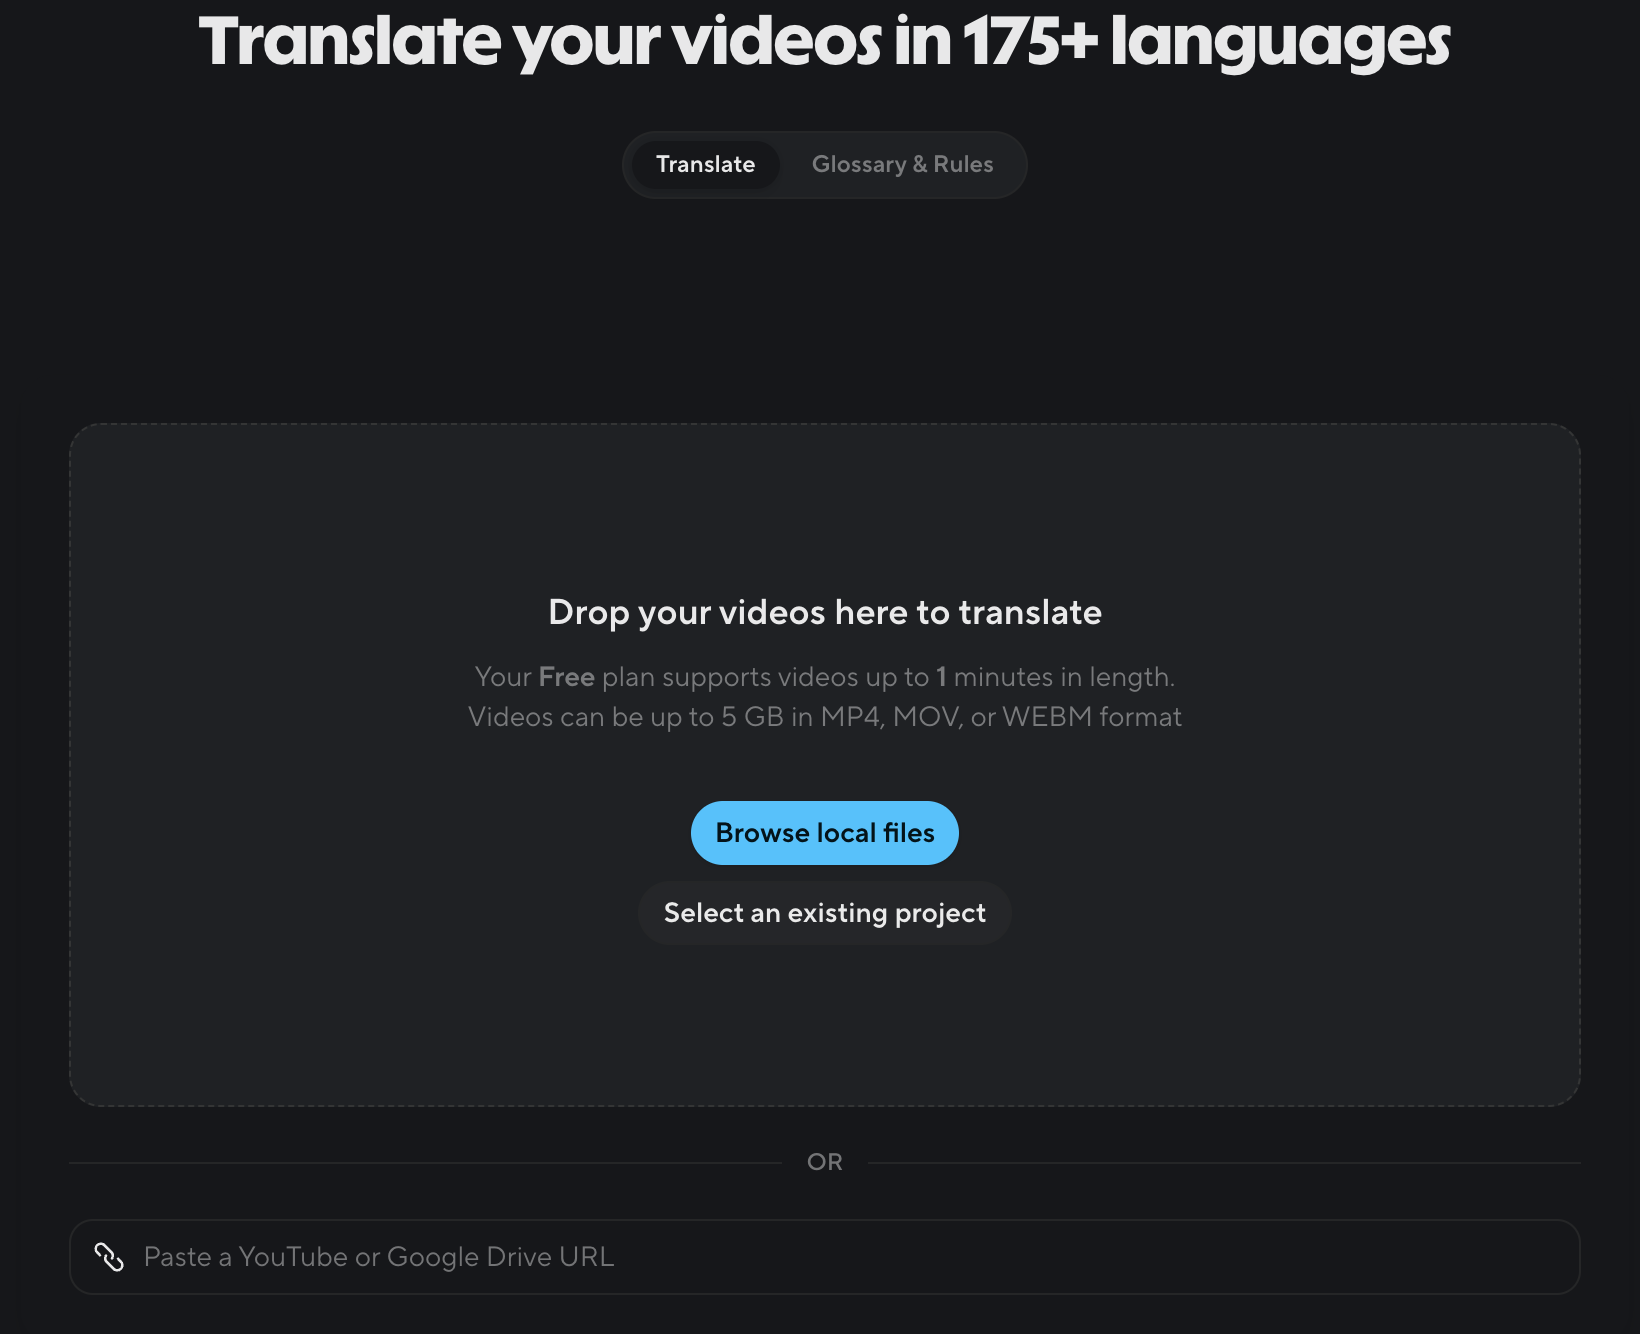
Figure 13. Drop the video in or paste a YouTube or Google Drive link. The free tier takes one minute of video at most, up to 5 GB, in MP4, MOV or WEBM. Figure 13. Déposez la vidéo ou collez un lien YouTube ou Google Drive. Le niveau gratuit accepte une minute de vidéo au maximum, jusqu'à 5 Go, en MP4, MOV ou WEBM.
Page 5Page 5
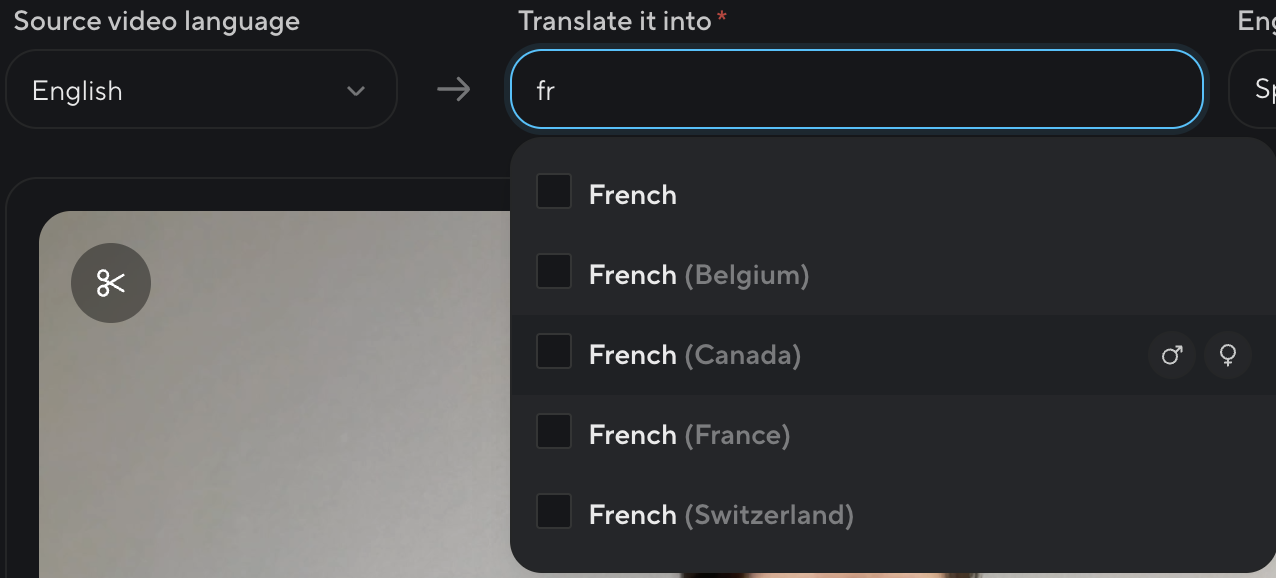
Figure 14. Give the language of the video, then the target language: Canadian French is offered, with a choice of a male or a female voice. Figure 14. Indiquez la langue de la vidéo, puis la langue cible : le français canadien est proposé, avec le choix d'une voix masculine ou féminine.
Page 5Page 5
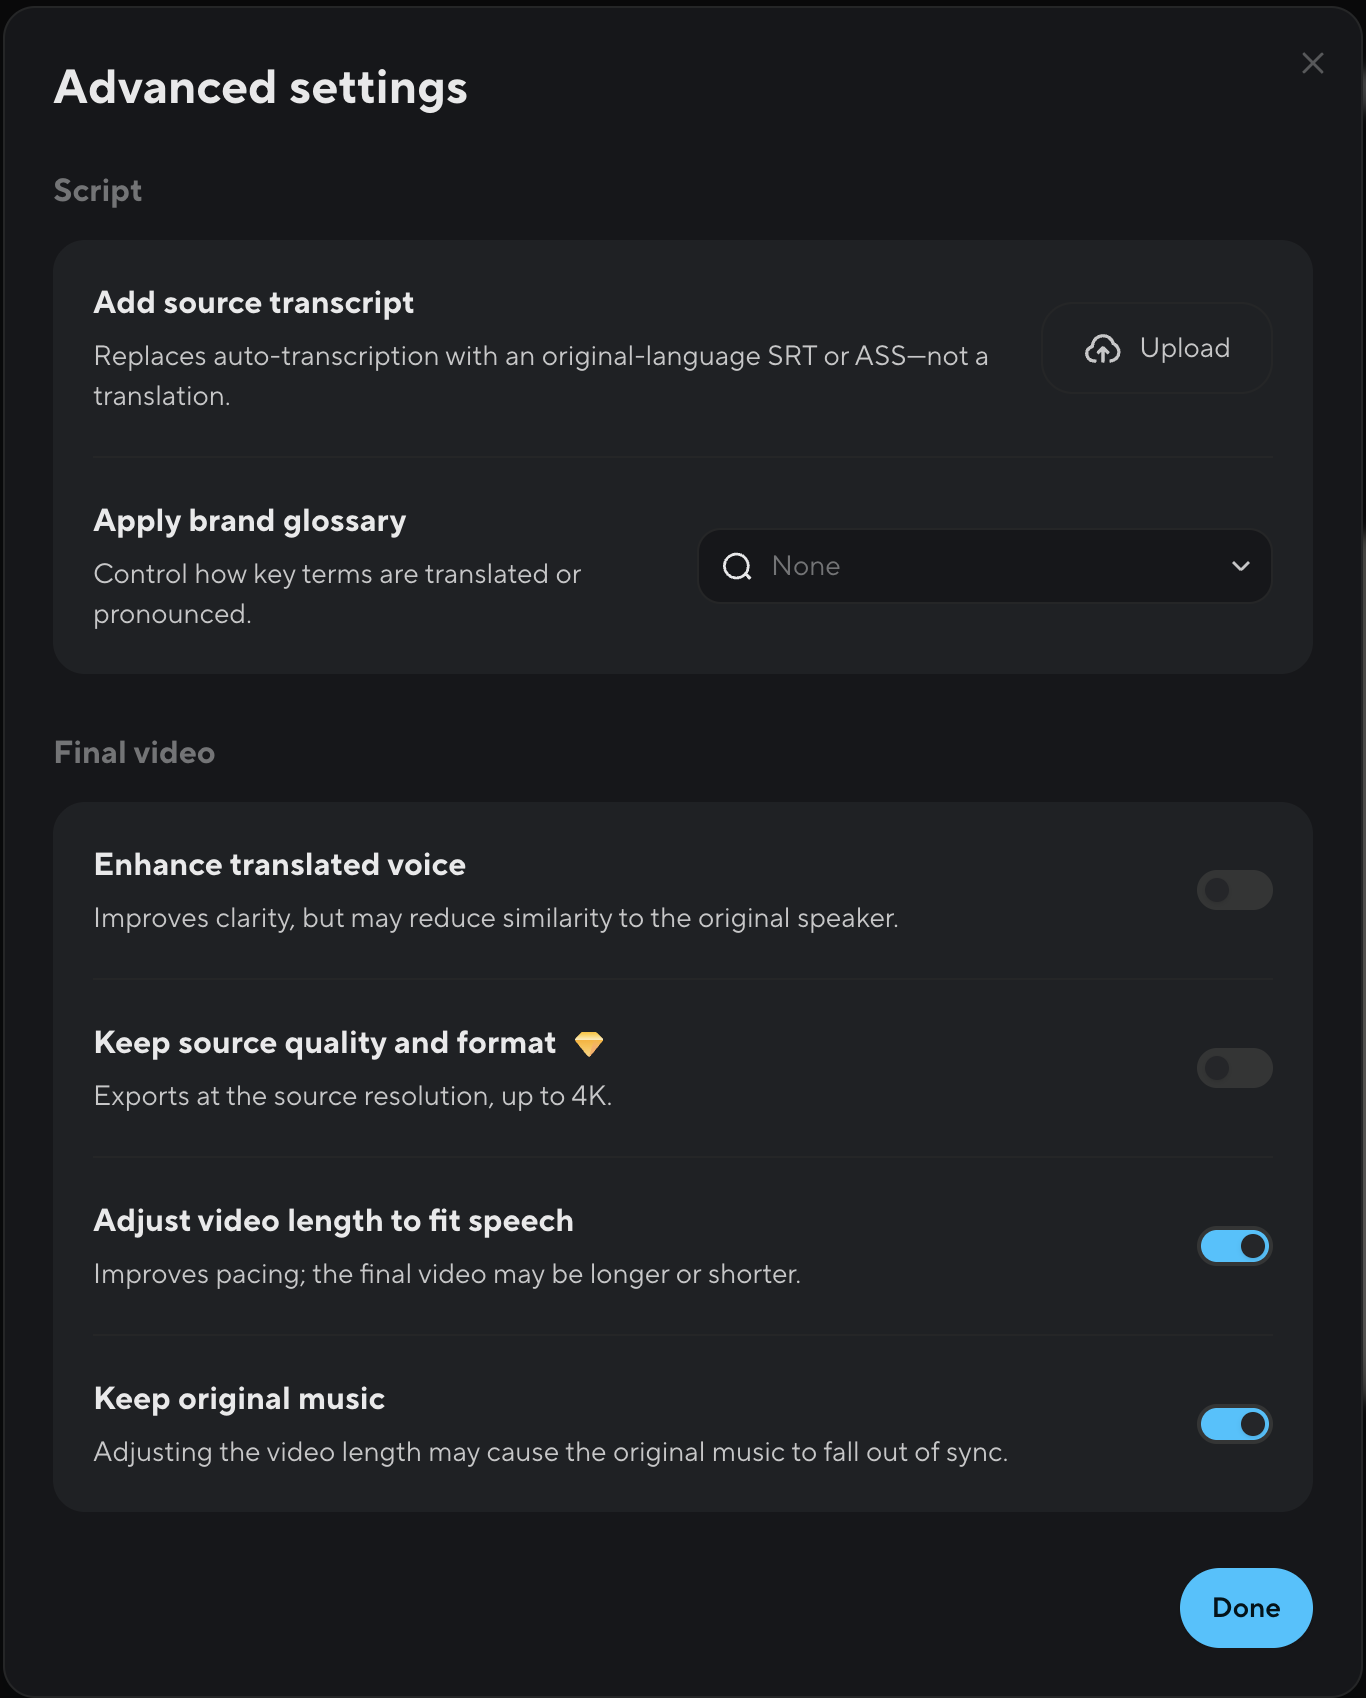
Figure 15. The advanced settings: the brand glossary and the export at source resolution need a paid plan, while adjusting the length to the speech and keeping the original music are on by default and change the result. Figure 15. Les réglages avancés : le glossaire de marque et l'export à la résolution d'origine demandent un abonnement payant, tandis que l'ajustement de la durée à la parole et la conservation de la musique sont actifs par défaut et modifient le résultat.
Page 5Page 5
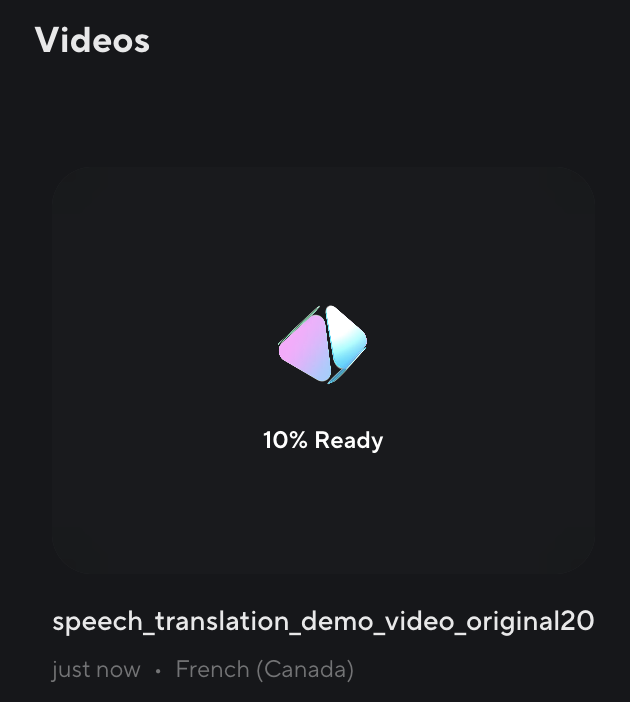
Figure 16. Processing is followed from the video list; it takes several minutes. Figure 16. Le traitement se suit depuis la liste des vidéos ; il prend plusieurs minutes.
Page 5Page 5
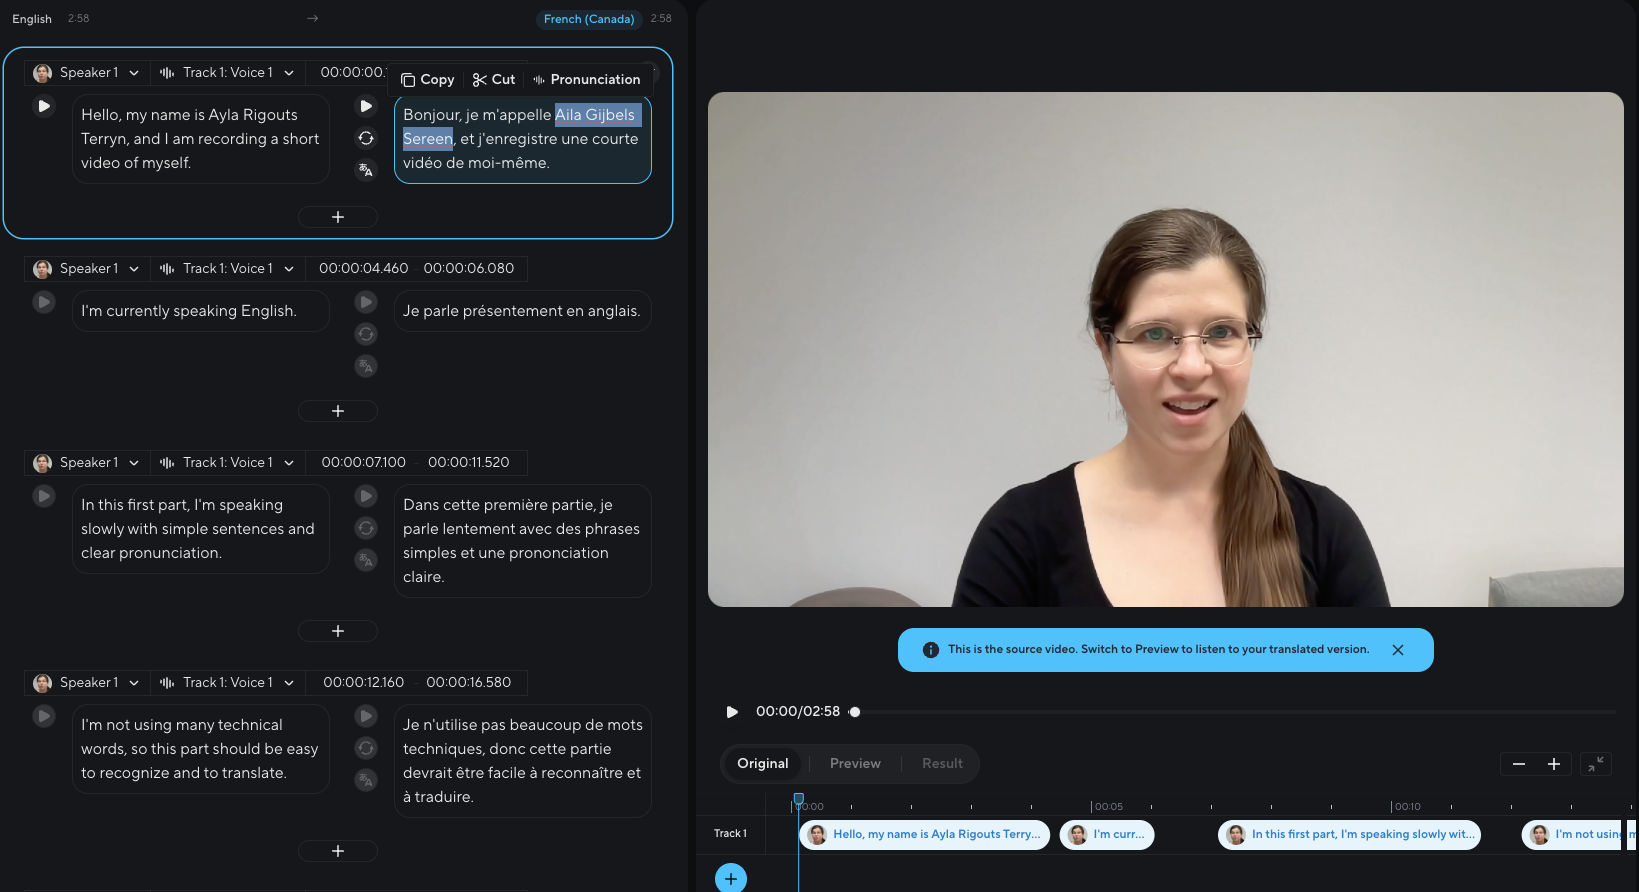
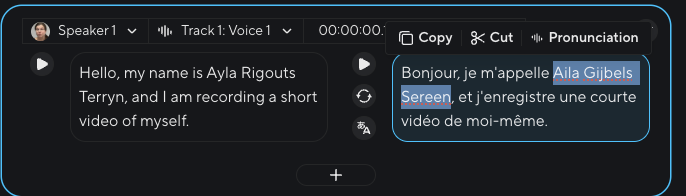
Figure 17. On a paid plan, the editor shows the transcript and the translation segment by segment, with playback of each segment, correction of the target text and a pronunciation control. Figure 17. Avec un abonnement payant, l'éditeur montre la transcription et la traduction segment par segment, avec la lecture de chaque segment, la correction du texte cible et un réglage de prononciation.
Page 5Page 5
Figure 18. The first segment, enlarged: “Ayla Rigouts Terryn” has become “Aila Gijbels Sereen”. Figure 18. Le premier segment, agrandi : « Ayla Rigouts Terryn » est devenu « Aila Gijbels Sereen ».
The page behind this slideLa page derrière cette diapositive
1 / 39The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter