Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Key pointsL'essentiel
LLM leaderboardsLes classements de GML
A leaderboard ranks models on one or one kind of vote. Reading it well means asking what was measured, on what material, and whether the models could have seen the test.
Un classement ordonne les modèles selon un ou un type de vote. Pour bien le lire, il faut se demander ce qui a été mesuré, sur quel matériau, et si les modèles ont pu voir le test.
Key pointsL'essentiel
LLM leaderboardsLes classements de GML
track what people like in an answer, which is not the same as what is correct, and they can be gamed.
Les suivent ce que les gens apprécient dans une réponse, ce qui n'est pas la même chose que ce qui est exact, et ils peuvent être manipulés.
Key pointsL'essentiel
LLM leaderboardsLes classements de GML
Most benchmarks are English. A model's rank in English says little about its French, and less about your kind of text.
La plupart des tests sont en anglais. Le rang d'un modèle en anglais dit peu de chose de son français, et moins encore de votre type de textes.
Key pointsL'essentiel
LLM leaderboardsLes classements de GML
Translation has comparisons of its own, the , where human judges rank systems that translated the same texts.
La traduction a ses propres comparaisons, les , où des juges humains classent des systèmes qui ont traduit les mêmes textes.
Page 1Page 1
Reading a leaderboardLire un classement
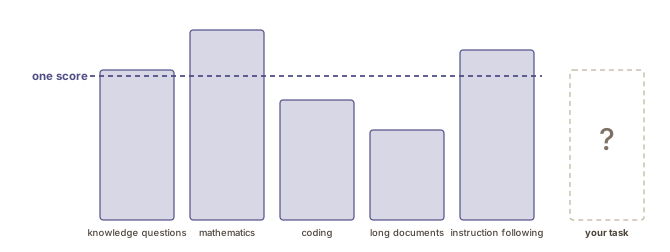
- A leaderboard ranks models by their score on one , a fixed set of questions with a rule for marking the answers.
- A score is only as good as the questions behind it: what they ask about, and whether the models had seen them before.
- Three things make a published score mean less than it looks: the test leaking into training data, models tuned toward the test, and a test that measures a skill other than yours.
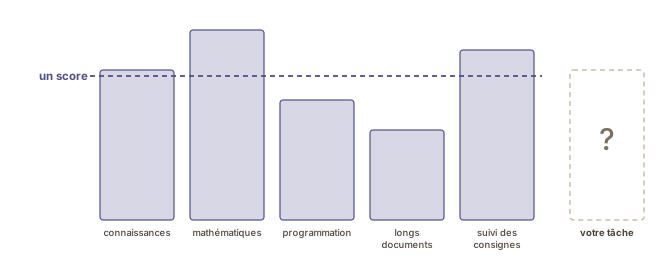
- Un classement ordonne les modèles selon leur score à un , c'est-à-dire un ensemble fixe de questions assorti d'une règle de notation des réponses.
- Un score ne vaut que ce que valent les questions qui le produisent : ce sur quoi elles portent, et si les modèles les avaient déjà vues.
- Trois choses font qu'un score publié veut dire moins qu'il n'y paraît : le test qui s'est retrouvé dans les données d'entraînement, des modèles ajustés en vue du test, et un test qui mesure une autre compétence que la vôtre.
Page 1Page 1
Page 2Page 2
Human preference rankingsLes classements fondés sur les préférences humaines
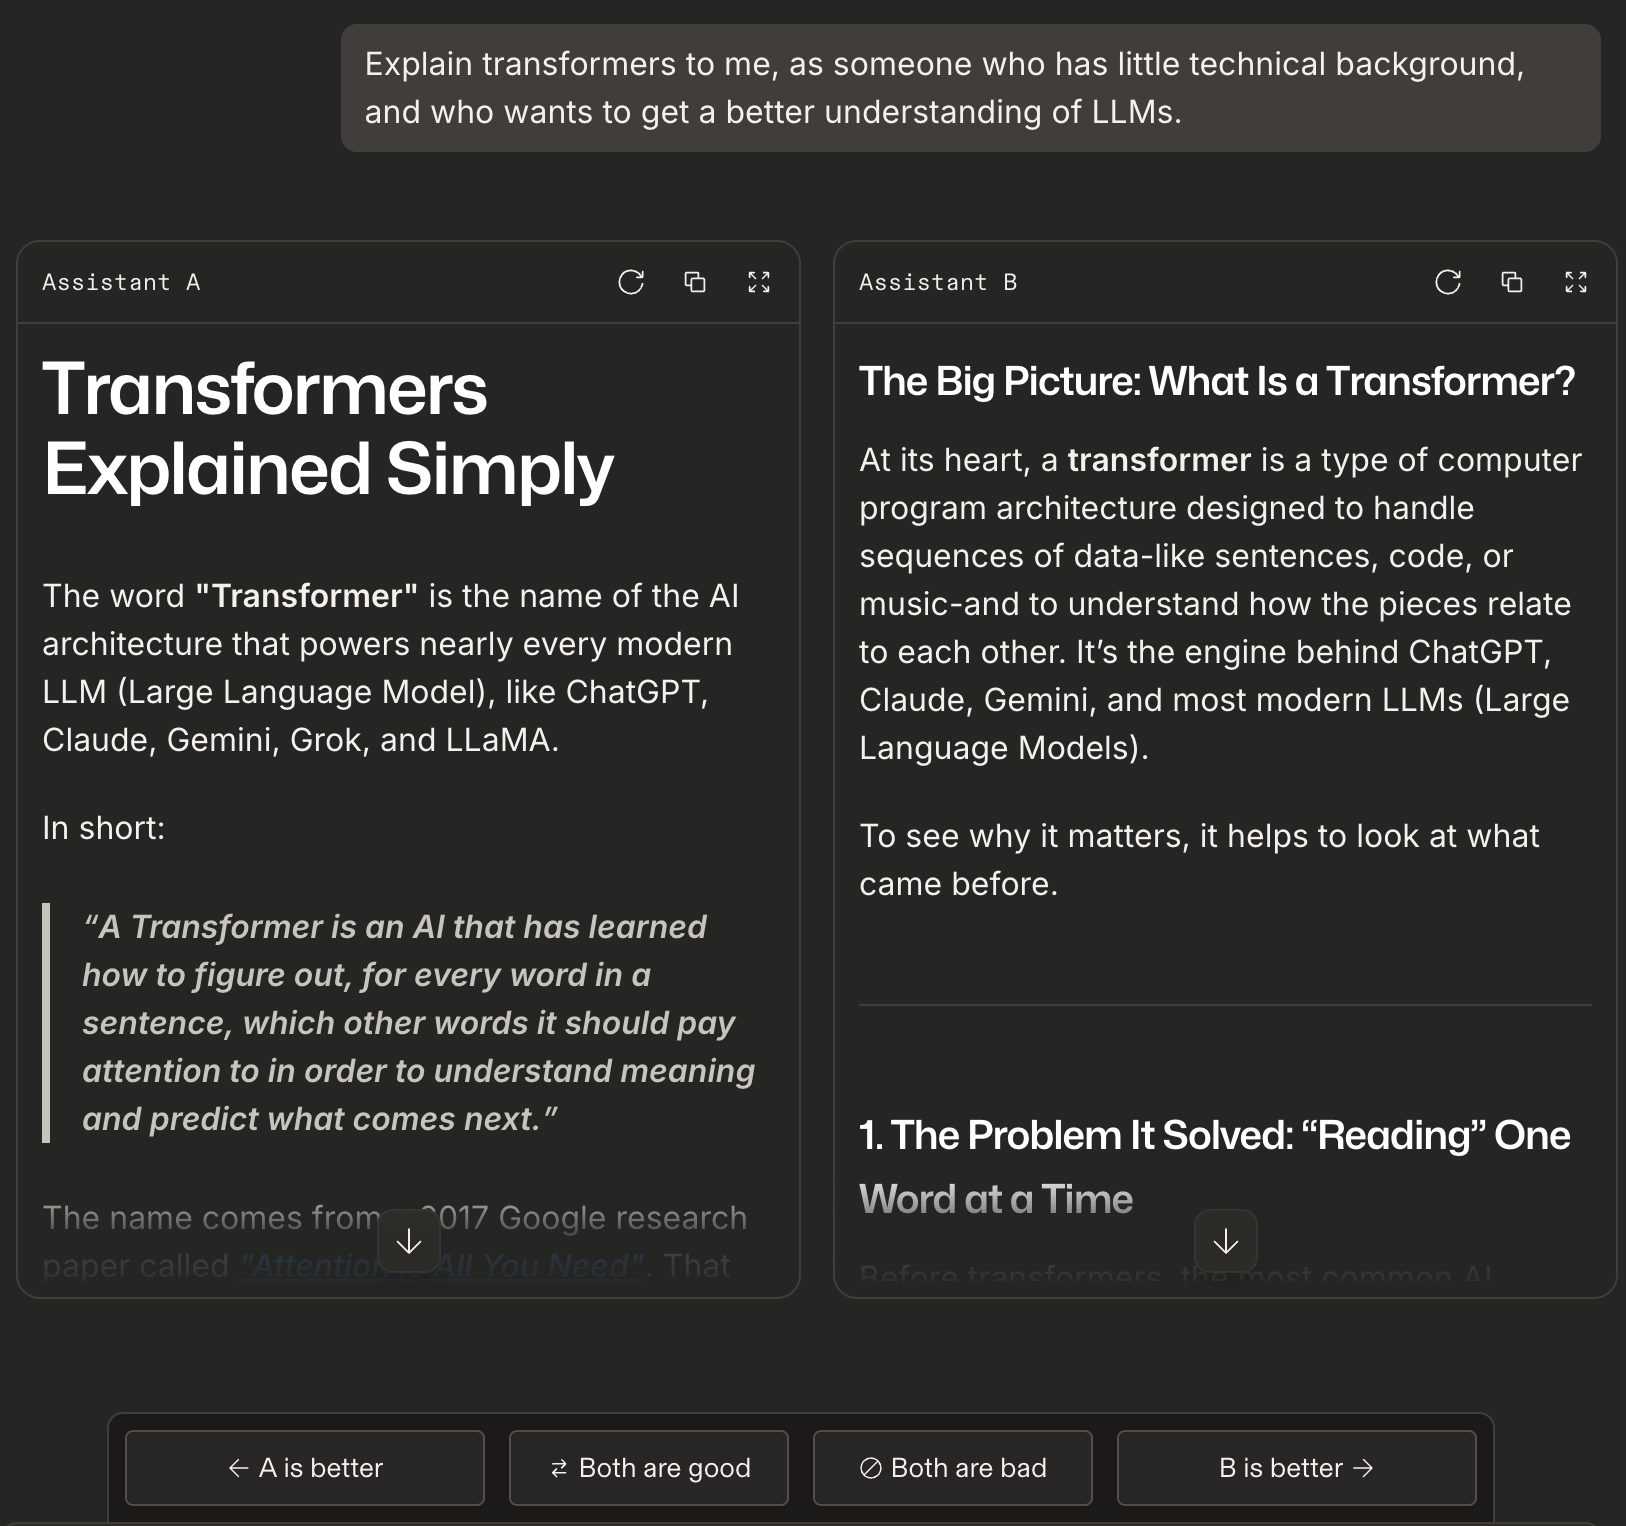
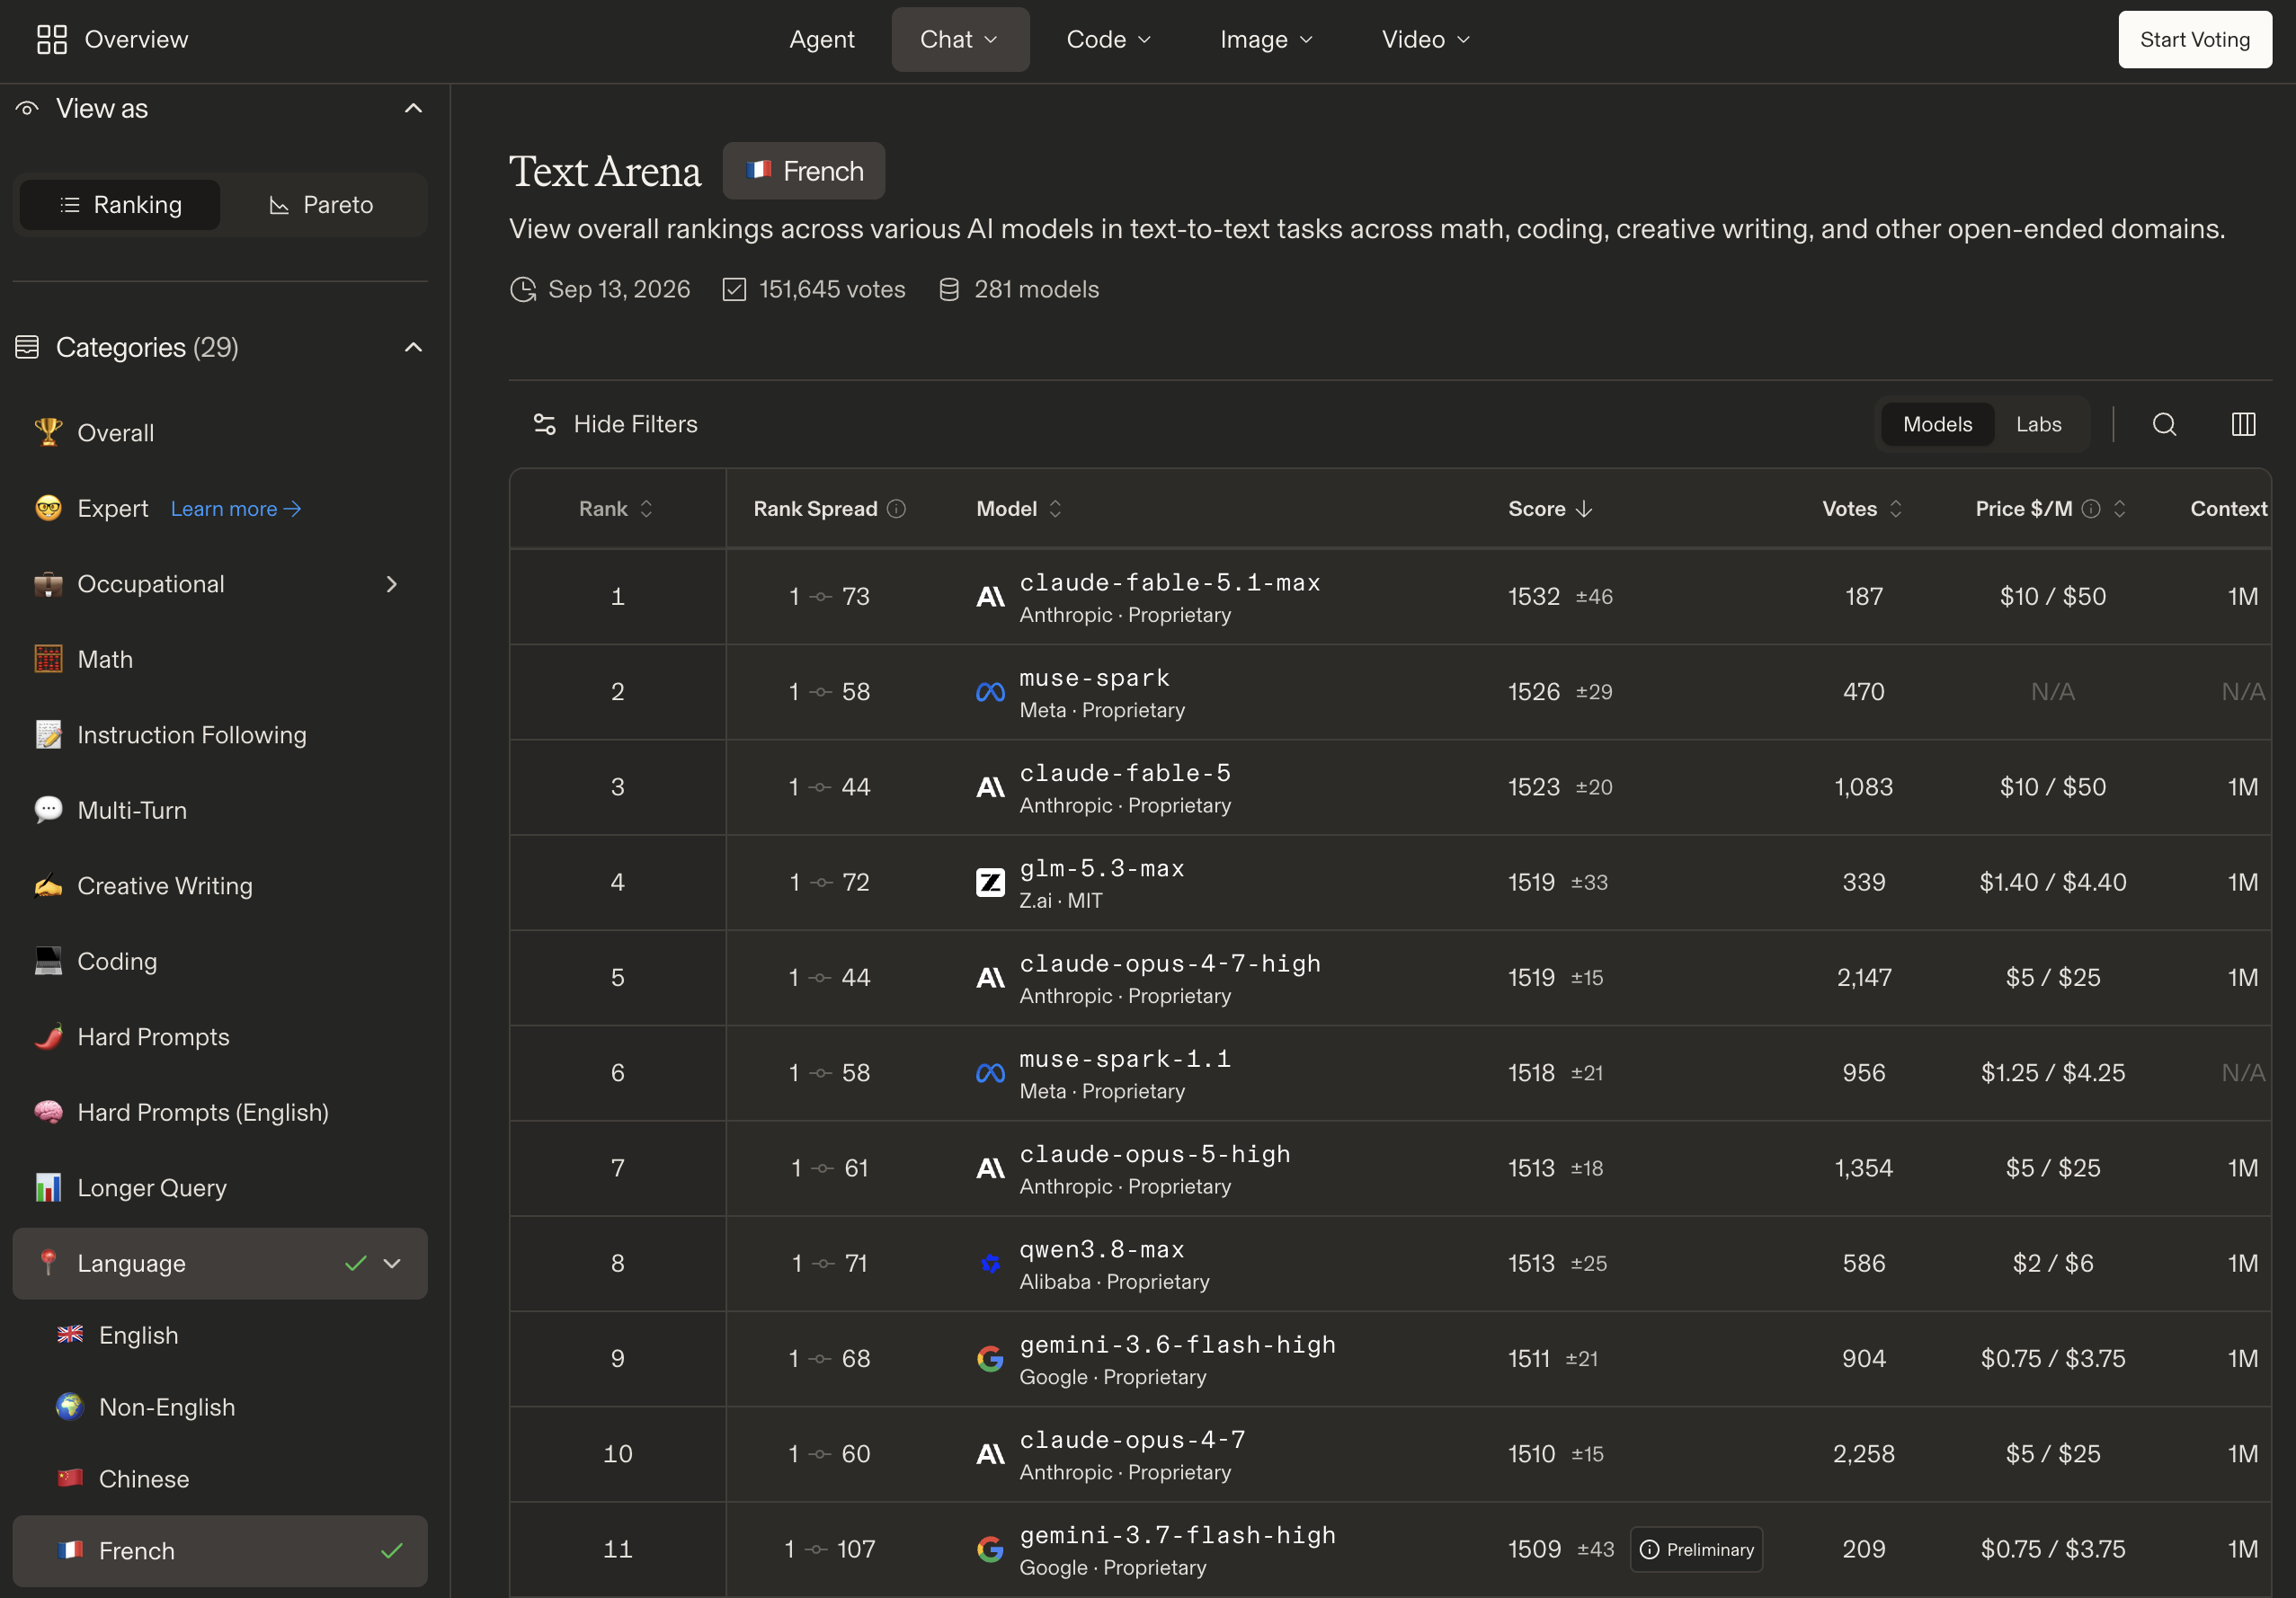
- A preference ranking is built from people comparing two anonymous answers to their own question and voting, so it reflects what people like on the tasks they actually bring.
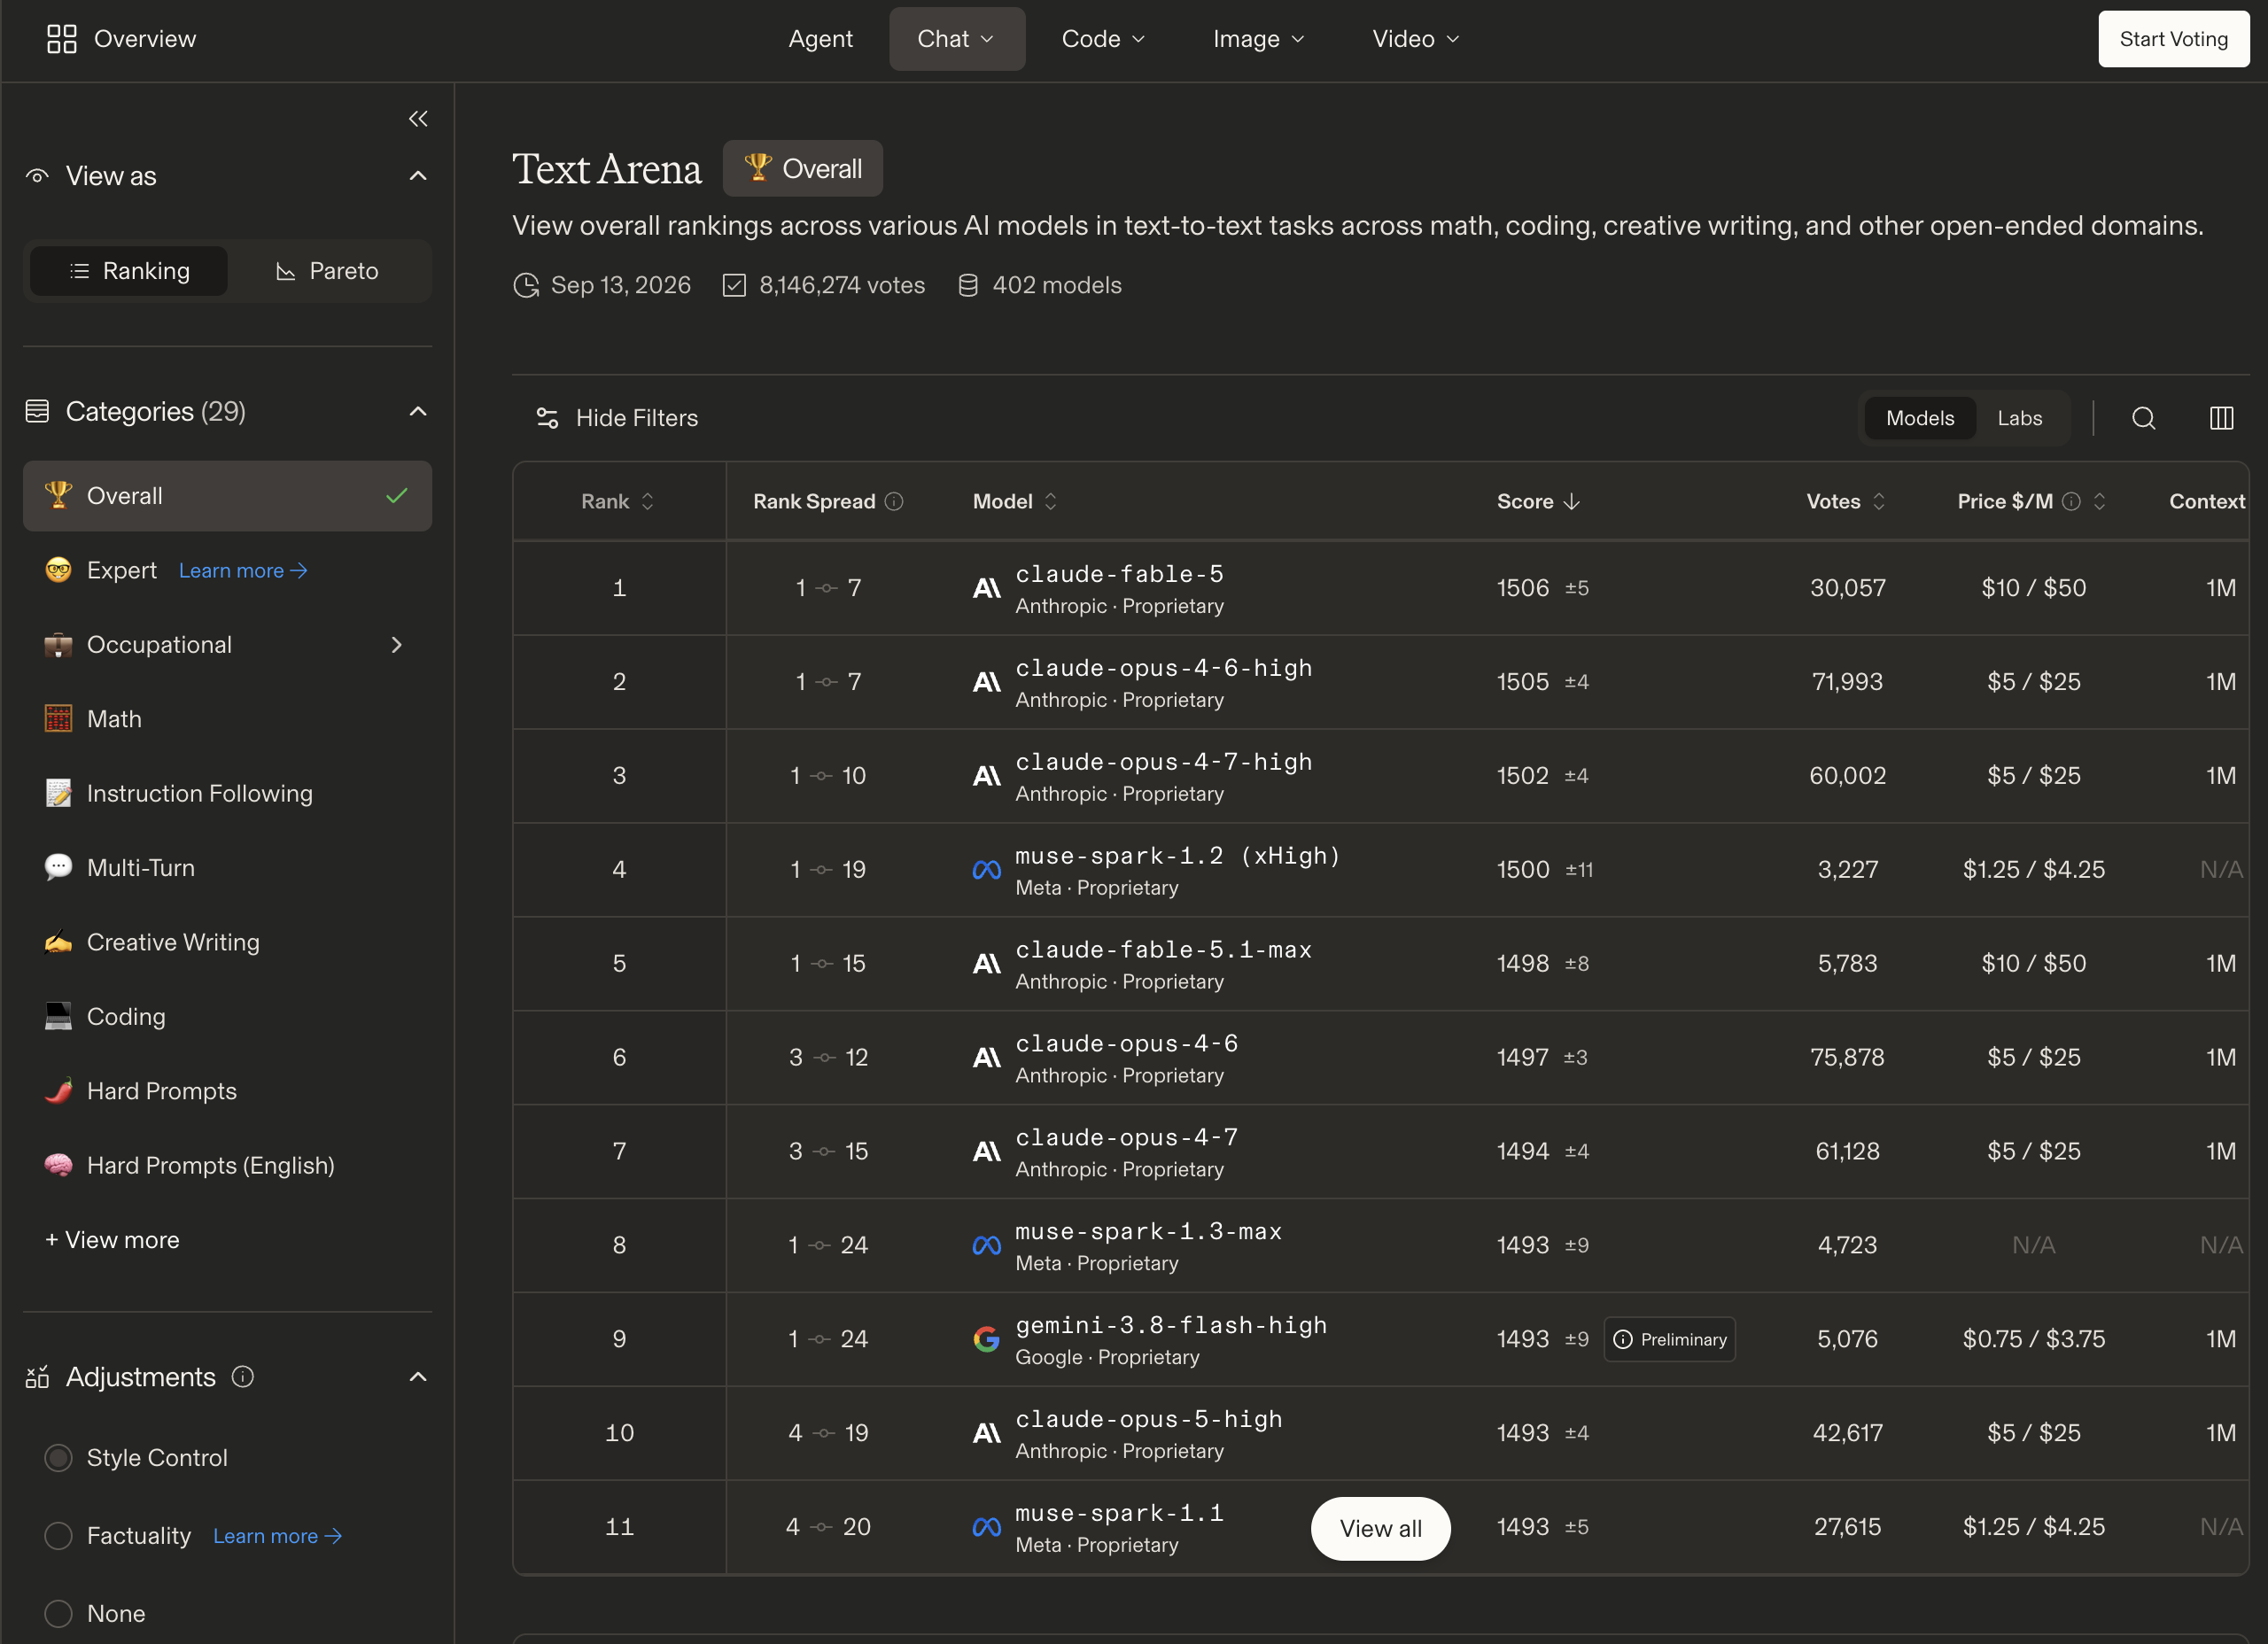
- What people like is not the same as what is correct, some providers get far more votes than others, and a ranking moves with every release, so it is a shortlist rather than a verdict.
- Un classement fondé sur les préférences se construit à partir de personnes qui comparent deux réponses anonymes à leur propre question et votent ; il reflète donc ce que les gens apprécient, sur les tâches qu'ils soumettent réellement.
- Ce que les gens apprécient n'est pas la même chose que ce qui est exact, certains fournisseurs obtiennent beaucoup plus de votes que d'autres, et un classement bouge à chaque nouvelle version : c'est une présélection plutôt qu'un verdict.
Page 2Page 2
Page 2Page 2
Page 2Page 2
Page 3Page 3
Benchmarks in French and other languagesLes tests en français et dans d'autres langues
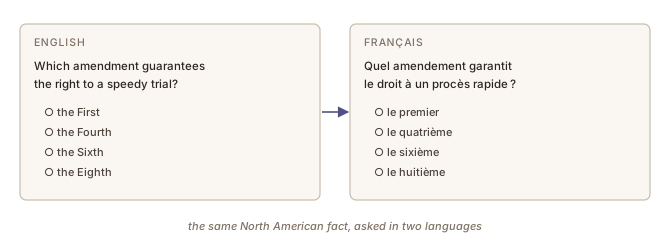
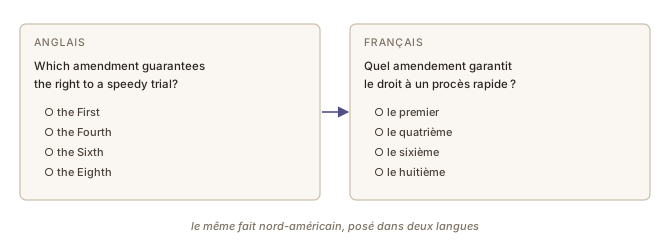
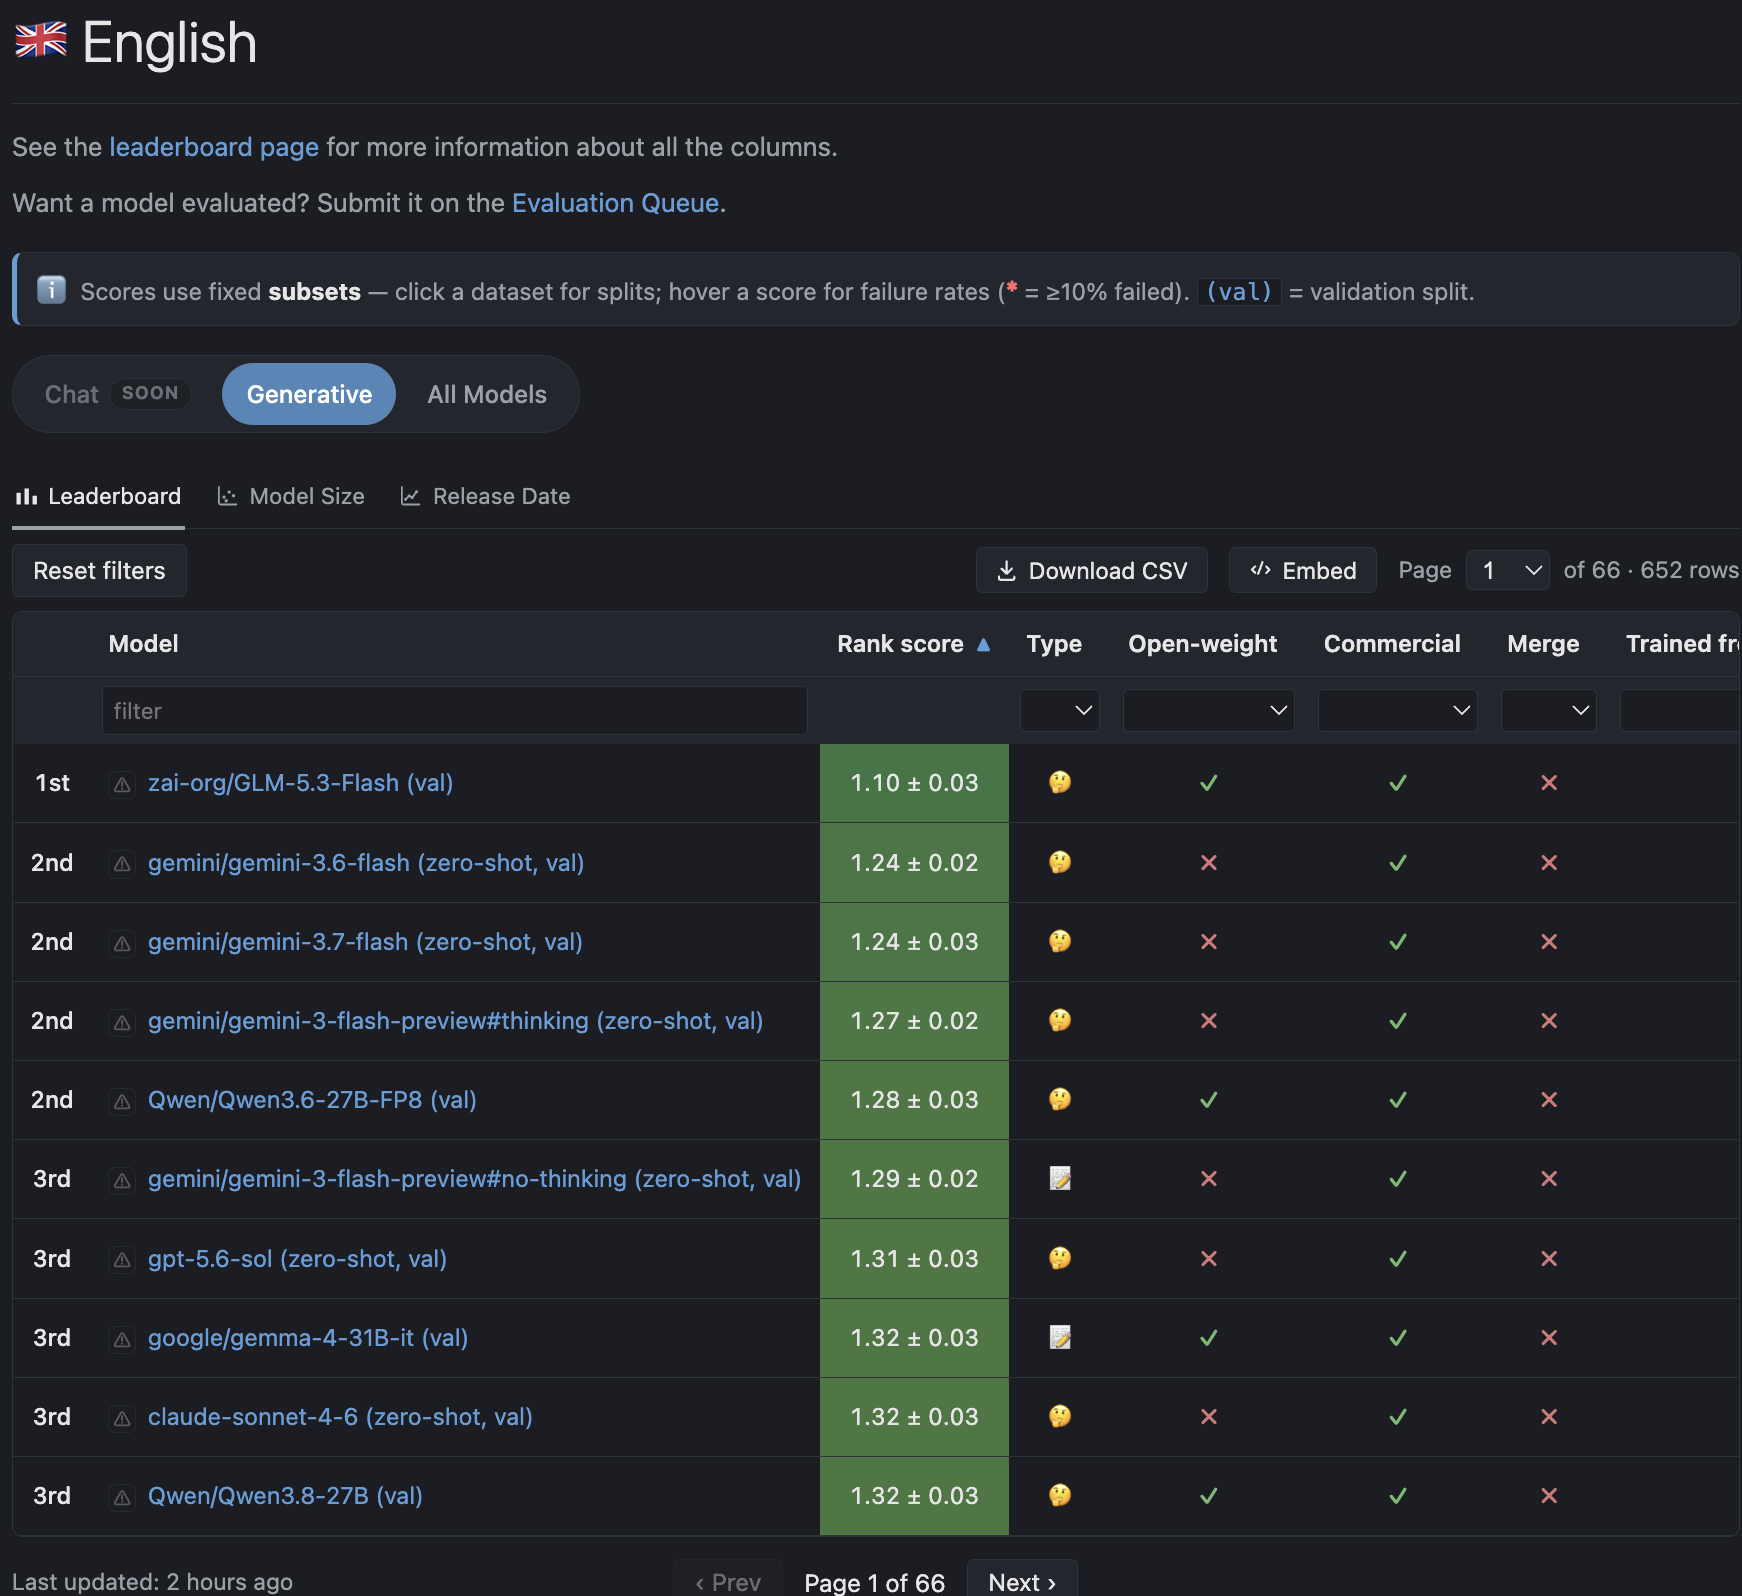
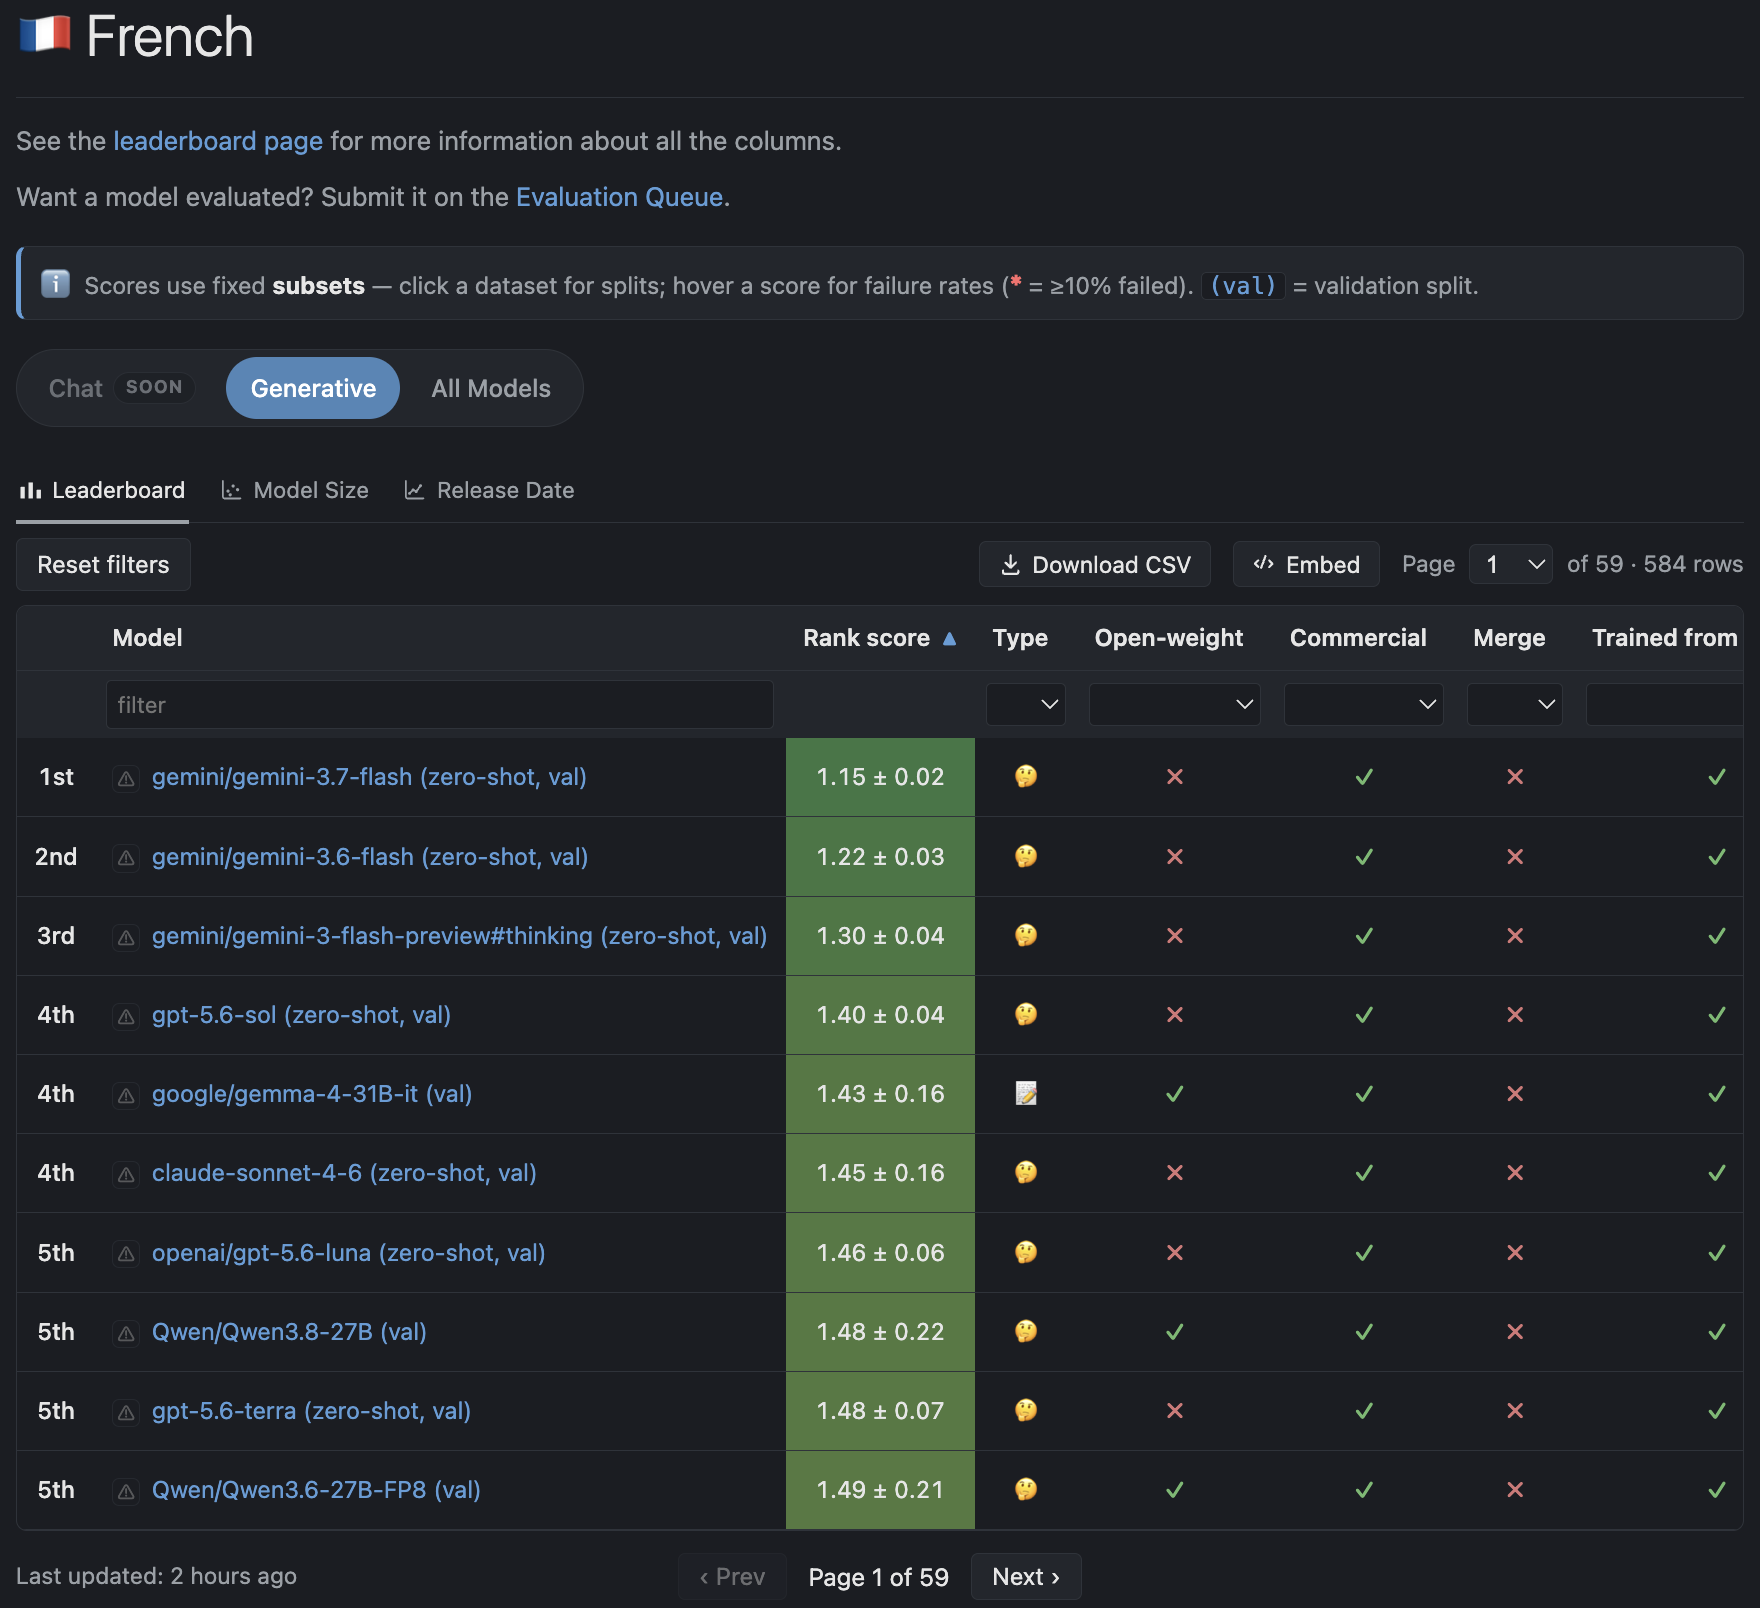
- Most benchmarks are written in English, so a model's rank on them says little about how it handles other languages, French included.
- Translating a benchmark is better than having none, but the questions still come from an English-speaking world. Tests built in a language, from material written in it, measure something the translated ones cannot.
- La plupart des tests de performances sont rédigés en anglais : le rang d'un modèle à ces tests dit donc peu de chose de ce qu'il fait dans d'autres langues, y compris le français.
- Traduire un test vaut mieux que de ne pas en avoir, mais les questions viennent toujours d'un monde anglophone. Des tests conçus dans une langue, à partir de textes écrits dans cette langue, mesurent ce que les tests traduits ne peuvent pas mesurer.
Page 3Page 3
Page 3Page 3
Page 3Page 3
Page 4Page 4
Benchmarks for translationLes tests pour la traduction
- Translation systems are compared in shared tasks: many systems translate the same texts, and human judges rank the output.
- Automatic scores and human judges do not always agree, and a system can raise its score without its translations getting better.
- Les systèmes de traduction sont comparés dans des tâches partagées : de nombreux systèmes traduisent les mêmes textes, et des juges humains classent les résultats.
- Les scores automatiques et les juges humains ne sont pas toujours d'accord, et un système peut faire monter son score sans que ses traductions s'améliorent.