Parcours d'apprentissage en ligneParcours d'apprentissage en ligne
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Speech technology: types, quality and consequencesLes technologies de la parole : types, qualité et conséquences
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Three families of speech technologyTrois familles de technologies de la parole
What changed recently
Three developments have made speech technology more viable as an alternative
to typing in professional work:
A jump in quality. Models trained at scale, such as Whisper (Radford
et al., 2023, trained on 680,000 hours of audio), come close to human
accuracy on clear audio. The previous generation of systems needed to be
trained per speaker and tolerated noise badly.
Free and built in. Word, PowerPoint and Google Docs include dictation at
no extra cost; buying specialized software such as Dragon and training it for
hours is no longer necessary, though it can still mean noticeably higher
quality or more functionality.
Multilingual coverage. A usably good performance can now be obtained
for an increasing number of languages, whereas this used to only be the
case for US English.
From speech to text
Input: audio.
Output: written text.
It is what you most commonly think of as speech technology, and what you use
to:
Input: written text.
Output: audio.
It is what you use for:
screen readers, for accessibility;
audiobook production;
video dubbing;
voice assistance (GPS, virtual assistants).
Representative technologies: Google TTS, Amazon Polly, Microsoft Azure TTS,
ElevenLabs.Product pages: Google Cloud Text-to-Speech,
Amazon Polly, Azure AI Speech, ElevenLabs.
This module does not go into it in detail, but it is an
essential component of speech-to-speech translation systems.
From speech to speech
Input: audio in language A.
Output: audio in language B.
It is what you use for:
automatic interpreting in a meeting;
translating a video with dubbing.
Representative technologies: KUDO AI, HeyGen, the Microsoft Teams
interpreter, Google Translate in conversation mode.Product pages:
KUDO, HeyGen, Google Translate.
Sources
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust speech recognition via large-scale weak supervision. Proceedings of the 40th International Conference on Machine Learning (PMLR 202), 28492–28518. https://proceedings.mlr.press/v202/radford23a.html
Ce qui a changé récemment
Trois évolutions font des technologies de la parole une solution de rechange
plus viable à la frappe dans le travail professionnel :
Un saut qualitatif. Les modèles entraînés à grande échelle, comme
Whisper (Radford et al., 2023, entraîné sur 680 000 heures d’audio),
approchent la précision humaine sur de l’audio clair. Les systèmes de la
génération précédente exigeaient un entraînement par locuteur et toléraient
mal le bruit.
Gratuité et intégration. Word, PowerPoint et Google Docs intègrent la
dictée sans frais supplémentaires ; il n’est plus nécessaire d’acheter un
logiciel spécialisé comme Dragon et de l’entraîner pendant des heures, même
si cela peut encore apporter une qualité nettement meilleure ou plus de
fonctionnalités.
Couverture multilingue. On obtient maintenant une performance utilisable
pour un nombre croissant de langues, alors que ce n’était longtemps le cas
que pour l’anglais états-unien.
De la parole au texte
Entrée : audio.
Sortie : texte écrit.
C’est ce à quoi on pense d’abord quand on parle de technologies de la parole.
Exemples d’utilisation :
dicter un texte ;
afficher des sous-titres en direct pendant une présentation ;
Technologies représentatives : Google TTS, Amazon Polly, Microsoft Azure
TTS, ElevenLabs.Pages des produits : Google Cloud
Text-to-Speech, Amazon Polly, Azure AI Speech,
ElevenLabs. Ce module ne l’explore pas en détail, mais elle est une
composante essentielle des systèmes de traduction parole à parole.
De la parole à la parole
Entrée : audio en langue A.
Sortie : audio en langue B.
Exemples d’utilisation :
interprétation automatique en réunion ;
traduction d’une vidéo avec doublage.
Technologies représentatives : KUDO AI, HeyGen, l’interprète de Microsoft
Teams, Google Traduction en mode conversation.Pages des
produits : KUDO, HeyGen,
Google Traduction.
Sources
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust speech recognition via large-scale weak supervision. Proceedings of the 40th International Conference on Machine Learning (PMLR 202), 28492–28518. https://proceedings.mlr.press/v202/radford23a.html
Translating speech: cascade or end-to-endTraduire la parole : en cascade ou de bout en bout
Advantages: a modular architecture; each stage can use the best model
available, and each stage produces a result you can inspect and correct
before the next one runs. When you are evaluating a system rather than
working under time pressure, that is what lets you see which stage is
failing and needs work.
Drawbacks: unless you intervene, each stage works from what the one
before it produced, so errors accumulate. Machine translation that is
excellent on written text does worse here, because what it is translating is
a transcription that may already be wrong. Latency grows with each stage,
and prosodic elements (intonation, emphasis) are lost on the way through the
text.
The end-to-end approach
FR audio → [single model] → EN audio
A single model turns the source audio directly into target audio.
Advantages: the voice and the style can be preserved; lower latency.
Drawbacks: still under development, and available for few language
pairs. Training one directly takes hundreds of hours of the same utterances
spoken in both languages, which exists for few pairs, where a cascade reuses
recognition, translation and synthesis trained separately (Diwan et al.,
2024).
Most current consumer tools work as a cascade; voice cloning still lets them
keep a voice close to the original.
Sources
Diwan, A., Srinivasan, A., Harwath, D., & Choi, E. (2024). Textless speech-to-speech translation with limited parallel data. Findings of the Association for Computational Linguistics: EMNLP 2024, 16302–16311. https://aclanthology.org/2024.findings-emnlp.951/
Avantages : architecture modulaire ; chaque étape peut utiliser le
meilleur modèle disponible, et chaque étape produit un résultat qu’on peut
examiner et corriger avant que la suivante s’exécute. Quand on évalue un
système plutôt que de travailler sous la pression du temps, c’est ce qui
permet de voir quelle étape échoue et demande du travail.
Inconvénients : à moins d’intervenir, chaque étape travaille à partir de
ce que la précédente a produit, si bien que les erreurs s’additionnent. Une
traduction automatique excellente sur du texte écrit fera moins bien ici,
parce que ce qu’elle traduit est une transcription parfois déjà fautive. La
latence augmente à chaque étape, et les éléments prosodiques (intonation,
emphase) se perdent au passage par le texte.
L’approche de bout en bout
Audio FR → [modèle unique] → Audio EN
Un seul modèle transforme directement l’audio source en audio cible.
Avantages : préservation possible de la voix et du style ; latence
réduite.
Inconvénients : encore en développement, et disponible pour peu de
paires de langues. L’entraîner directement demande des centaines d’heures des
mêmes énoncés prononcés dans les deux langues, ce qui n’existe que pour
quelques paires, alors qu’une cascade réutilise la reconnaissance, la
traduction et la synthèse entraînées séparément (Diwan et al., 2024).
La plupart des outils grand public actuels fonctionnent en cascade ; le
clonage vocal leur permet malgré tout de conserver une voix proche de
l’original.
Sources
Diwan, A., Srinivasan, A., Harwath, D., & Choi, E. (2024). Textless speech-to-speech translation with limited parallel data. Findings of the Association for Computational Linguistics: EMNLP 2024, 16302–16311. https://aclanthology.org/2024.findings-emnlp.951/
Measuring speech recognition qualityMesurer la qualité de la reconnaissance
Word error rate
To evaluate a recognition system objectively, researchers and practitioners
mainly use word error rate.
The metric counts three kinds of error:
Substitutions: one word replaced by another (“contract” becomes
“contact”);
Deletions: a word of the reference missing from the transcription;
Insertions: a word added that was not in the original.
A WER of 5% means that on average one word in twenty is wrong. But errors do
not all have the same impact. Take a text of 20 words:
Original: “The contract stipulates an amount of twenty million dollars,
payable before 15 March 2025, and late payment will incur penalties.”
Transcription: “The contract stipulates an amount of twenty billion
dollars, payable before 15 March 2025, and late payment will incur
penalties.”
A single error, so a WER of 5%, and the meaning of the document changes
completely. WER measures how often errors occur, not how much they matter.
This is why numerical metrics are not enough on their own: the impact of the
errors has to be judged in the professional setting they are meant for. Weighting
errors by importance, on named entities for instance, predicts how useful a
system will be for a given task better than a raw WER does (Galibert et al.,
2016).
Performance by condition
Current systems reach very different levels depending on the conditions
(Radford et al., 2023; Koenecke et al., 2020):
Ideal conditions (clear audio, a single speaker, standard
vocabulary): text that is generally readable with few visible errors; it
still has to be reread for figures, proper nouns and acronyms.
Real-world conditions (background noise, accents, terminology): quality
fluctuates a great deal.
Difficult conditions (several speakers, heavy noise, specialized
language): errors become frequent and unstable. Assigning speaker turns
remains fragile, and terminology and names go on causing trouble despite
the progress made.
Sources
Galibert, O., Camelin, N., Deléglise, P., & Rosset, S. (2016). Estimation de la qualité d'un système de reconnaissance de la parole pour une tâche de compréhension. Actes de la conférence conjointe JEP-TALN-RECITAL 2016, vol. 1, 274–282. https://aclanthology.org/2016.jeptalnrecital-jep.31/
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust speech recognition via large-scale weak supervision. Proceedings of the 40th International Conference on Machine Learning (PMLR 202), 28492–28518. https://proceedings.mlr.press/v202/radford23a.html
Le taux d’erreur de mots
Pour évaluer objectivement un système de reconnaissance, chercheurs et
professionnels utilisent principalement le taux d’erreur de mots.
La métrique compte trois types d’erreurs :
Substitutions : un mot remplacé par un autre (« contrat » → « contact ») ;
Suppressions : un mot de la référence absent de la transcription ;
Insertions : un mot ajouté qui n’était pas dans l’original.
Un WER de 5 % veut dire qu’en moyenne, un mot sur vingt est erroné. Mais
toutes les erreurs n’ont pas le même impact. Exemple avec un texte de
20 mots :
Original : « Le contrat stipule un montant de vingt millions de
dollars, payable avant le 15 mars 2025, sous peine de pénalités. »
Transcription : « Le contrat stipule un montant de vingt milliards
de dollars, payable avant le 15 mars 2025, sous peine de
pénalités. »
Une seule erreur, donc un WER de 5 %, et le sens du document change
complètement. Le WER mesure la fréquence des erreurs, pas leur gravité.
C’est pourquoi les métriques chiffrées ne suffisent pas : il faut évaluer
l’impact des erreurs dans le contexte professionnel visé. Pondérer les erreurs
selon leur importance, par exemple sur les entités nommées, prédit mieux
l’utilité d’un système pour une tâche donnée qu’un WER brut (Galibert et al.,
2016).
La performance selon les conditions
Les systèmes actuels atteignent des niveaux très différents selon les
conditions (Radford et al., 2023 ; Koenecke et al., 2020) :
Conditions optimales (audio clair, locuteur unique, vocabulaire
standard) : texte en général lisible avec peu d’erreurs visibles ; une
relecture reste nécessaire pour les chiffres, les noms propres et les
sigles.
Conditions difficiles (plusieurs locuteurs, bruit important, langue
spécialisée) : les erreurs deviennent fréquentes et instables.
L’attribution des tours de parole reste fragile, et la terminologie et
les noms continuent de poser problème malgré les progrès.
Sources
Galibert, O., Camelin, N., Deléglise, P., & Rosset, S. (2016). Estimation de la qualité d'un système de reconnaissance de la parole pour une tâche de compréhension. Actes de la conférence conjointe JEP-TALN-RECITAL 2016, vol. 1, 274–282. https://aclanthology.org/2016.jeptalnrecital-jep.31/
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust speech recognition via large-scale weak supervision. Proceedings of the 40th International Conference on Machine Learning (PMLR 202), 28492–28518. https://proceedings.mlr.press/v202/radford23a.html
Speed vs. quality: live, offline and simultaneousVitesse contre qualité : en direct, en différé et en simultané
In speech recognition
Recognition systems can work in two modes, and the mode affects
performance:
Live (real time): the system transcribes as you speak, favouring speed
at the cost of accuracy. Without the full context of the sentence, it makes
more errors, especially on homophones and punctuation.
Offline: the system analyzes the complete recording before transcribing,
which allows better accuracy through the availability of surrounding
context.
The simultaneous task is where the trade-off is measured. Systems are sorted
into a low-latency group of 0 to 2 seconds and a high-latency one of 2 to 4,
and the longer a system waits for more context, the better the translation and
the later it arrives (Adelani et al., 2026).
Sources
Adelani, D. I., Agostinelli, V., Anastasopoulos, A., Bentivogli, L., Bojar, O., et al. (2026). Speech translation and metrics in 2026: Findings of the IWSLT campaign. Proceedings of the 23rd International Conference on Spoken Language Translation (IWSLT 2026), 336–422. https://aclanthology.org/2026.iwslt-1.39/
En reconnaissance de la parole
Les systèmes de reconnaissance peuvent fonctionner selon deux modes qui
influencent la performance :
En direct (temps réel) : le système transcrit au fur et à mesure, en
privilégiant la rapidité au détriment de la précision. Sans le contexte
complet de la phrase, il fait plus d’erreurs, en particulier sur les
homophones et la ponctuation.
En différé : le système analyse l’enregistrement complet avant de
transcrire, ce qui permet une meilleure précision grâce à la disponibilité
du contexte environnant.
C’est la tâche de traduction simultanée qui mesure le compromis. Les systèmes
sont répartis entre un régime de faible latence, de 0 à 2 secondes, et un
régime de latence élevée, de 2 à 4, et plus un système attend pour disposer de
contexte, meilleure est la traduction et plus elle arrive tard (Adelani et
al., 2026).
Sources
Adelani, D. I., Agostinelli, V., Anastasopoulos, A., Bentivogli, L., Bojar, O., et al. (2026). Speech translation and metrics in 2026: Findings of the IWSLT campaign. Proceedings of the 23rd International Conference on Spoken Language Translation (IWSLT 2026), 336–422. https://aclanthology.org/2026.iwslt-1.39/
What affects speech recognition qualityCe qui influence la qualité de la reconnaissance
Three groups of factors
The differences in performance from one situation to another are not
random. Three groups of factors account for them, and most of them leave you
some room to act.
Signal quality
Factor
Effect on performance
What you can do
Microphone quality and placement
Wrong distance or angle: intelligibility drops, consonants get swallowed
Microphone close to the mouth (15 to 20 cm); avoid rubbing and plosives; run an audio test
Background noise
Masks the useful sounds: the error rate rises
Headset or directional microphone; quiet room; software noise reduction
Room reverberation
The echo blurs word and sentence boundaries
A room with little reverberation; curtains or panels; speak facing the microphone
Several speakers, overlapping
Imperfect diarization; segments cut short where voices overlap
A stable connection, wired if possible; limit competing applications
Assigning each segment to the right speaker remains an open problem,
particularly where voices overlap (O’Shaughnessy, 2025): expect to carefully
reread any transcription of a meeting.
Linguistic content and style
Factor
Effect on performance
What you can do
Language varieties and accents
Performance varies by variety; phonetic confusions
Careful articulation; where possible, a model adapted to the variety
Unstable language detection; mixed spellings and terminology
Fix the input language if possible; flag the passages in the other language
Speaking rate and style
Too fast or unclear: substitutions; hesitations: needless insertions
A moderate pace; clean pauses; short sentences
Automatic segmentation and punctuation
Sentence boundaries and punctuation sometimes wrong
Mark the end of a sentence with a short pause; reread punctuation and capitalization
The differences between speakers are not symmetrical: Koenecke et al. (2020)
document, across five commercial systems, an error rate almost twice as high
for African American speakers as for white speakers. Testing a system with
the accents and varieties it will actually be used with is part of evaluating it.
Processing mode and the chain
Factor
Effect on performance
What you can do
Live or offline
Live: fast display but more errors; offline: cleaner output after a delay
Choose according to your priority; revise offline where you can
Check the transcription before translating; turn translation off where it serves no purpose
End-to-end approach
Often smoother, but quality is uneven across languages and domains
Keep it for straightforward cases; confirm with samples; plan for a human rereading
Sources
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
O'Shaughnessy, D. (2025). Speaker diarization: A review of objectives and methods. Applied Sciences, 15(4), 2002. https://doi.org/10.3390/app15042002
Trois groupes de facteurs
Les écarts de performance observés d’une situation à l’autre ne sont pas
aléatoires. Trois groupes de facteurs les expliquent, et la plupart offrent
une marge de manœuvre concrète.
La qualité du signal
Facteur
Impact sur la performance
Solutions possibles
Qualité et placement du micro
Distance ou orientation inadéquates : chute d’intelligibilité, consonnes avalées
Micro près de la bouche (15 à 20 cm) ; éviter frottements et plosives ; faire un test audio
Bruit ambiant
Masque les sons utiles : hausse du taux d’erreur
Casque ou micro directionnel ; environnement calme ; réduction de bruit logicielle
Réverbération de la pièce
L’écho brouille les frontières de mots et de phrases
Pièce peu réverbérante ; rideaux ou panneaux ; parler face au micro
Plusieurs locuteurs, chevauchements
Diarisation imparfaite ; segments tronqués quand les voix se superposent
Microphones individuels ; tours de parole clairs ; relecture ciblée
Mauvaise connexion réseau et compression (en direct)
Artefacts, mots manqués
Connexion stable, filaire si possible ; limiter les applications concurrentes
Attribuer chaque segment au bon locuteur reste un problème ouvert,
particulièrement quand les voix se chevauchent (O’Shaughnessy, 2025) :
comptez-y une relecture attentive pour toute transcription de réunion.
Le contenu linguistique et le style
Facteur
Impact sur la performance
Solutions possibles
Variétés de langue et accents
Performance variable selon les variétés ; confusions phonétiques
Articulation soignée ; si possible, modèle adapté à la variété
Détection de langue instable ; mélange de graphies et de terminologies
Fixer la langue d’entrée si possible ; signaler les passages dans l’autre langue
Débit et style de parole
Trop rapide ou flou : substitutions ; hésitations : insertions inutiles
Vitesse modérée ; pauses nettes ; phrases courtes
Segmentation et ponctuation automatiques
Frontières de phrase et ponctuation parfois erronées
Marquer la fin de phrase par une courte pause ; relire ponctuation et casse
Les écarts selon les locuteurs ne sont pas symétriques : Koenecke et al.
(2020) documentent, pour cinq systèmes commerciaux, un taux d’erreur
presque deux fois plus élevé pour les locuteurs afro-américains que pour
les locuteurs blancs. Tester un système avec les accents et variétés
réellement visés fait partie de l’évaluation.
Le mode de fonctionnement et la chaîne de traitement
Facteur
Impact sur la performance
Solutions possibles
En direct ou en différé
En direct : affichage rapide mais plus d’erreurs ; en différé : rendu plus propre avec un délai
Choisir selon la priorité ; réviser en différé si possible
Chaîne en cascade (reconnaissance → traduction → synthèse)
Propagation des erreurs d’une étape à l’autre
Vérifier la transcription avant traduction ; désactiver la traduction si inutile
Approche de bout en bout
Souvent plus fluide, mais qualité inégale selon les langues et domaines
Réserver aux cas simples ; confirmer par échantillons ; prévoir une relecture humaine
Sources
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
O'Shaughnessy, D. (2025). Speaker diarization: A review of objectives and methods. Applied Sciences, 15(4), 2002. https://doi.org/10.3390/app15042002
Speech technology in the language professionsLes technologies de la parole dans les professions langagières
Three use cases
Translation
Dictated translation. Dictating a first draft can be faster than typing
it, and it lowers the risk of musculoskeletal disorders. Wang and Sun (2023)
found, however, that the time saved on drafting moved to revision, so a net
saving is not guaranteed. Part of that revision repairs the system and part
of it is the translator’s own: the study ties revision time to sight
translation skill, that is, to how readily a finished sentence can be
produced on the spot, where writing lets you shape it as you go. Only the
first part shrinks as recognition improves, and it has improved since 2023,
so the balance may have shifted, which is not the same as saying the finding
is no longer true.
Watch for: numbers, proper nouns, punctuation and capitalization remain the
most likely errors in a dictated transcription.
Interpreting
Computer-assisted interpreting (CAI) tools. What any one of them does
varies, and no tool has every feature, but between them they cover the whole
assignment rather than its terminology alone. Before it, a tool may pull
terms out of the documents you are sent, build a glossary from them, drill
you on it, and propose translations for terms in context. During it, the
glossary is a glance away on a second screen or a tablet, and some tools
also listen to the original speech: transcribing it, highlighting numbers as
they are spoken, and surfacing the glossary entry for a term as it comes up.
Where the audio is processed, on your own machine or in the cloud, is a
choice some of them let you make, and it decides what leaves a confidential
meeting. InterpretBank is one of the established ones (Fantinuoli,
2016).interpretbank.com
Automatic subtitling. Educational and promotional video is captioned
automatically, which is now ordinary rather than exceptional, because in
several jurisdictions accessibility is a legal requirement rather than a
courtesy. Ontario is a concrete case: since 2021, public sector bodies and
organisations of fifty or more people must conform to WCAG 2.0 Level AA on their
websites, which requires captions on prerecorded video. Live captions are
explicitly excluded from that requirement, which is worth knowing before
assuming the two are treated
alike.Ontario’s guidance: How to make websites
accessible.
Video translation with dubbing. The speaker’s voice can be cloned so
that the translated track still sounds like them, and some tools go further
and resynchronize the lips onto the target language. Where both are done,
the result plays as though the video had been recorded in that language
rather than translated into it.
Quality remains uneven, so ideally a person checks the output before anything
is published.
A critical perspective
Not necessarily faster. Speed of dictation does not guarantee a net gain in
productivity.
Metrics vs. real impact. An “acceptable” error rate can hide serious
errors on amounts, names or acronyms; qualitative evaluation in context
remains indispensable.
Fairness and inclusion. Systems have to be tested with the accents and
language varieties they will actually be used with: Koenecke et al. (2020)
document marked differences in performance between groups of speakers.
Data confidentiality. Distinguish the systems that process audio
locally, on the device, from those that send it to remote servers; that
choice decides what happens to the texts you dictate and the voices you
record.
Sources
Fantinuoli, C. (2016). InterpretBank: Redefining computer-assisted interpreting tools. Proceedings of the 38th Conference Translating and the Computer, London, 42–52. https://aclanthology.org/2016.tc-1.5/
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
Wang, L., & Sun, S. (2023). Dictating translations with automatic speech recognition: Effects on translators' performance. Frontiers in Psychology, 14, 1108898. https://doi.org/10.3389/fpsyg.2023.1108898
Trois cas d’usage
Traduction
Dictée de traduction. Dicter un premier jet peut aller plus vite que le
taper, et réduit les risques de troubles musculosquelettiques. Wang et Sun
(2023) ont cependant constaté que le temps gagné à la rédaction repartait
dans la révision, si bien que le gain net n’est pas garanti. Une partie de
cette révision répare le système, l’autre revient au traducteur : l’étude
relie le temps de révision à l’aptitude à la traduction à vue, c’est-à-dire
à la facilité avec laquelle une phrase aboutie se formule sur-le-champ, là
où l’écrit permet de la façonner en cours de route. Seule la première partie
diminue à mesure que la reconnaissance progresse, et elle a progressé depuis
2023 : l’équilibre a pu se déplacer, ce qui ne veut pas dire que le constat
ne tient plus.
Points de vigilance : les nombres, les noms propres, la ponctuation et la
casse restent les erreurs les plus probables d’une transcription dictée.
Interprétation
Outils d’interprétation assistée par ordinateur (angl.
computer-assisted interpreting, CAI). Ce que fait tel ou tel outil
varie, et aucun ne réunit toutes les fonctions, mais ensemble elles
accompagnent toute la prestation et pas seulement sa terminologie. En amont,
un outil peut extraire les termes des documents reçus, en constituer un
glossaire, vous le faire mémoriser et proposer des traductions de termes en
contexte. Pendant la prestation, le glossaire se consulte d’un coup d’œil
sur un second écran ou une tablette, et certains outils écoutent aussi le
discours original : ils le transcrivent, mettent les nombres en évidence à
mesure qu’ils sont prononcés et font apparaître l’entrée de glossaire d’un
terme quand il arrive. Le lieu du traitement de l’audio, votre machine ou le
nuage, est un choix que certains vous laissent, et il décide de ce qui sort
d’une réunion confidentielle. InterpretBank est l’un des plus établis
(Fantinuoli,
2016).interpretbank.com
Ces outils sont conçus pour soutenir une interprète plutôt que pour la
remplacer, ce qui ne veut pas dire qu’aucun remplacement n’a lieu.
Sous-titrage automatique. Les vidéos éducatives et promotionnelles se
sous-titrent automatiquement, ce qui est devenu courant plutôt
qu’exceptionnel, parce que plusieurs législations font de l’accessibilité
une obligation et non une politesse. L’Ontario en est un cas concret :
depuis 2021, les organismes du secteur public et les organisations de
cinquante personnes ou plus doivent respecter le niveau AA des WCAG 2.0 sur
leurs sites, ce qui exige le sous-titrage des vidéos préenregistrées. Le
sous-titrage en direct est explicitement exclu de cette obligation, ce qui
vaut la peine d’être su avant de supposer que les deux sont traités
pareil.Les indications de l’Ontario : How to make websites
accessible.
Traduction vidéo avec doublage. La voix de l’oratrice peut être clonée
pour que la piste traduite lui ressemble encore, et certains outils vont
plus loin en resynchronisant les lèvres sur la langue cible. Quand les deux
sont faits, le résultat passe comme une vidéo tournée dans cette langue
plutôt que traduite vers elle.
La qualité reste variable, si bien qu’idéalement une personne vérifie le
résultat avant toute diffusion.
Perspective critique
Pas nécessairement plus rapide. La vitesse de dictée ne garantit pas un gain
de productivité net.
Métriques contre impact réel. Un taux d’erreur « acceptable » peut masquer
des erreurs graves sur les montants, les noms ou les sigles ;
l’évaluation qualitative en contexte reste indispensable.
Équité et inclusion. Les systèmes doivent être testés avec les accents
et variétés linguistiques réellement visés : Koenecke et al. (2020)
documentent des écarts de performance marqués selon les groupes de
locuteurs.
Confidentialité des données. Distinguez les systèmes qui traitent
l’audio localement, sur l’appareil, de ceux qui l’envoient sur des
serveurs distants ; le choix engage la confidentialité des textes
dictés et des voix enregistrées.
Sources
Fantinuoli, C. (2016). InterpretBank: Redefining computer-assisted interpreting tools. Proceedings of the 38th Conference Translating and the Computer, London, 42–52. https://aclanthology.org/2016.tc-1.5/
Koenecke, A., Nam, A., Lake, E., Nudell, J., Quartey, M., Mengesha, Z., Toups, C., Rickford, J. R., Jurafsky, D., & Goel, S. (2020). Racial disparities in automated speech recognition. Proceedings of the National Academy of Sciences, 117(14), 7684–7689. https://doi.org/10.1073/pnas.1915768117
Wang, L., & Sun, S. (2023). Dictating translations with automatic speech recognition: Effects on translators' performance. Frontiers in Psychology, 14, 1108898. https://doi.org/10.3389/fpsyg.2023.1108898
🔒 Speech: exercisesParole : exercicesis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Speech: exercisesParole : exercices
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Demo: dictation in WordDémo : la dictée dans Word
Before you start with Word
Setting it up
The exercise has to be done in English: the English voice commands do
not work on French text, and the French commands exist but do less. Set the
dictation language to “English (United States)” or another English variety:
open Word and go to the Home tab;
click the Dictate button (microphone icon);
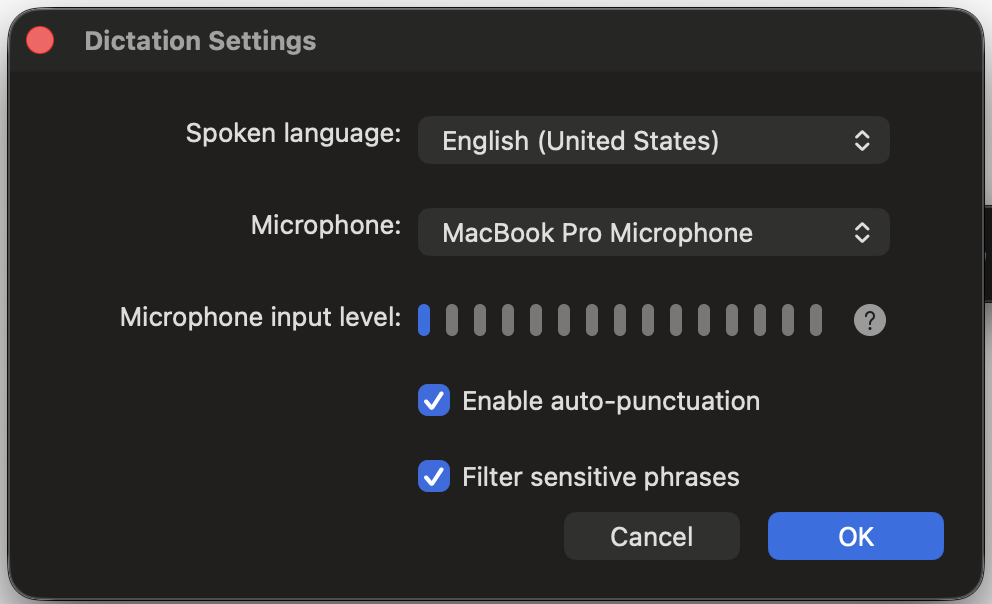
click the gear icon (settings);
under “Spoken Language”, select English (United States);
turn on Auto punctuation to begin with (you will also try it off);
leave Filter sensitive phrases on.
Figure 1. The Dictate button Figure 2. The settings of Word's Dictate feature
Turning dictation on
The Dictate button on the Home tab is the way in on every platform. On
Windows there is also a keyboard shortcut, Alt + ` (tilde key); a Mac has no
Alt key and Microsoft’s own steps there give only the button.
Figure 3. Where the Dictate button sits on the Word ribbon (Home tab)
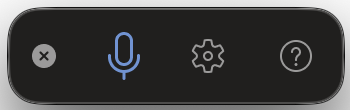
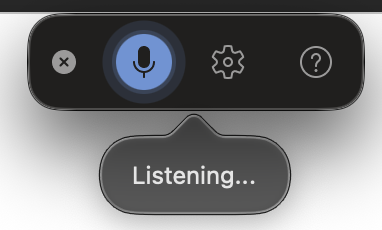
A floating toolbar appears, with a microphone (start and stop), a
“Listening” indicator while dictation is running, the gear icon for the
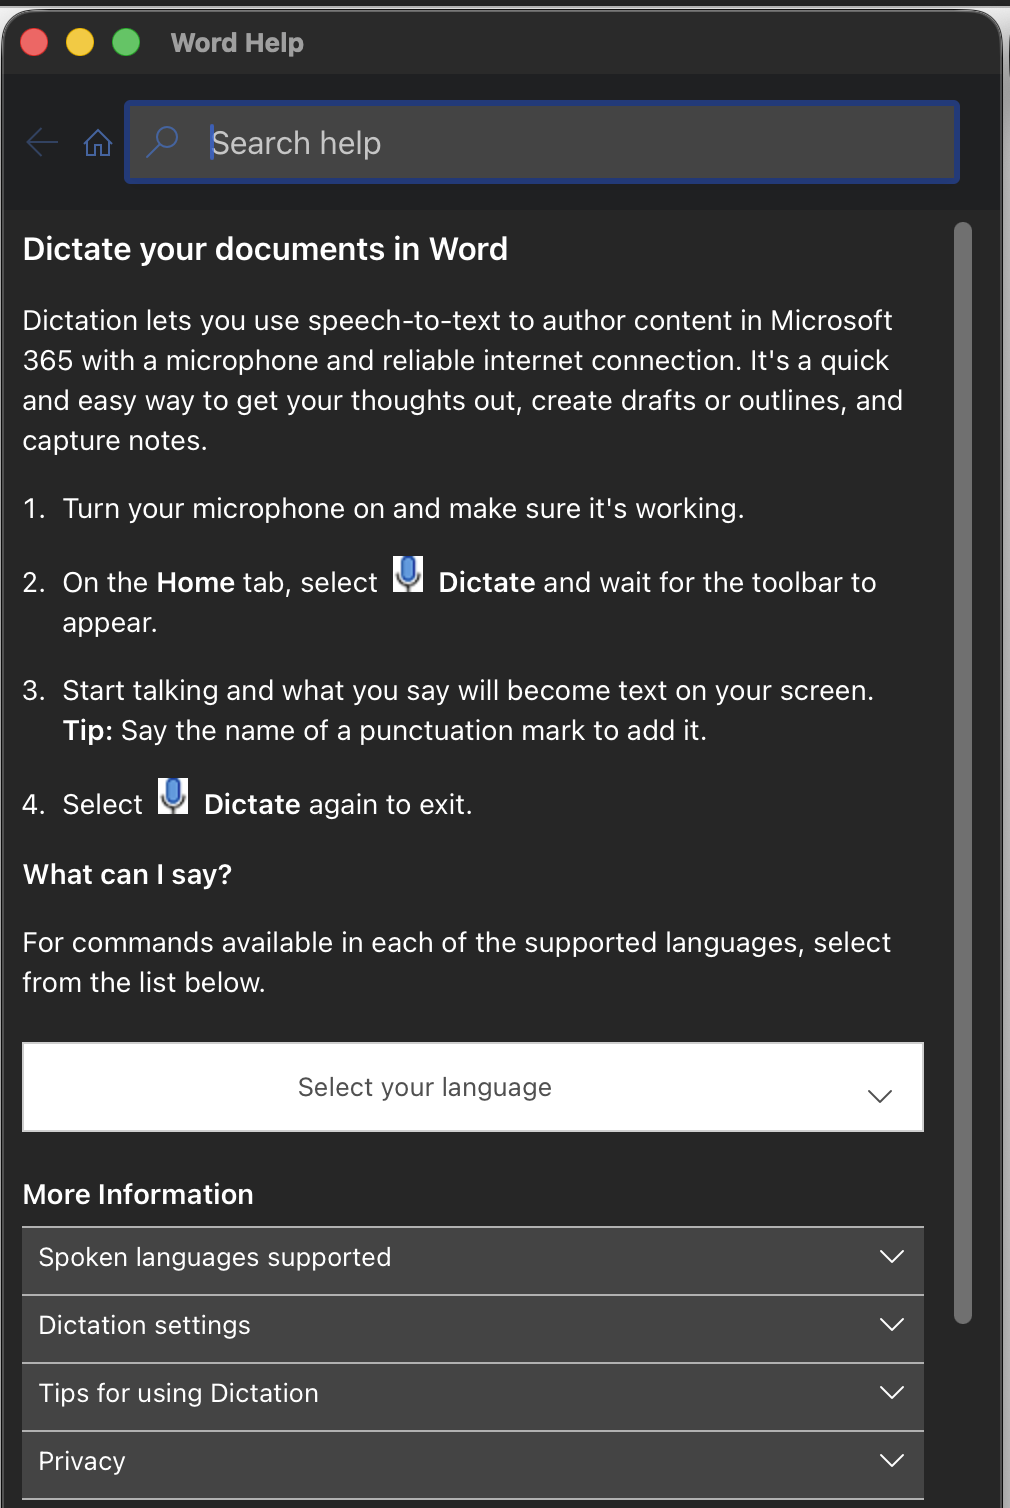
settings and a help button (?) listing the commands.
Figure 4. The floating toolbar of the Dictate feature Figure 5. The same toolbar while dictation is running
The voice commands you need
With Auto punctuation on, Word places full stops and commas itself; with
it off, every mark has to be dictated with the commands below. Run the
practice exercise both ways: the difference shows how much of the punctuation
you would be dictating in real work, and how often the automatic version puts
a mark where you did not want one.
Punctuation:
Say
Result
“period” or “full stop”
.
“comma”
,
“question mark”
?
“exclamation mark”
!
“colon”
:
“semicolon”
;
“open quotes” … “close quotes”
”…”
“new line”
new line
Editing:
Say
Action
“delete”
deletes the last word or mark
“delete that”
deletes the last sentence dictated
“delete [word or phrase]”
deletes a specific word or phrase
“select [word/phrase]”
selects text
“backspace [1-100]”
deletes that many characters back
“undo”
undoes the last action
Formatting:
Say
Action
“bold [word/phrase]” or “bold that”
sets in bold
“italicize [word/phrase]”
sets in italics
“underline [word/phrase]”
underlines
“start list”
starts a bulleted list
“start numbered list”
starts a numbered list
“exit list”
ends the list
Figure 6. The (?) button on the toolbar opens Word's own help, where the command list is given per language
L’exercice doit être effectué en anglais : les commandes vocales
anglaises ne fonctionnent pas sur du texte français, et les commandes
françaises existent mais sont plus limitées. Configurez la langue de dictée
sur « English (United States) » ou une autre variante anglaise :
ouvrez Word et allez dans l’onglet Accueil (Home) ;
cliquez sur le bouton Dicter (Dictate, icône de microphone) ;
cliquez sur l’icône d’engrenage (paramètres) ;
sous « Spoken Language », sélectionnez English (United States) ;
activez Auto punctuation pour commencer (vous l’essaierez aussi désactivée) ;
laissez Filter sensitive phrases activé.
Figure 1. Le bouton Dicter Figure 2. Paramètres de la fonction Dicter dans Word
Activer la dictée
Le bouton Dicter de l’onglet Accueil fonctionne sur toutes les
plateformes. Sous Windows, il existe aussi un raccourci clavier, Alt + `
(touche tilde) ; un Mac n’a pas de touche Alt, et les étapes de Microsoft n’y
donnent que le bouton.
Figure 3. Emplacement du bouton Dicter dans le ruban Word (onglet Accueil)
Une barre d’outils flottante apparaît, avec un microphone (démarrer et
arrêter), un indicateur « Listening » quand la dictée est active, l’icône
d’engrenage des paramètres et un bouton d’aide (?) listant les commandes.
Figure 4. La barre d'outils flottante de la fonction Dicter Figure 5. La même barre pendant que la dictée tourne
Commandes vocales essentielles (en anglais)
Avec Auto punctuation activée, Word place lui-même les points et les
virgules ; sans elle, chaque signe doit être dicté avec les commandes
ci-dessous. Faites l’exercice de pratique des deux façons : la différence
montre quelle part de la ponctuation vous auriez à dicter dans un vrai
travail, et à quelle fréquence la version automatique place un signe dont
vous ne vouliez pas.
Ponctuation :
Dire
Résultat
“period” ou “full stop”
.
“comma”
,
“question mark”
?
“exclamation mark”
!
“colon”
:
“semicolon”
;
“open quotes” … “close quotes”
”…”
“new line”
nouvelle ligne
Édition :
Dire
Action
“delete”
supprime le dernier mot ou signe
“delete that”
supprime la dernière phrase dictée
“delete [word or phrase]”
supprime un mot ou une expression
“select [word/phrase]”
sélectionne du texte
“backspace [1-100]”
supprime ce nombre de caractères vers l’arrière
“undo”
annule la dernière action
Mise en forme :
Dire
Action
“bold [word/phrase]” ou “bold that”
met en gras
“italicize [word/phrase]”
met en italique
“underline [word/phrase]”
souligne
“start list”
démarre une liste à puces
“start numbered list”
démarre une liste numérotée
“exit list”
termine la liste
Figure 6. Le bouton (?) de la barre ouvre l'aide de Word, où la liste des commandes est donnée par langue
Assignment: correcting a memo by voiceTravail : corriger un mémo à la voix
Practice exercise (5 min, not graded)
Copy the following text into Word and make the corrections by voice alone:
The cat sat on the matThe dog was happpy[ADD: Insert a sentence about birds here]Make the word cat bold
Add a period after “mat”.
Remove one “p” from “happpy”.
Add the missing sentence: “The birds flew over the trees.”
Set the word “cat” in bold.
Practise first with auto punctuation on, then try without it, to see the
difference.
Main exercise (20 min)
The situation. You are an intern at TranslatoCorp International, a
translation agency that has just adopted a dictation-only policy following a
mysterious outbreak of finger cramps. The CEO, Mr. Verbatim, has dictated a
memo, but the recognition system had a few mishaps. Your mission: correct
the memo using voice commands only.
What is allowed:
copying and pasting the initial text into Word;
using the mouse or keyboard to navigate (place the cursor, scroll);
clicking to put the cursor at the exact place of a change.
What is not allowed:
typing text on the keyboard;
using the Delete or Backspace keys;
using Ctrl+B, Ctrl+I or other formatting shortcuts;
any entry or change of text other than by voice command.
A tip: to add punctuation in the middle of a sentence, click at the place
you want with the mouse, then dictate the punctuation (“comma”).
Text to correct:
URGENT MEMO TO ALL TRANSLATORSFrom the desk of CEO Maximilian VerbatimDear translation minions[INSERT: Add greeting about the weather being perfect for translation]As you know our company motto is Accuracy Speed and cofffee We pride ourselves on deliveringtranslations faster than a caffeinated cheetah running from an angry proofreaderRecent UpdatesYesterday we successfully translated the entire works of Shakespeare into emojiOur new office mascot is a parrot named PolyglottThe coffee machine now speaks seventeen languages but still makes terrible espresso[INSERT: Add a sentence about our new virtual reality translation booths]Important RemindersPlease stop using Google Translate to translate the lunch menu from FrenchThe term deadline is not meant to be taken literally despite what project managers sayRemember machine translation is our friend not our replacment[INSERT: Add final motivational sentence]Best regardsMax VerbatimCEO and Chief Word WranglerPS The office plants need watering They are looking as dry as academic prose
Corrections to make, by voice only:
Punctuation: a colon after “Dear translation minions”; commas in
“Accuracy Speed and coffee”; periods at the end of the sentences that
lack them.
first [INSERT]: “Good morning everyone! The weather is perfect for
indoor translation work.”
second [INSERT]: “Our new VR booths let you translate while pretending
to be on a tropical beach.”
third [INSERT]: “Together, we shall conquer the Tower of Babel, one
mistranslation at a time!”
Formatting: “URGENT MEMO TO ALL TRANSLATORS” in bold; “Polyglott” in
italics; the three points under “Recent Updates” as a bulleted list; the
three points under “Important Reminders” as a numbered list.
Navigation and editing: delete “and Chief Word Wrangler” after CEO;
add an exclamation mark after “as dry as academic prose”.
Reflection (to be dictated in Word)
Once the exercise is done, dictate your answers to the following questions
straight into the same document (100 to 150 words in total):
Difficulties encountered. Which voice commands were the hardest to use, and
why?
Expectations and reality. Was the exercise easier or harder than you
expected? Why?
Recognition accuracy. Was everything recognized as you intended?
Which kinds of word or phrase caused trouble?
Practical application. From this experience, do you think dictation
would improve your translation workflow? Justify your answer briefly.
The reflection has to be dictated as well: it is one more chance to observe
how the system handles a more natural, conversational text.
What to produce: a single Word document containing the corrected memo and
your dictated reflection.
Exercice de pratique (5 min, non noté)
Copiez le texte suivant dans Word et effectuez les corrections uniquement à
la voix :
The cat sat on the matThe dog was happpy[ADD: Insert a sentence about birds here]Make the word cat bold
Ajoutez un point après « mat ».
Supprimez un « p » dans « happpy ».
Ajoutez la phrase manquante : « The birds flew over the trees. »
Mettez le mot « cat » en gras.
Pratiquez d’abord avec l’auto-ponctuation activée, puis essayez sans, pour
voir la différence.
Exercice principal (20 min)
Contexte. Vous êtes stagiaire chez TranslatoCorp International, une
agence de traduction qui vient d’adopter une politique « tout-dictée » à la
suite d’une épidémie mystérieuse de crampes des doigts. Le PDG, M. Verbatim,
a dicté une note de service, mais le système de reconnaissance a connu
quelques ratés. Votre mission : corriger le mémo en utilisant uniquement des
commandes vocales.
Ce qui est permis :
copier-coller le texte initial dans Word ;
utiliser la souris ou le clavier pour naviguer (placer le curseur,
faire défiler) ;
cliquer pour placer le curseur à l’endroit exact d’une modification.
Ce qui n’est pas permis :
taper du texte au clavier ;
utiliser les touches Delete ou Backspace ;
utiliser Ctrl+B, Ctrl+I ou d’autres raccourcis de mise en forme ;
toute saisie ou modification de texte autrement que par commandes vocales.
Astuce : pour ajouter de la ponctuation au milieu d’une phrase, cliquez à
l’endroit voulu avec la souris, puis dictez la ponctuation (« comma »).
Texte à corriger :
URGENT MEMO TO ALL TRANSLATORSFrom the desk of CEO Maximilian VerbatimDear translation minions[INSERT: Add greeting about the weather being perfect for translation]As you know our company motto is Accuracy Speed and cofffee We pride ourselves on deliveringtranslations faster than a caffeinated cheetah running from an angry proofreaderRecent UpdatesYesterday we successfully translated the entire works of Shakespeare into emojiOur new office mascot is a parrot named PolyglottThe coffee machine now speaks seventeen languages but still makes terrible espresso[INSERT: Add a sentence about our new virtual reality translation booths]Important RemindersPlease stop using Google Translate to translate the lunch menu from FrenchThe term deadline is not meant to be taken literally despite what project managers sayRemember machine translation is our friend not our replacment[INSERT: Add final motivational sentence]Best regardsMax VerbatimCEO and Chief Word WranglerPS The office plants need watering They are looking as dry as academic prose
Corrections à effectuer, à la voix uniquement :
Ponctuation : deux-points après « Dear translation minions » ; virgules
dans « Accuracy Speed and coffee » ; points à la fin des phrases qui en
manquent.
Orthographe : « cofffee » devient « coffee » ;
« replacment » devient « replacement ».
Ajouts de texte :
premier [INSERT] : « Good morning everyone! The weather is perfect for
indoor translation work. »
deuxième [INSERT] : « Our new VR booths let you translate while
pretending to be on a tropical beach. »
troisième [INSERT] : « Together, we shall conquer the Tower of Babel,
one mistranslation at a time! »
Mise en forme : « URGENT MEMO TO ALL TRANSLATORS » en gras ;
« Polyglott » en italique ; les trois points sous « Recent Updates » en liste
à puces ; les trois points sous « Important Reminders » en liste numérotée.
Navigation et édition : supprimez « and Chief Word Wrangler » après
CEO ; ajoutez un point d’exclamation après « as dry as academic prose ».
Réflexion (à dicter dans Word)
Une fois l’exercice terminé, dictez vos réponses aux questions suivantes
directement dans le même document (100 à 150 mots au total) :
Difficultés rencontrées. Quelles commandes vocales ont été les plus
difficiles à utiliser, et pourquoi ?
Attentes et réalité. L’exercice était-il plus facile ou plus
difficile que prévu ? Pourquoi ?
Précision de la reconnaissance. Tout a-t-il été reconnu comme prévu ?
Quels types de mots ou de phrases ont posé problème ?
Application pratique. À partir de cette expérience, pensez-vous que
la dictée améliorerait votre flux de travail de traduction ? Justifiez
brièvement.
La réflexion aussi doit être dictée : c’est une occasion supplémentaire
d’observer comment le système gère un texte plus naturel et conversationnel.
À produire : un document Word unique contenant le mémo corrigé et votre
réflexion dictée.
Demo: live captions in PowerPointDémo : sous-titres en direct dans PowerPoint
Before you start with PowerPoint
Requirements: PowerPoint for Microsoft 365 (desktop version), a working
microphone and a quiet environment. Estimated time: 25 minutes.
What you will do:
trying out live transcription of a spoken presentation;
testing real-time translation (French to English);
gauging the effect of various factors on caption quality;
comparing monolingual captioning against live machine translation.
Setting up the tool (5 min)
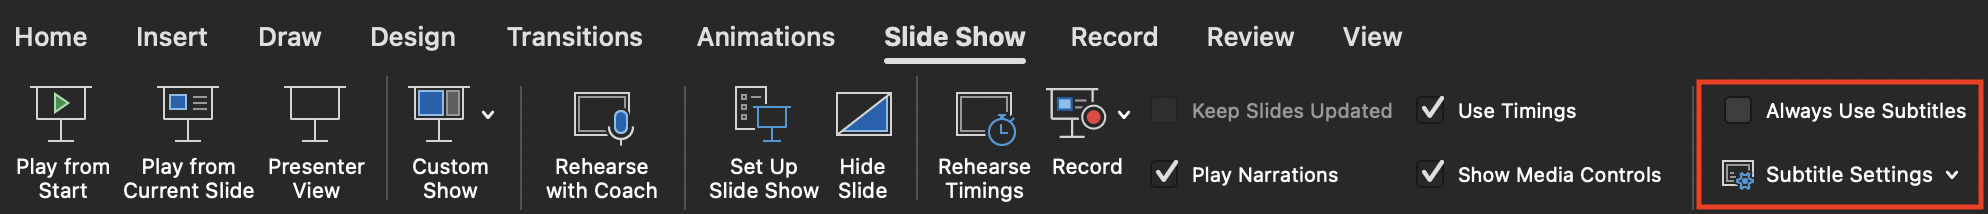
Figure 7. The subtitle options on the Slide Show tab of the PowerPoint ribbon
Open PowerPoint (the desktop version, not the web version).
Spoken Language: check whether “French (Canada)” is available; if not,
use “French” or “French (France)”. Whether Canadian French is offered
varies by version.
Subtitle Language: the same language as the spoken one for test 1;
English for test 2.
Position: “Below Slide” (recommended).
Microphone: select your main microphone.
Test your microphone before you start: in the system settings, make sure the
input level is right, neither too low nor saturated.
Prérequis : PowerPoint pour Microsoft 365 (version bureau), un microphone
fonctionnel et un environnement calme. Durée estimée : 25 minutes.
Ce que vous ferez :
expérimenter la transcription en direct d’une présentation orale ;
tester la traduction en temps réel (français → anglais) ;
évaluer l’impact de différents facteurs sur la qualité des sous-titres ;
comparer sous-titrage monolingue et traduction automatique en direct.
Configurer l’outil (5 min)
Figure 7. Les options de sous-titres dans l'onglet Diaporama du ruban PowerPoint
Ouvrez PowerPoint (version bureau, pas la version web).
Allez à l’onglet Diaporama (Slide Show) dans le ruban.
Cochez « Toujours utiliser les sous-titres » (Always Use Subtitles).
Cliquez sur « Paramètres de sous-titres » (Subtitle Settings) pour configurer.
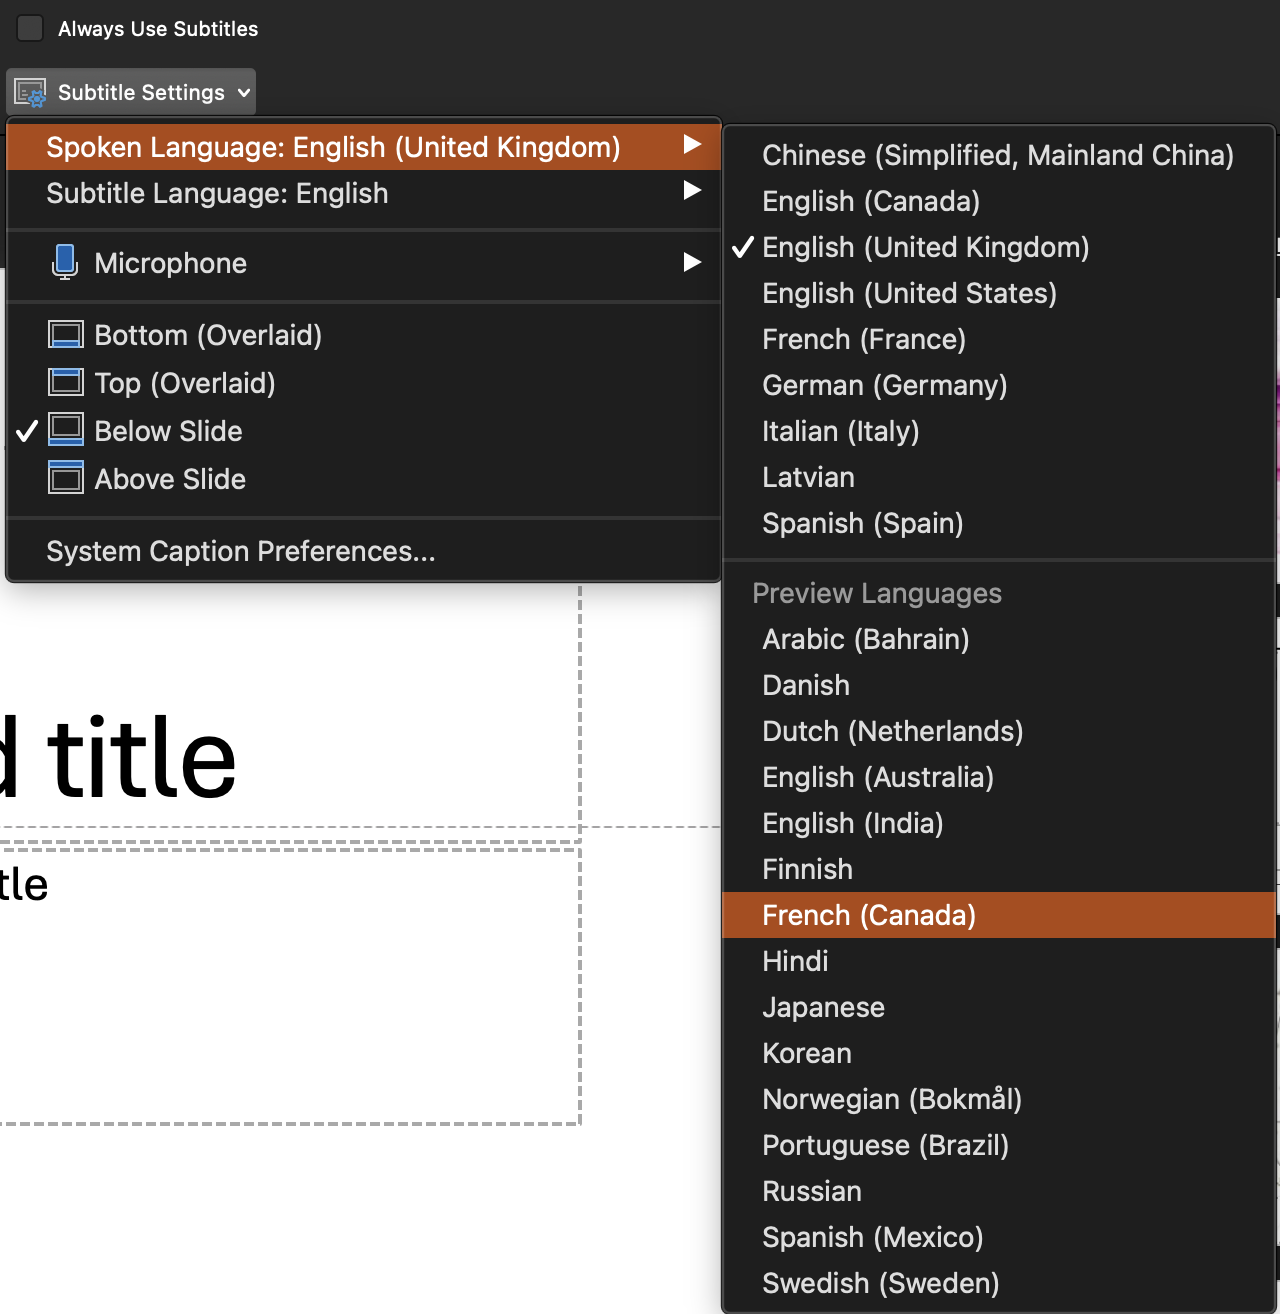
Figure 8. Paramètres de sous-titres : langue parlée, langue des sous-titres, position, microphone
Paramètres à configurer :
Langue parlée (Spoken Language) : vérifiez si « Français (Canada) » est disponible ;
sinon, utilisez « Français » ou « Français (France) ». La disponibilité du
français canadien varie selon les versions.
Langue des sous-titres (Subtitle Language) : la même langue que la langue parlée pour le
test 1 ; l’anglais pour le test 2.
Position : « Sous la diapositive » (Below Slide, recommandé).
Microphone : sélectionnez votre micro principal.
Testez votre microphone avant de commencer : dans les paramètres du système,
assurez-vous que le niveau d’entrée est adéquat, ni trop faible ni saturé.
Assignment: captioning a presentationTravail : sous-titrer une présentation
The exercise (20 min)
Use the PowerPoint file on the theme of TranslatoCorp International
(continuing the example from the Word demo), that is
available on StudiUM. It contains 6 slides with diverse challenges for the
captioning:
Title and introduction (normal text): “TranslatoCorp International
announces a strategic merger”.
Key figures (normal text): a test of numbers, amounts, percentages.
New AI technology (normal text): technical terminology and acronyms
(NMT, BERT, GPT).
Transition (text turned into an image): from this slide on,
PowerPoint can no longer read the text to improve the captions; watch for
the difference in quality.
Distance and rate test (text turned into an image): move away from
the microphone (about a metre) and read the text quickly.
Accent test (text turned into an image): exaggerate your Québec
accent (or another one); the slide gathers what recognition struggles
with, place and personal names (Hull, Sept-Îles, Jean-François
Bérubé-Lépine), long rare words (“hyperparamétrisation”) and words with
variable pronunciation (“août”).
Test 1: monolingual captioning (French to French)
Set spoken language = subtitle language = French.
Start the slide show (F5).
Present each slide by reading the text provided: normally for the first
three, then following the instructions given on the last three.
Take at least one screenshot showing the captions.
Test 2: live translation (French to English)
Set spoken language = French, subtitle language = English.
Repeat exactly the same presentation.
Take at least one screenshot showing the captions.
Ground rules: do not change the text on the slides; follow the distance, rate and
accent instructions given on the last two slides; make sure the captions are visible in
your screenshots.
What to produce: screenshots and a reflection
Screenshots: at least one per test.
A reflection (150 to 200 words) covering the following points:
Transcription accuracy: which kinds of error in monolingual mode?
Give two or three precise examples.
Effect of the slide text: did you notice a difference between
the first three slides (text) and the last three (images)?
Translation quality: was the translation into English
understandable? Were the technical terms translated well?
Performance factors: what effect did distance, speed and, where
applicable, accent have?
Practical application: would this feature be useful for your own
professional presentations? In which settings, and with what limits?
L’exercice (20 min)
Utilisez le fichier PowerPoint sur le thème de
TranslatoCorp International (suite de l’exemple de la
démo Word), disponible sur StudiUM. Il contient six
diapositives présentant des défis variés pour le sous-titrage :
Titre et introduction (texte normal) : « TranslatoCorp International
annonce une fusion stratégique ».
Chiffres clés (texte normal) : test des nombres, montants,
pourcentages.
Nouvelle technologie IA (texte normal) : terminologie technique et
sigles (NMT, BERT, GPT).
Transition (texte converti en image) : à partir de cette diapositive,
PowerPoint ne peut plus lire le texte pour améliorer les sous-titres ;
observez la différence de qualité.
Test de distance et de débit (texte converti en image) :
éloignez-vous du microphone (environ 1 mètre) et parlez rapidement en
lisant le texte.
Test d’accent (texte converti en image) : exagérez votre accent
québécois (ou autre) ; la diapositive réunit ce qui met la reconnaissance
en difficulté, des noms de lieux et de personnes (Hull, Sept-Îles,
Jean-François Bérubé-Lépine), des mots longs et rares
(« hyperparamétrisation ») et des mots à prononciation variable
(« août »).
Test 1 : sous-titrage monolingue (français → français)
Configurez langue parlée = langue des sous-titres = français.
Lancez le diaporama (F5).
Présentez chaque diapositive en lisant le texte fourni : normalement pour
les trois premières, puis en suivant les instructions données sur les
trois dernières.
Capturez au moins une capture d’écran montrant les sous-titres.
Test 2 : traduction en direct (français → anglais)
Configurez langue parlée = français, langue des sous-titres = anglais.
Répétez exactement la même présentation.
Capturez au moins une capture d’écran montrant les sous-titres.
À respecter : ne modifiez pas le texte des diapositives ; suivez les
instructions de distance, de débit et d’accent données sur les deux
dernières diapositives ;
assurez-vous que les sous-titres sont visibles sur vos captures.
À produire : des captures et une réflexion
Captures d’écran : au moins une par test.
Réflexion (150 à 200 mots) abordant les points suivants :
Précision de la transcription : quels types d’erreurs en mode
monolingue ? Donnez deux ou trois exemples précis.
Impact du texte des diapositives : avez-vous remarqué une
différence entre les trois premières diapositives (texte) et les trois
dernières (images) ?
Qualité de la traduction : la traduction vers l’anglais était-elle
compréhensible ? Les termes techniques ont-ils été bien traduits ?
Facteurs de performance : quel effet ont eu la distance, la
vitesse et, le cas échéant, l’accent ?
Application pratique : cette fonctionnalité serait-elle utile pour
vos présentations professionnelles ? Dans quels contextes, avec
quelles limites ?
Demo: video translation with HeyGenDémo : traduction vidéo avec HeyGen
Before you start with HeyGen
HeyGen is a commercial AI video translation platform: it transcribes the
audio track, translates it, generates a cloned voice in the target language
and resynchronizes the lips. The company advertises support for more than
175 languages; a free tier exists, with limited credits.
Estimated time: 30 minutes.
What you will do:
trying out speech-to-speech translation applied to video;
assessing the quality of the voice cloning and the lip synchronization;
understanding the trade-offs between automation and quality;
thinking through the ethical implications of voice cloning.
Data confidentiality: read this before you start
HeyGen is a commercial service whose terms for the use of data have to be
understood before you use it. According to its privacy policy (updated
11 August 2026):
HeyGen collects “user inputs”: videos, images, voices and scripts
uploaded;
for non-enterprise accounts, free accounts among them, these data may be
used to train and improve the service’s models;
enterprise accounts are governed by separate contracts and are exempt;
HeyGen states that it does not sell personal data to third parties;
you can request the deletion of your data, which HeyGen aims to process
within 72 hours.
Concretely, for this exercise: if you use a free account with your own
video, your face, your voice and anything visible or audible in it could
serve to train the models. Opting out is possible, but you have to ask for
it; after the exercise, you can request the deletion of your account and
your data.
What to avoid, without exception:
uploading video of identifiable people without their explicit, informed
consent;
including client work or confidential information;
using your own image if the potential use for training makes you
uncomfortable.
Create a free account (an email address is required).
Check your email and log in to the dashboard.
The free tier gives a limited credit: find your way through the steps below
before launching a translation, so that you do not waste your credits. If you
run into technical problems, document them in your reflection.
The path through the interface
Screenshots taken on 2 September 2026 and 3 September 2026: HeyGen’s interface changes
often, so expect differences.
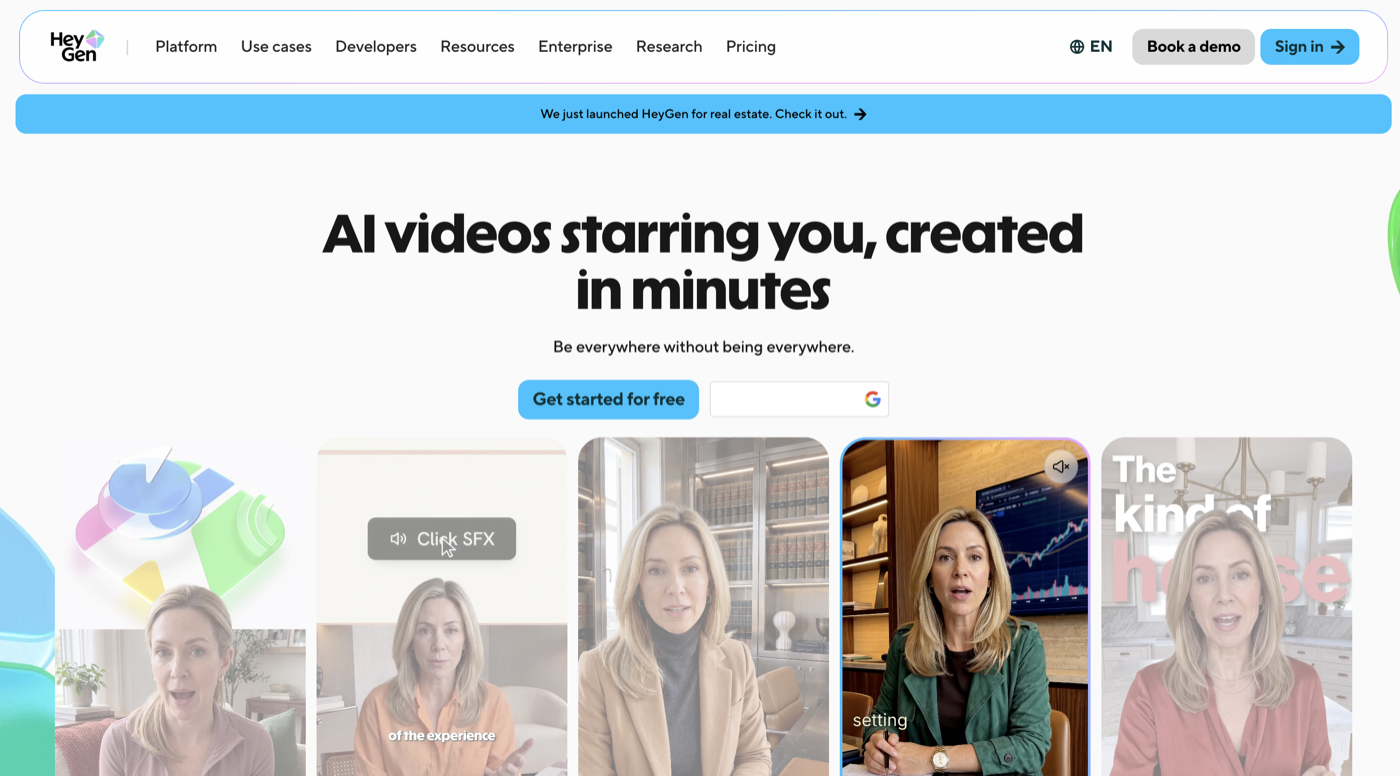
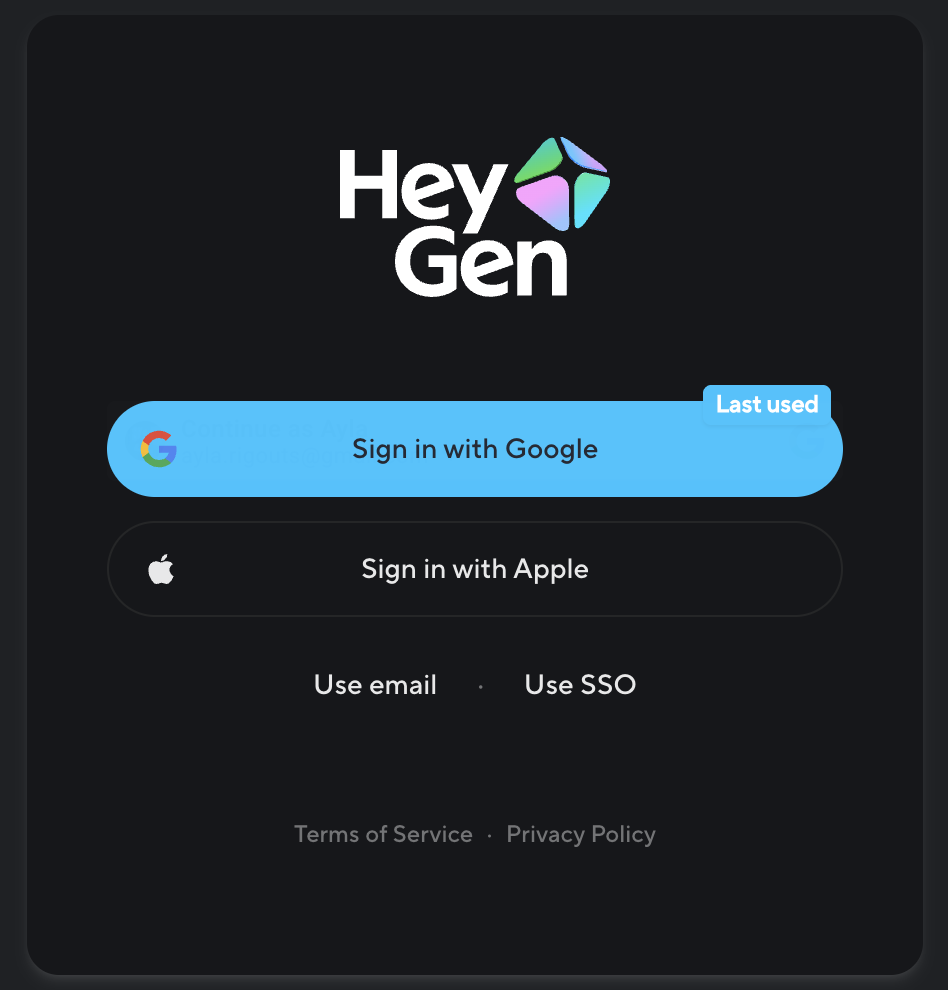
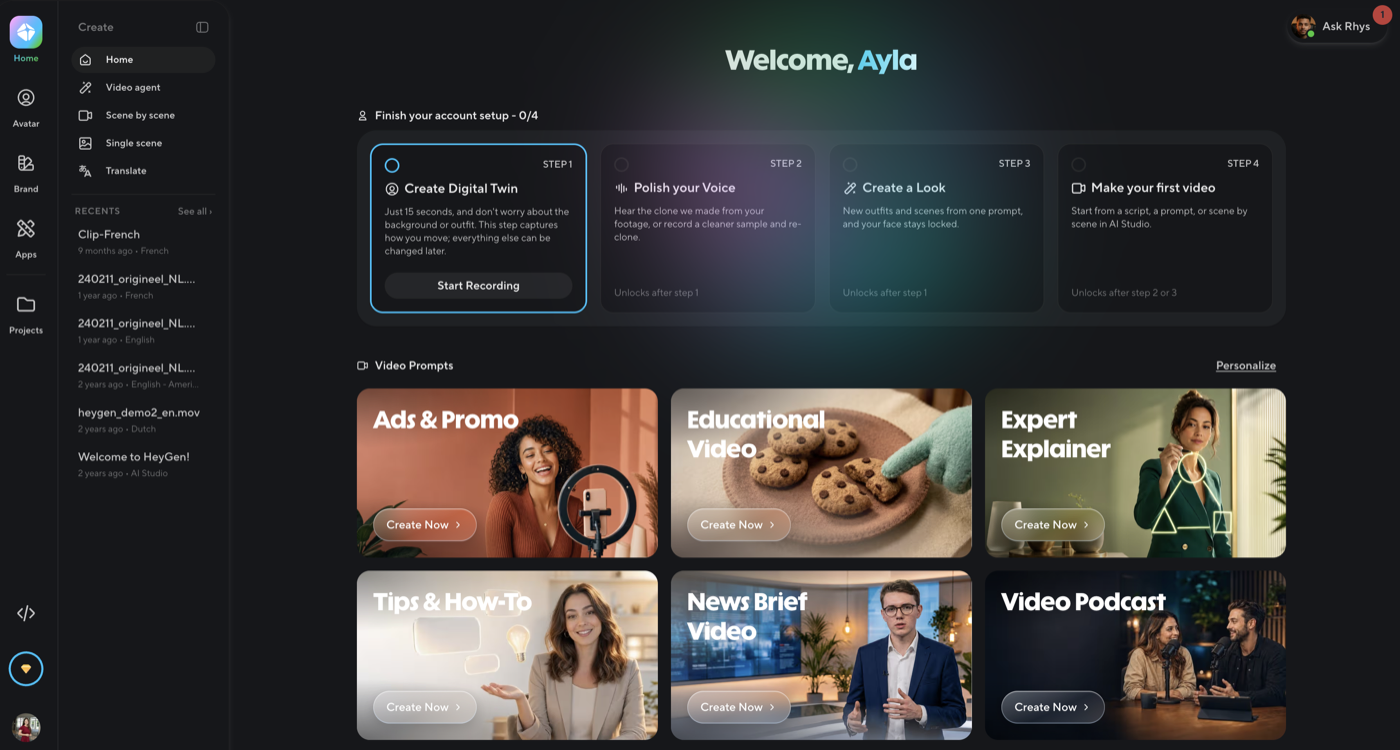
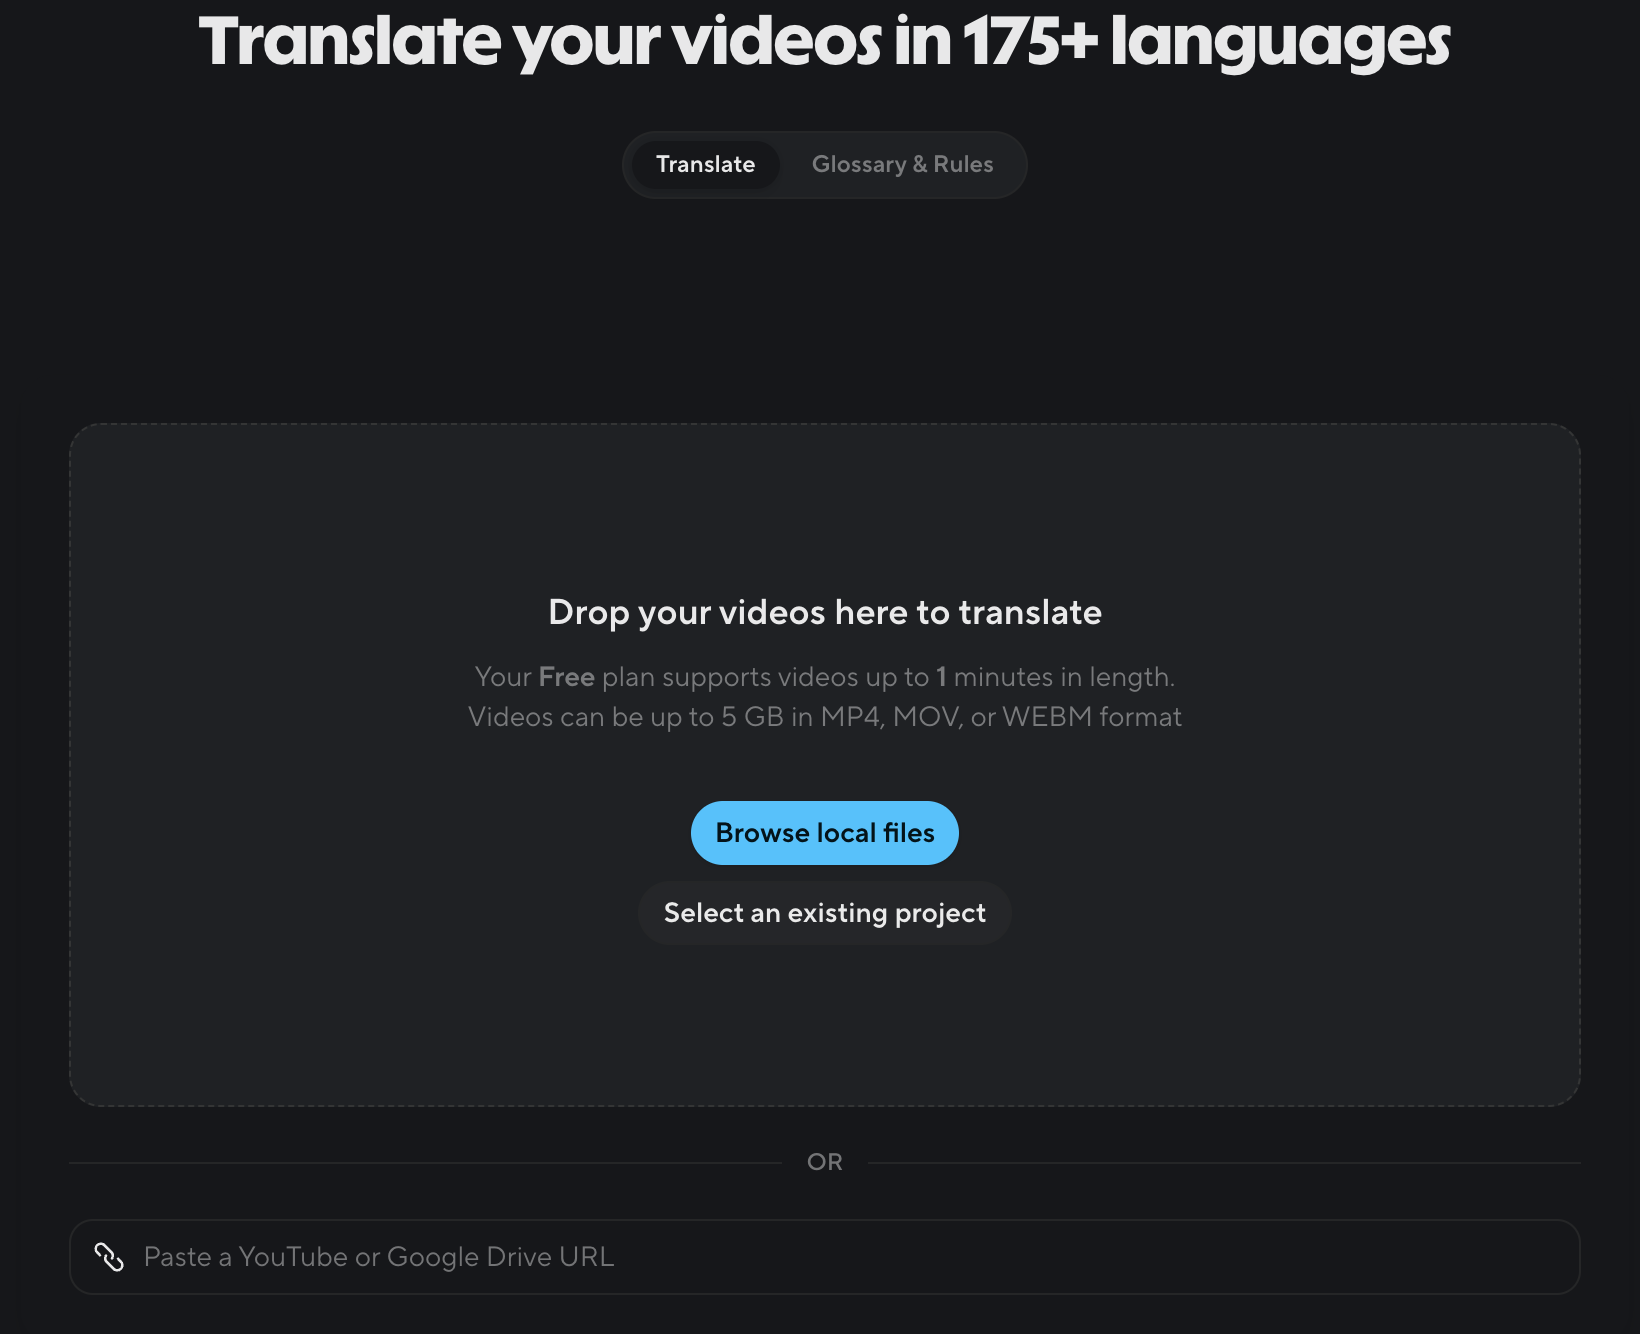
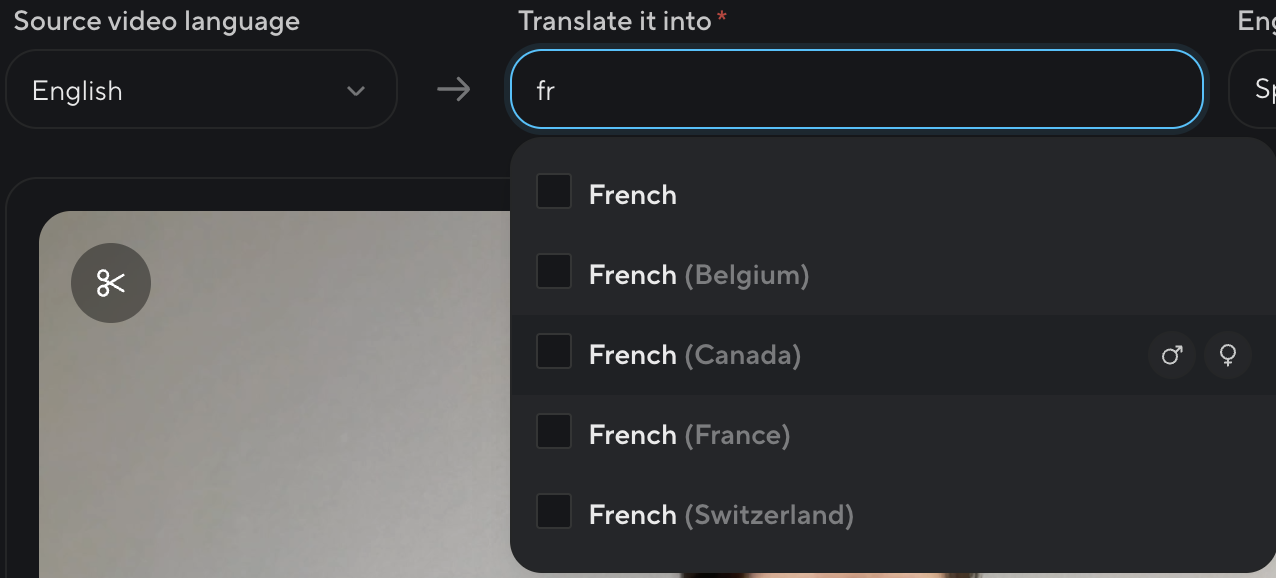
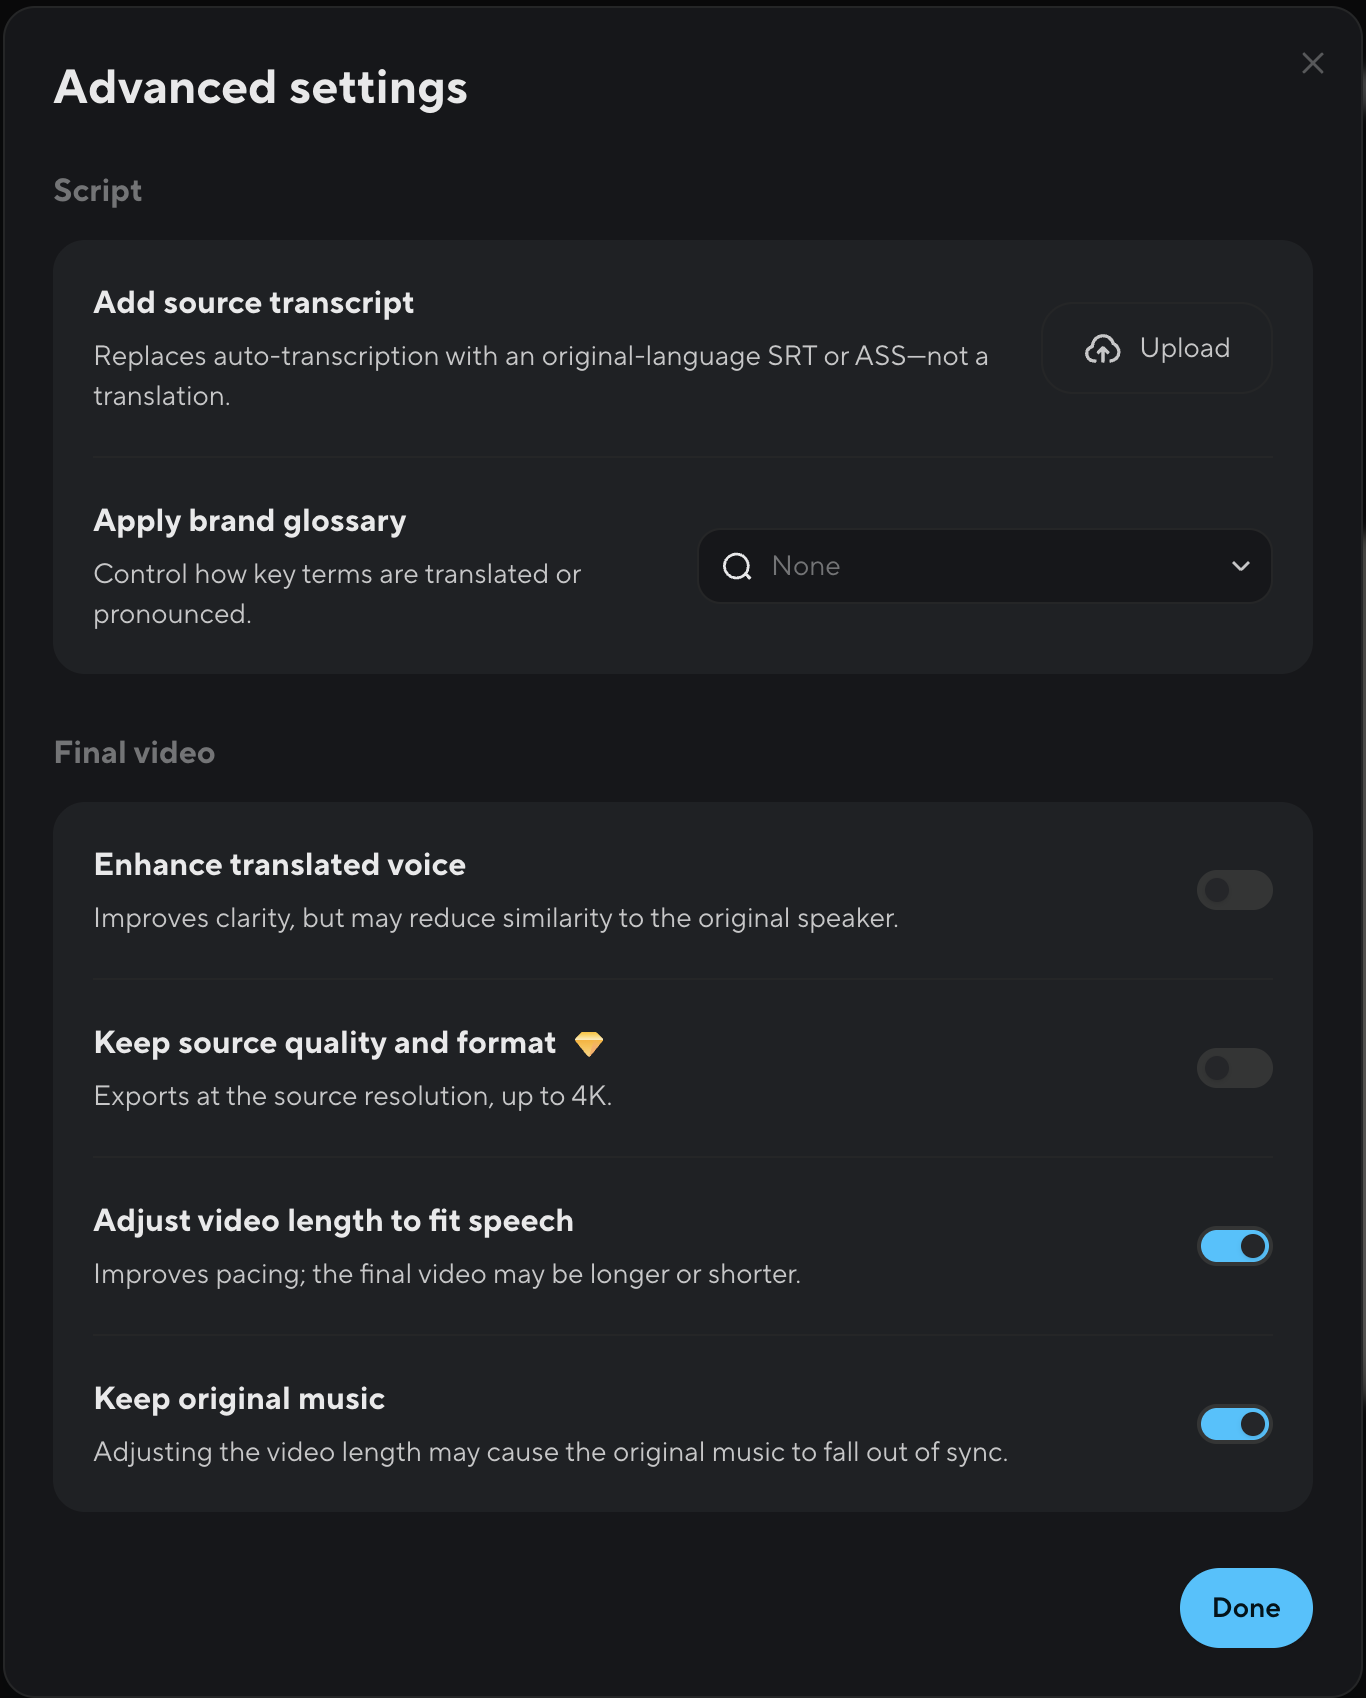
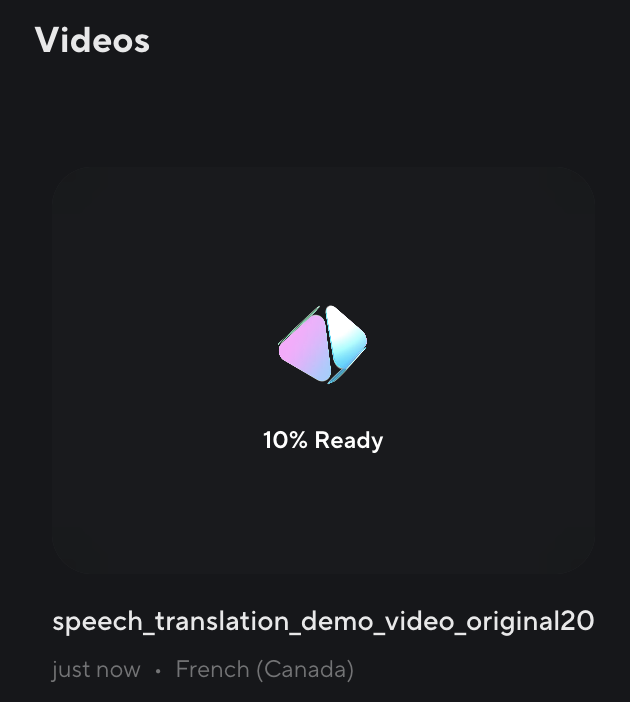
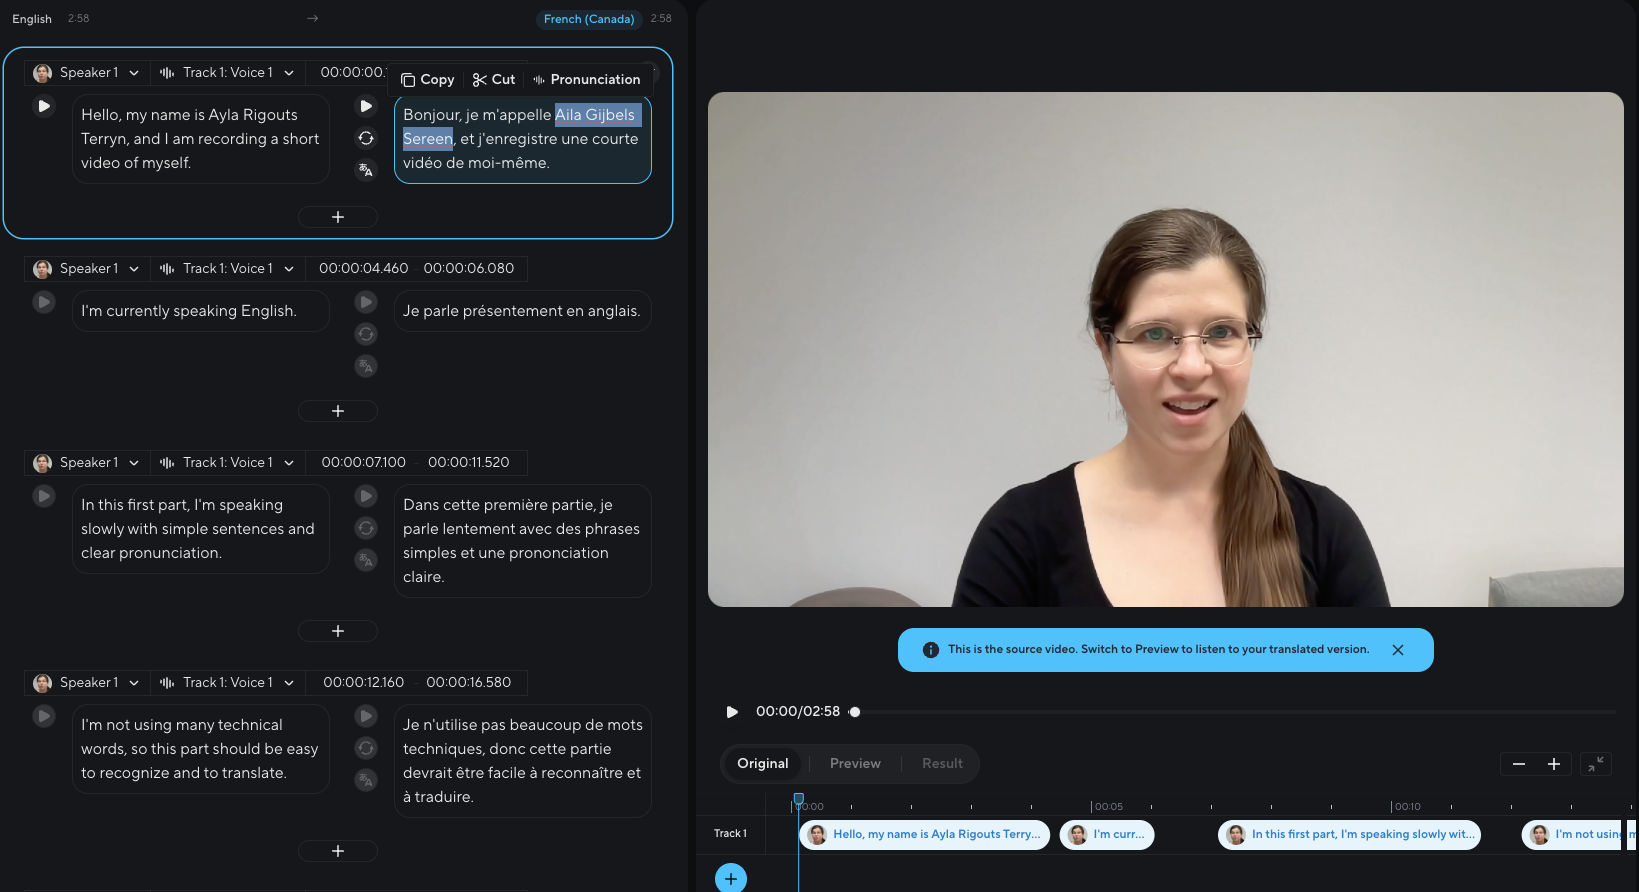
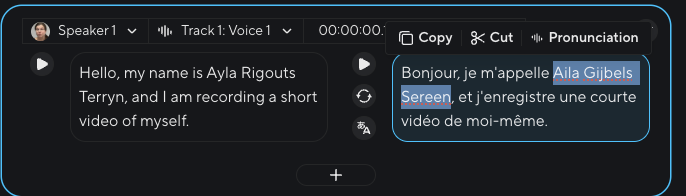
Figure 9. On heygen.com, “Get started for free” or “Sign in” open the service. Figure 10. Signing in goes through Google, Apple, an email address (“Use email”) or an institutional account. Email avoids linking your Google or Apple account. Figure 11. After signing in, the home screen is mostly about creating videos; translation sits in the menu on the left. Figure 12. In the Create menu, choose Translate. Figure 13. Drop the video in or paste a YouTube or Google Drive link. The free tier takes one minute of video at most, up to 5 GB, in MP4, MOV or WEBM. Figure 14. Give the language of the video, then the target language: Canadian French is offered, with a choice of a male or a female voice. Figure 15. The advanced settings: the brand glossary and the export at source resolution need a paid plan, while adjusting the length to the speech and keeping the original music are on by default and change the result. Figure 16. Processing is followed from the video list; it takes several minutes. Figure 17. On a paid plan, the editor shows the transcript and the translation segment by segment, with playback of each segment, correction of the target text and a pronunciation control. Figure 18. The first segment, enlarged: “Ayla Rigouts Terryn” has become “Aila Gijbels Sereen”.
HeyGen est une plateforme commerciale de traduction vidéo par IA : elle
transcrit la piste audio, la traduit, génère une voix clonée dans la langue
cible et resynchronise les lèvres. L’éditeur annonce la prise en charge de
plus de 175 langues ; un niveau gratuit existe, avec des crédits limités.
Durée estimée : 30 minutes.
Ce que vous ferez :
expérimenter la traduction parole à parole appliquée à la vidéo ;
évaluer la qualité du clonage vocal et de la synchronisation labiale ;
comprendre les compromis entre automatisation et qualité ;
réfléchir aux implications éthiques du clonage vocal.
Confidentialité des données : à lire avant de commencer
HeyGen est un service commercial dont les conditions d’utilisation des
données doivent être comprises avant usage. Selon sa politique de
confidentialité (mise à jour le 11 août 2026) :
HeyGen collecte les « entrées utilisateur » : vidéos, images, voix et
scripts téléversés ;
pour les comptes non-entreprise, dont les comptes gratuits, ces données
peuvent servir à entraîner et à améliorer les modèles du service ;
les comptes entreprise sont régis par des contrats distincts et exemptés ;
vous pouvez refuser cette utilisation (angl. opt-out) en écrivant à
privacy@heygen.com ;
HeyGen déclare ne pas vendre les données personnelles à des tiers ;
vous pouvez demander la suppression de vos données (traitement visé
sous 72 heures).
Concrètement, pour cet exercice : si vous utilisez un compte gratuit avec
votre propre vidéo, votre visage, votre voix et tout contenu visible ou
audible pourraient servir à l’entraînement des modèles. Le refus est
possible, mais il faut le demander activement ; après l’exercice, vous
pouvez demander la suppression de votre compte et de vos données.
À éviter absolument :
téléverser des vidéos de personnes identifiables sans leur consentement
éclairé explicite ;
inclure du travail de client ou des informations confidentielles ;
utiliser votre propre image si l’utilisation potentielle pour
l’entraînement vous met mal à l’aise.
Vérifiez votre courriel et connectez-vous au tableau de bord.
Le niveau gratuit offre un crédit limité : repérez les étapes ci-dessous
avant de lancer une traduction, pour ne pas gaspiller vos crédits. Si vous
rencontrez des problèmes techniques, documentez-les dans votre réflexion.
Le parcours dans l’interface
Captures d’écran du 2 septembre 2026 et du 3 septembre 2026 : l’interface de HeyGen
change souvent, alors attendez-vous à des écarts.
Figure 9. Sur heygen.com, « Get started for free » ou « Sign in » donnent accès au service. Figure 10. L'authentification passe par Google, Apple, une adresse courriel (« Use email ») ou un compte institutionnel. Le courriel évite de lier votre compte Google ou Apple. Figure 11. Après la connexion, l'accueil propose surtout de créer des vidéos ; la traduction se trouve dans le menu de gauche. Figure 12. Dans le menu Create, choisissez Translate. Figure 13. Déposez la vidéo ou collez un lien YouTube ou Google Drive. Le niveau gratuit accepte une minute de vidéo au maximum, jusqu'à 5 Go, en MP4, MOV ou WEBM. Figure 14. Indiquez la langue de la vidéo, puis la langue cible : le français canadien est proposé, avec le choix d'une voix masculine ou féminine. Figure 15. Les réglages avancés : le glossaire de marque et l'export à la résolution d'origine demandent un abonnement payant, tandis que l'ajustement de la durée à la parole et la conservation de la musique sont actifs par défaut et modifient le résultat. Figure 16. Le traitement se suit depuis la liste des vidéos ; il prend plusieurs minutes. Figure 17. Avec un abonnement payant, l'éditeur montre la transcription et la traduction segment par segment, avec la lecture de chaque segment, la correction du texte cible et un réglage de prononciation. Figure 18. Le premier segment, agrandi : « Ayla Rigouts Terryn » est devenu « Aila Gijbels Sereen ».
Assignment: translating a videoTravail : traduire une vidéo
The exercise
Option A: use the video provided (recommended if you have
confidentiality concerns). The short clip on StudiUM, under a minute, is the
one to translate: the two of us in conversation, in French, talking over
each other at one point. Translate it into English, or into another language
you know well enough to analyse and that HeyGen offers. The free tier takes
no more than a minute of video.
The three-minute version I showed in class, with its translation, is in
English and covers six sections of increasing difficulty:
slow, clear speech, simple sentences;
faster speech, simple vocabulary;
accent and code-switching (English and French);
proper nouns and specialized terminology;
movement and variable audio quality;
a summary, back to clear speech.
Option B: create your own video. Only if you are comfortable with the
confidentiality implications set out on the previous page. Specifications: 30 to 60
seconds, in French (for a translation into English or another language you
know well), a clear image and audible sound, facing the camera for the lip synchronization. The video
provided can serve as a model for content and structure.
Then follow the steps of the walkthrough to obtain the translated video, watch
it
attentively against the original, and copy the share link.
What to produce: the video and a reflection
The link to the translated video. Check that the link works: open it
in a private browsing window before submitting it.
A reflection (150 to 300 words) built from the following questions:
Voice quality: did the cloned voice sound natural? Were the
intonation and the rhythm right?
Lip synchronization: did the mouth movements match the speech? Any
lags, any sections better than others?
Two voices: did the tool tell them apart, and give each its own
cloned voice? What happened where they overlap?
Translation quality: any errors? Give precise examples. What about
the technical terms, the numbers, the overall meaning, the fluency of
the target language?
Factors tested: what effect did the accents, the proper nouns, the
numbers and the moment the two voices overlap have?
Practical applications: in which settings would this technology be
useful? Where would it fail? What human revision would be needed?
Ethical concerns: what makes you comfortable or uncomfortable?
What risks for language professionals? What safeguards would be
needed?
Troubleshooting
Video too long: the free tier takes one minute at most; shorten the
video.
Not enough credit: document the problem in your reflection.
Processing failed: check the file format (MP4, MOV or WEBM) and the
audio quality, then try again.
Link not working: check the sharing settings in HeyGen; the link has
to be public or accessible to anyone with the link.
L’exercice
Option A : utiliser la vidéo fournie (recommandé en cas de préoccupations
de confidentialité). Le court extrait déposé sur StudiUM, de moins d’une
minute, est celui à traduire : une conversation entre nous deux, en
français, avec un passage où nous nous coupons la parole. Traduisez-le vers
l’anglais, ou vers une autre langue que vous maîtrisez assez pour l’analyser
et que HeyGen propose. Le niveau gratuit n’accepte pas plus d’une minute de
vidéo.
La version de trois minutes que j’ai montrée en classe, avec sa traduction,
est en anglais et couvre six sections aux défis progressifs :
discours lent et clair, phrases simples ;
discours plus rapide, vocabulaire simple ;
accent et alternance de langues (anglais/français) ;
noms propres et terminologie spécialisée ;
mouvement et qualité audio variable ;
résumé, retour au discours clair.
Option B : créer votre propre vidéo. Uniquement si vous êtes à l’aise
avec les implications de confidentialité exposées à la page précédente.
Spécifications :
30 à 60 secondes, en français (pour une traduction vers l’anglais ou une
autre langue que vous maîtrisez), image claire et audio audible, face caméra pour la synchronisation labiale. La
vidéo fournie peut servir de modèle de contenu et de structure.
Suivez ensuite les étapes du parcours dans l’interface pour obtenir la vidéo
traduite,
regardez-la attentivement en la comparant à l’originale, et copiez le lien
de partage.
À produire : la vidéo et une réflexion
Le lien vers la vidéo traduite. Vérifiez que le lien est accessible :
ouvrez-le dans une fenêtre de navigation privée avant de le remettre.
Une réflexion (150 à 300 mots) à partir des questions suivantes :
Qualité vocale : la voix clonée sonnait-elle naturelle ?
L’intonation et le rythme étaient-ils appropriés ?
Synchronisation labiale : les mouvements de la bouche
correspondaient-ils au discours ? Des décalages, des sections
meilleures que d’autres ?
Deux voix : l’outil les a-t-il distinguées, et a-t-il donné à
chacune sa voix clonée ? Que s’est-il passé là où elles se
chevauchent ?
Qualité de la traduction : des erreurs ? Donnez des exemples
précis. Les termes techniques, les chiffres, le sens global, la fluidité
de la langue cible ?
Facteurs testés : quel effet ont eu les accents, les noms propres,
les chiffres et le moment où les deux voix se chevauchent ?
Applications pratiques : dans quels contextes cette technologie
serait-elle utile ? Où échouerait-elle ? Quelle révision humaine
faudrait-il ?
Préoccupations éthiques : qu’est-ce qui vous met à l’aise ou mal à
l’aise ? Quels risques pour les professionnels de la langue ? Quelles
mesures de protection seraient nécessaires ?
Dépannage
Vidéo trop longue : le niveau gratuit n’accepte qu’une minute ;
raccourcissez la vidéo.
Crédit insuffisant : documentez le problème dans votre réflexion.
Traitement échoué : vérifiez le format du fichier (MP4, MOV ou WEBM) et
la qualité audio, puis réessayez.
Lien inaccessible : vérifiez les paramètres de partage dans HeyGen ;
le lien doit être public ou accessible avec le lien.
Files, tools and markupFichiers, outils et balisage
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Files from a clientLes fichiers d'un client
An industrial pump manufacturer, our fictional client Cascade Pumps Inc., sends you their
installation guide to translate into French. The message has four attachments:
guide-installation.xliff, the content to translate, pulled from the
client’s website;
If you were to open the four in a text editor, you would see text with a lot of
angle brackets in it. Depending on the editor, the markup may come out coloured
the way it is below, or it may not. You are not being asked to open anything
here: the four excerpts below are simplified pieces of those files, and they
are what the rest of the module teaches you to read.
guide-installation.xliff has the content to translate, split into units.
One unit:
<unit id="u12"> <segment> <source>Install the centrifugal pump on a level surface.</source> </segment></unit>
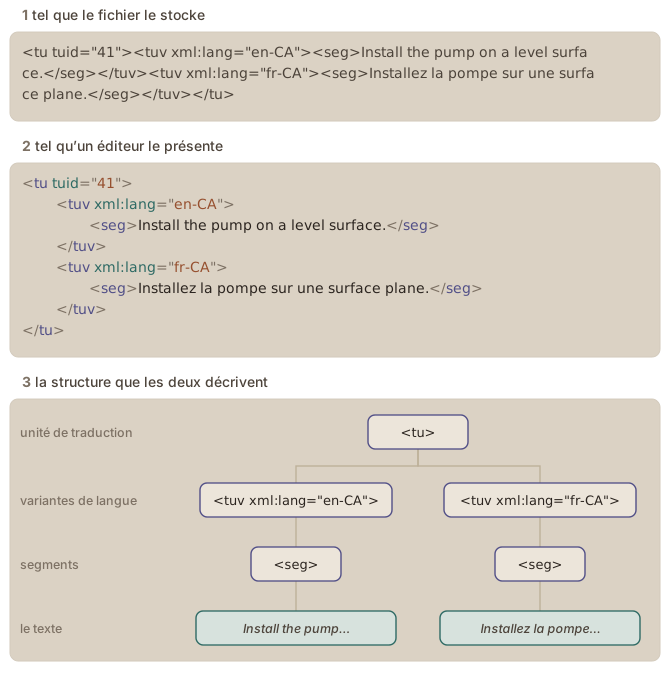
cascade-pumps_en-fr.tmx is the translation memory, filled with earlier
translations. One of them:
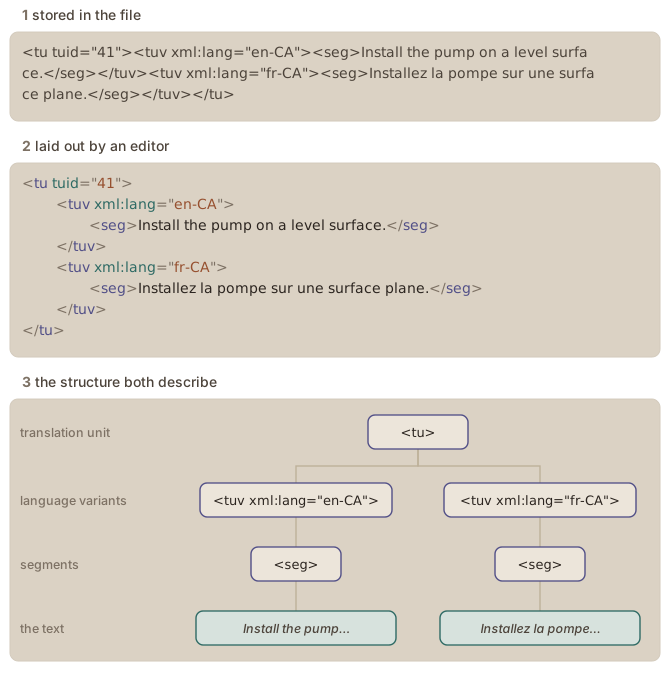
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
cascade-pumps.tbx is the termbase, with one entry per concept. One entry:
Reading files like these is what this chapter and this module build up to: what
the markup is doing, what each of the three standard formats is for, and what
you may change in them without breaking the file.
Un fabricant de pompes industrielles, notre client fictif Cascade Pumps Inc., vous confie la
traduction de son guide d’installation vers le français. Le courriel contient quatre
pièces jointes :
guide-installation.xliff, le contenu à traduire, extrait du site web du
client ;
Si vous ouvriez les quatre dans un éditeur de texte, vous verriez du texte
parsemé de chevrons. Selon l’éditeur, le balisage serait coloré comme ci-dessous,
ou non. Vous n’avez rien à ouvrir ici : les quatre extraits ci-dessous
sont des morceaux simplifiés de ces fichiers, et c’est à les lire que le reste
du module vous mène.
guide-installation.xliff contient le contenu à traduire, découpé en unités.
Une unité :
<unit id="u12"> <segment> <source>Install the centrifugal pump on a level surface.</source> </segment></unit>
cascade-pumps_en-fr.tmx est la mémoire de traduction, remplie de traductions
antérieures. L’une d’elles :
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
cascade-pumps.tbx est la base terminologique, à raison d’une entrée par
concept. Une entrée :
Lire des fichiers comme ceux-là, c’est ce vers quoi mènent ce chapitre et ce
module : ce que fait le balisage, ce que transporte chacun des trois formats
normalisés, et ce que vous pouvez y modifier sans casser le fichier.
Why interchange formats?Pourquoi des formats d'échange ?
Internal storage belongs to the tool and is optimized for it. A classic
local memory in memoQ, for instance, is a folder of files identified by an
.mtm file; Trados Studio keeps its own in an .sdltm file. These formats are
not meant to be read by other programs, and nothing obliges their vendor to
document them or to keep them stable from one version to the next.
A backup copies that internal storage. It protects you against a failure,
not against a change of tool.
An interchange export produces a file meant to leave the tool: TMX, TBX,
XLIFF. It is the only one of the three that crosses the boundary between
programs.A tool does sometimes read a competitor’s format directly:
memoQ imports Trados .sdltm files. That stays the exception, and it depends
on the vendor’s goodwill.
Without those exports, exchange would not be impossible, but it would happen
ad hoc, with a lot of copy-pasting and as much room for error or data loss. The
more complex the data, the more problematic such conversions become.
Imagine a very simple bilingual glossary in Excel, where each source term is
linked to exactly one target term: two terms per row. Easy enough. But we all
know that a glossary rarely stays that simple: you start adding synonyms,
cross-references, related terms, definitions, sources, example sentences. The
moment the data is more complex than a plain, consistent table with no links in
it, you can assume that sharing it becomes more difficult as well.
Producing the file is only half of the problem. The tool that receives it also
has to make sense of what is inside, and exchanging data that the other side can
actually use is what these formats are for. That property has a name.
A tool can claim support for TMX or XLIFF without reading them exactly the way
yours does, so what interoperability delivers in practice is a separate
question from what the standards define.
Le stockage interne appartient à l’outil et est optimisé pour lui. Une
mémoire locale classique de memoQ, par exemple, est un dossier de fichiers
repéré par un fichier .mtm ; Trados Studio range la sienne dans un fichier
.sdltm. Ces formats ne sont pas faits pour être lus par d’autres logiciels,
et rien n’oblige leur éditeur à les documenter ni à les garder stables d’une
version à l’autre.
La sauvegarde copie ce stockage interne. Elle vous protège d’une panne, pas
d’un changement d’outil.
L’export d’échange produit un fichier destiné à sortir de l’outil : TMX,
TBX, XLIFF. C’est le seul des trois qui traverse la frontière entre
logiciels.Il arrive qu’un outil lise directement le format d’un
concurrent : memoQ importe les fichiers .sdltm de Trados. Cela reste
l’exception, et cela dépend du bon vouloir de l’éditeur.
Sans ces exports, l’échange ne serait pas impossible, mais il se ferait au cas
par cas, avec beaucoup de copier-coller et autant d’occasions de se tromper ou
de perdre des données. Plus les données sont complexes, plus ces conversions
improvisées posent problème.
Imaginez un glossaire bilingue très simple dans Excel, où chaque terme source
correspond à exactement un terme cible : deux termes par ligne. Jusque-là, rien
de compliqué. Mais nous savons tous qu’un glossaire reste rarement aussi
simple : on y ajoute des synonymes, des renvois, des termes apparentés, des
définitions, des sources, des exemples d’emploi. Dès que les données dépassent
le tableau simple et régulier, sans liens internes, on peut supposer que leur
partage devient lui aussi plus difficile.
Produire le fichier ne règle que la moitié du problème. L’outil qui le reçoit
doit encore comprendre ce qu’il contient, et échanger des données que l’autre
côté peut réellement exploiter, c’est ce à quoi servent ces formats. Cette
propriété porte un nom.
Un outil peut annoncer qu’il prend en charge TMX ou XLIFF sans les lire
exactement comme le vôtre : ce que l’interopérabilité donne en pratique est
donc une autre question que ce que les normes définissent.
The sentence from our fictional client, Cascade Pumps Inc., as it travels in their XLIFF file:
<segment> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target></segment>
HTML
HTML is the other markup language you are certain to come across. Web pages are written
in it, so any web content that is not a PDF or an image reaches you as HTML. Unlike an XML format, it comes with its tag names already
fixed by its standard.
Here is the same sentence as it exists on the client’s website:
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p><img src="pump-diagram.png" alt="Cutaway view of a centrifugal pump">
Three things to notice:
<p> marks a paragraph and <strong> an emphasis. Those names come from the
HTML standard; you do not choose them.
The text to translate is the text between the tags.
Some of it is inside a tag: alt gives the description of the image,
read by people who cannot see it. src, which names the image file, is not
translated.
La phrase de notre client fictif, Cascade Pumps Inc., telle qu’elle voyage dans
son fichier XLIFF :
<segment> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target></segment>
HTML
HTML est l’autre langage de balisage que vous rencontrerez à coup sûr. Les pages
web sont écrites en HTML ; tout contenu web qui n’est ni un PDF ni une image vous
arrive donc sous cette forme. Contrairement à un
format XML, ses noms de balises sont déjà fixés par sa norme.
Voici la même phrase telle qu’elle existe sur le site web du client :
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p><img src="pump-diagram.png" alt="Cutaway view of a centrifugal pump">
Trois choses à remarquer :
<p> marque un paragraphe et <strong> une mise en relief. Ces noms
viennent de la norme HTML ; vous ne les choisissez pas.
Le texte à traduire est celui qui se trouve entre les balises.
Du texte à traduire se trouve aussi dans une balise : alt porte la
description de l’image, lue par les personnes qui ne la voient pas. src,
qui nomme le fichier image, ne se traduit pas.
Plain text and its linesLe texte brut et ses lignes
Any editor opens it
You can open a TMX, XLIFF or HTML file in Notepad (Windows) or TextEdit (Mac)
and see how it is put together. No specialized software is needed, because
there is nothing in the file to decode: characters, one after another.
A line break is a character
Among those characters is the one that ends a line. You never see it, but it is
in the file like any other, and it is what divides the file into lines. A file
with two of them has three lines, whatever it looks like on screen.
Word processors give you a way to see them: the button usually marked ¶, which
displays the invisible characters on screen, paragraph marks and line breaks
along with spaces and tabs. It changes nothing in the file. It only stops hiding
what is already in it.
Word wrap writes nothing
When a line is too long for the window, an editor breaks it so you can read it
without scrolling sideways. That break is drawn, not written: the same file
wraps differently in a narrower window, in another editor, or at a larger font
size, and none of that changes the file.
Figure 1. A narrow window and a wide one, showing the same file. The rows move, the line breaks do not.
The two get confused because both look like a new line. The difference shows the
moment you count something:
Line numbers. An editor numbers the lines in the file, not the rows on
screen, so line 2 can occupy four rows.
One record per line. A CSV or TSV file normally puts one record on each
line. A record that wraps on screen is still one record, and a stray line
break inside one splits it in two, unless the field it falls in is quoted.
XML. A file that arrives on one very long line is intact, which is why
what an XML file looks like says the
indentation is a convention rather than a requirement.
N’importe quel éditeur l’ouvre
Vous pouvez ouvrir un fichier TMX, XLIFF ou HTML dans le Bloc-notes (Windows) ou
TextEdit (Mac) et voir comment il est construit. Aucun logiciel spécialisé n’est
nécessaire, parce qu’il n’y a rien à décoder dans le fichier : des caractères,
les uns après les autres.
Le saut de ligne est un caractère
Parmi ces caractères, il y en a un qui termine la ligne. Vous ne le voyez jamais,
mais il est dans le fichier comme les autres, et c’est lui qui découpe le fichier
en lignes. Un fichier qui en compte deux a trois lignes, quelle que soit son
allure à l’écran.
Les traitements de texte offrent un moyen de les voir : le bouton marqué 
d’ordinaire, qui affiche à l’écran les caractères invisibles, marques de
paragraphe et sauts de ligne, mais aussi espaces et tabulations. Il ne change
rien au fichier. Il cesse seulement de cacher ce qui s’y trouve déjà.
Le retour à la ligne automatique n’écrit rien
Quand une ligne est trop longue pour la fenêtre, l’éditeur la coupe pour vous
éviter de défiler latéralement. Cette coupure est dessinée, pas écrite : le même
fichier se replie autrement dans une fenêtre plus étroite, dans un autre éditeur
ou avec une police plus grande, et rien de tout cela ne change le fichier.
Figure 1. Une fenêtre étroite et une fenêtre large, pour le même fichier. Les rangées bougent, les sauts de ligne restent.
On confond les deux parce que l’une comme l’autre ressemble à une nouvelle ligne.
La différence apparaît dès qu’il faut compter :
Les numéros de ligne. L’éditeur numérote les lignes du fichier, pas les
rangées à l’écran : la ligne 2 peut donc occuper quatre rangées.
Un enregistrement par ligne. Un fichier CSV ou TSV place normalement un
enregistrement par ligne. Un enregistrement qui se replie à l’écran reste un
seul enregistrement, et un saut de ligne égaré à l’intérieur le coupe en deux,
sauf si le champ où il tombe est entre guillemets.
XML. Un fichier qui arrive sur une seule très longue ligne est intact,
et c’est pourquoi à quoi ressemble le XML
présente l’indentation comme une convention et non comme une obligation.
Reading XMLLire du XML
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
What XML looks likeÀ quoi ressemble le XML
Figure 1. One document, three views: what is in the file, how an editor shows it, and the structure behind both.
That structure is made of elements and tags, of the attributes attached to
them, and of the hierarchy they build.Every
example in this chapter is an excerpt. A complete XML file opens with a
declaration, <?xml version="1.0" encoding="UTF-8"?>, taken up on the encoding
page.
Cette structure est faite d’éléments et de balises, des attributs qu’ils
portent, et de la hiérarchie qu’ils construisent.Tous les exemples de ce chapitre sont des extraits. Un
fichier XML complet s’ouvre par une déclaration, <?xml version="1.0" encoding="UTF-8"?>, reprise à la page sur le codage.
Elements nest inside one another and form a tree: each element can contain
other elements, its children.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
Les éléments s’imbriquent les uns dans les autres et forment un arbre : chaque
élément peut contenir d’autres éléments, ses enfants.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
Reserved characters and namespacesCaractères réservés et espaces de noms
Strange characters, files that will not open
Two points of syntax turn up in every interchange file. Recognizing them saves
you a headache later, over strange characters in the text or a file that no
longer opens the way it should.
Reserved characters
Angle brackets delimit tags: a < in text would be read as the start of a tag.
XML therefore gives it a replacement spelling, and gives the ampersand one too,
since every replacement begins with an ampersand:
In the text
Written in the file
<
<
&
&
>, " and ' have replacement spellings too (>, ", '),
required only in certain contexts; tools often write them anyway.
In practice: a company called Smith & Sons appears in the file as
Smith & Sons, and the translation is written the same way. Do not replace
& with & by hand, you would break the file.
xmlns announces that <unit>, <segment> and the other tags that follow are
XLIFF’s, and not those of some other format using the same names. A document
can declare several namespaces, each marked by a prefix of the form
prefix:tag. This is how a tool adds tags of its own to a standard format
without colliding with it, and it is also a source of trouble in exchange: a
tool that does not know that vocabulary will get nothing out of those tags.
One namespace is declared in advance by the XML standard itself, the one for
the xml prefix. That is why xml:lang appears everywhere with no matching
declaration in the file.
Deux détails de syntaxe reviennent dans tous les fichiers d’échange. Les
reconnaître vous évitera bien des ennuis devant des caractères étranges ou un
fichier qui ne s’ouvre plus comme il devrait.
Caractères réservés
Les chevrons délimitent les balises : un < dans du texte serait lu comme le
début d’une balise. XML lui prévoit donc une écriture de remplacement, et à
l’esperluette aussi, puisque chaque remplacement commence par une esperluette :
Dans le texte
S’écrit dans le fichier
<
<
&
&
>, " et ' ont eux aussi une écriture de remplacement (>, ",
'), obligatoire seulement dans certains contextes ; les outils les
écrivent souvent par prudence.
En pratique : une entreprise nommée Smith & Sons apparaît dans le fichier sous
la forme Smith & Sons, et la traduction s’écrit de la même façon. Ne
remplacez pas & par & à la main, vous casseriez le fichier.
xmlns annonce que <unit>, <segment> et les autres balises qui suivent
sont celles de XLIFF, et non celles d’un autre format qui emploierait les mêmes
noms. Un document peut déclarer plusieurs espaces de noms, chacun repéré par un
préfixe de la forme prefixe:balise. C’est ainsi qu’un outil ajoute ses
propres balises à un format normalisé sans entrer en conflit avec lui, et c’est
aussi une source de difficultés à l’échange : un outil qui ne connaît pas ce
vocabulaire ne tirera rien de ces balises.
Un espace de noms est déclaré d’avance par la norme XML elle-même, celui du
préfixe xml. C’est pourquoi xml:lang apparaît partout sans déclaration
correspondante dans le fichier.
Plain text and its lines said a
file is characters and nothing else. That is true of what the file means; what
it stores is bytes, and an encoding is the agreement that turns one back into
the other. If the agreement is wrong, the letters come
back wrong, which is why this is the problem French text hits first.
The declaration says which one
The very first line of an XML file is its declaration:
<?xml version="1.0" encoding="UTF-8"?>
encoding names the agreement the file was written under. UTF-8 covers accents,
non-Latin alphabets and almost everything else, and it is what TMX, TBX and
XLIFF use.Some programs, Windows ones above all, start a UTF-8 file
with three invisible bytes announcing the encoding, called a byte order mark or
BOM. Most tools take it in their stride, but one that does not will show it as
 in front of the first character, or trip over a first line that looks
perfectly normal on screen. If a file misbehaves only on its first line, this is
usually why, and a text editor that offers to save “UTF-8 without BOM” is
offering the fix.
When it goes wrong
An accented letter is where the trouble shows, because in UTF-8 it takes two
bytes rather than one. Written as UTF-8 and read as if it were an older
one-byte encoding, “é” arrives as two letters instead:
A whole file of that is the classic symptom: every accent has turned into two
characters, and nothing else has moved. It means the file was written under one
agreement and read under another, not that the text was damaged, so opening it
again with the right encoding usually brings it back.The other
direction is uglier. In a one-byte file opened as UTF-8, the accented bytes make
no valid character at all, so they come back as �. Save the file in that state
and the original letter is gone for good.
Le texte brut et ses lignes
disait qu’un fichier est fait de caractères et de rien d’autre. C’est vrai de ce
que le fichier signifie ; ce qu’il stocke, ce sont des
octets, et le codage est la convention qui fait passer des uns aux autres.
Si la convention est fausse, les lettres reviennent fausses, et c’est pourquoi
le texte français rencontre ce problème avant tout autre.
La déclaration dit laquelle
La toute première ligne d’un fichier XML est sa déclaration :
<?xml version="1.0" encoding="UTF-8"?>
encoding nomme la convention selon laquelle le fichier a été écrit. UTF-8
couvre les accents, les alphabets non latins et à peu près tout le reste, et
c’est ce qu’emploient TMX, TBX et XLIFF.Certains logiciels, ceux de
Windows au premier chef, font commencer un fichier UTF-8 par trois octets
invisibles qui annoncent le codage, ce qu’on appelle une marque d’ordre des
octets, ou BOM (byte order mark). La plupart des outils s’en accommodent, mais
celui qui ne le fait pas l’affiche sous la forme  devant le premier
caractère, ou bute sur une première ligne qui semble pourtant normale à l’écran.
Quand un fichier ne pose problème que sur sa première ligne, c’est en général
cela, et un éditeur de texte qui propose d’enregistrer en « UTF-8 sans BOM »
propose la solution.
Quand cela tourne mal
C’est sur les lettres accentuées que l’ennui se voit, parce qu’en UTF-8 elles
occupent deux octets au lieu d’un. Écrit en UTF-8 puis relu comme s’il
s’agissait d’un ancien codage à un octet, le « é » arrive sous la forme de deux
lettres :
Un fichier entier dans cet état, c’est le symptôme classique : chaque accent
s’est transformé en deux caractères, et rien d’autre n’a bougé. Cela veut dire
que le fichier a été écrit selon une convention et relu selon une autre, non
que le texte a été abîmé : le rouvrir avec le bon codage le rétablit
généralement.L’autre sens est plus vilain. Dans un fichier à un octet relu
en UTF-8, les octets accentués ne forment aucun caractère valide : ils
reviennent sous la forme de �. Enregistrez le fichier dans cet état et la
lettre d’origine est perdue pour de bon.
What to translate, what to leaveCe qui se traduit, ce qui ne se touche pas
The same sentence in two languages
Back to the sentence from the guide of our fictional client, Cascade Pumps Inc.:
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
In French:
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
The text changed, the structure did not. The tags are the same and there are as
many of them, and <strong> followed the term it emphasizes, which no longer
comes at the same place in the sentence.
Reprenons la phrase du guide de notre client fictif, Cascade Pumps Inc. :
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
En français :
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
Le texte a changé, la structure non. Les balises sont les mêmes et en même
nombre, et <strong> a suivi le terme qu’il met en relief, lequel n’occupe
plus la même place dans la phrase.
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
TMX: exchanging translation memoriesTMX : échanger des mémoires de traduction
What a TMX file contains
Main characteristics:
multilingual: one file can cover any number of languages;
very widely supported: practically every CAT tool imports and exports TMX;
simple in structure: a header and a body, with the translation
units.
Here is one of the units our fictional client, Cascade Pumps Inc., sends you. Simplified excerpt:
<tu tuid="41" creationdate="20240915T093000Z"> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
<tu> (translation unit) is the translation unit; <tuv> (translation unit
variant), its variant in a given language; <seg>, the segment itself. Adding
a third language means adding a <tuv> to the same <tu>.
multilingue : un même fichier peut contenir un nombre illimité de langues ;
très largement pris en charge : pratiquement tous les outils de TAO
importent et exportent du TMX ;
structure simple : un en-tête et un corps, le corps contenant les unités
de traduction.
Voici l’une des unités que notre client fictif, Cascade Pumps Inc., vous envoie. Extrait simplifié :
<tu tuid="41" creationdate="20240915T093000Z"> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
<tu> (translation unit) est l’unité de traduction ; <tuv> (translation
unit variant), sa variante dans une langue donnée ; <seg>, le segment
lui-même. Ajouter une troisième langue, c’est ajouter un <tuv> au même
<tu>.
TBX: exchanging termbasesTBX : échanger des bases terminologiques
What a TBX file contains
The substantive difference from a bilingual term list: TBX is organized by
concept, not by pair of terms. An entry describes a notion; under that entry,
one section per language; under each language, one or more terms, each with its
own labels (part of speech, gender, usage status).
Simplified excerpt from the termbase of our fictional client, Cascade Pumps Inc.:
<conceptEntry id="c41"> <langSec xml:lang="en"> <termSec> <term>centrifugal pump</term> <termNote type="partOfSpeech">noun</termNote> </termSec> </langSec> <langSec xml:lang="fr"> <descrip type="definition">Pompe qui déplace un fluide au moyen d'une roue en rotation.</descrip> <termSec> <term>pompe centrifuge</term> <termNote type="partOfSpeech">noun</termNote> <termNote type="grammaticalGender">feminine</termNote> </termSec> </langSec></conceptEntry>
TBX 3 is built as a small core plus modules of data categories, and a dialect is
a fixed combination of them, which is what settles the categories a file may
use. TBX-Min is the deliberately minimal one, a handful of categories beyond the
terms themselves; TBX-Basic is the one a translation project usually wants,
with definitions, part of speech, usage status and context. A file names its
dialect at the top, so it is the first thing to check when a termbase will not
go in.
A tool can therefore advertise “TBX” and read only one dialect, which is where
the trouble starts: what it does not recognize it usually leaves behind, so a
termbase can arrive with every term intact and its definitions and usage notes
gone. That is one of the reasons its adoption remains uneven.
Sources
ISO (2019). ISO 30042:2019. Management of terminology resources — TermBase eXchange (TBX). International Organization for Standardization. https://www.iso.org/standard/62510.html
La différence de fond avec une liste bilingue de termes : TBX s’organise par
concept et non par paire de termes. Une entrée décrit une notion ; sous cette
entrée, une section par langue ; sous chaque langue, un ou plusieurs termes,
chacun avec ses marques (partie du discours, genre, statut d’usage).
Extrait simplifié de la base terminologique de notre client fictif, Cascade Pumps Inc. :
<conceptEntry id="c41"> <langSec xml:lang="en"> <termSec> <term>centrifugal pump</term> <termNote type="partOfSpeech">noun</termNote> </termSec> </langSec> <langSec xml:lang="fr"> <descrip type="definition">Pompe qui déplace un fluide au moyen d'une roue en rotation.</descrip> <termSec> <term>pompe centrifuge</term> <termNote type="partOfSpeech">noun</termNote> <termNote type="grammaticalGender">feminine</termNote> </termSec> </langSec></conceptEntry>
TBX 3 se compose d’un noyau réduit et de modules de catégories de données, et un
dialecte est une combinaison fixée de ces modules, ce qui détermine les
catégories qu’un fichier peut employer. TBX-Min est le dialecte délibérément
minimal, quelques catégories à peine au-delà des termes eux-mêmes ; TBX-Basic est
celui qu’un projet de traduction demande d’ordinaire, avec les définitions, la
partie du discours, le statut d’usage et le contexte. Un fichier annonce son
dialecte en tête, et c’est donc la première chose à vérifier quand une base
terminologique refuse d’entrer.
Un outil peut donc annoncer « TBX » et n’en lire qu’un dialecte, et c’est là que
les ennuis commencent : ce qu’il ne reconnaît pas, il le laisse le plus souvent
de côté, si bien qu’une base peut arriver avec tous ses termes et sans ses
définitions ni ses marques d’usage. C’est l’une des raisons pour lesquelles son
adoption reste inégale.
Sources
ISO (2019). ISO 30042:2019. Management of terminology resources — TermBase eXchange (TBX). International Organization for Standardization. https://www.iso.org/standard/62510.html
XLIFF: exchanging content to translateXLIFF : échanger du contenu à traduire
What an XLIFF file contains
XLIFF does not exchange linguistic resources (memories, terms) but content
being translated. It is the format of guide-installation.xliff, the first attachment from our
fictional client, Cascade Pumps Inc.: the content of their website, extracted
for translation and meant to go back.
Main characteristics:
bilingual: one language pair per file, unlike TMX;
workflow-oriented: each segment records its status;
built for the round trip: it takes along what is needed to rebuild the
original document.
Simplified excerpt:
<unit id="u12"> <segment state="translated"> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target> </segment></unit>
The short version: a TMX is what you have translated before, an XLIFF is what
you are translating now. The two come together at the end of a job, when the finished
segments of an XLIFF go into a memory that a later project exports as TMX. It
does not work the other way: a memory is not a document, so there is nothing to
rebuild.
ISO (2024). ISO 21720:2024. XLIFF (XML Localization Interchange File Format) — Version 2.1. International Organization for Standardization. https://www.iso.org/standard/87344.html
XLIFF n’échange pas des ressources linguistiques (mémoires, termes) mais du
contenu en cours de traduction. C’est le format de guide-installation.xliff,
la première pièce jointe de notre client fictif, Cascade Pumps Inc. : le contenu de son site web, extrait
pour la traduction et destiné à y retourner.
Caractéristiques principales :
bilingue : une paire de langues par fichier, contrairement à TMX ;
orienté flux de travail : chaque segment porte son état d’avancement ;
fait pour l’aller-retour : il emporte de quoi reconstruire le document de
départ.
Extrait simplifié :
<unit id="u12"> <segment state="translated"> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target> </segment></unit>
En bref : le TMX, c’est ce que vous avez déjà traduit ; le XLIFF, ce que vous
traduisez maintenant. Les deux se rejoignent en fin de projet, quand les
segments terminés d’un XLIFF entrent dans une mémoire qu’un projet ultérieur
exportera en TMX. L’inverse ne marche pas : une mémoire n’est pas un document, il n’y
a donc rien à reconstruire.
ISO (2024). ISO 21720:2024. XLIFF (XML Localization Interchange File Format) — Version 2.1. International Organization for Standardization. https://www.iso.org/standard/87344.html
ISO (2019). ISO 30042:2019. Management of terminology resources — TermBase eXchange (TBX). International Organization for Standardization. https://www.iso.org/standard/62510.html
ISO (2024). ISO 21720:2024. XLIFF (XML Localization Interchange File Format) — Version 2.1. International Organization for Standardization. https://www.iso.org/standard/87344.html
Interoperability in practice & AIL'interopérabilité en pratique et l'IA
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Interoperability in practiceL'interopérabilité en pratique
The tools know this and ask you about it. When importing a TMX file, memoQ
offers different settings depending on where the file comes from: from memoQ,
from Trados Translator’s Workbench 2007 or earlier, from somewhere else. In the
last two cases you have to tell it to convert <ut> and custom tags into memoQ
tags, and its documentation ties that setting to the quality of the matches you
get. An import done without those settings lets the segments through but
degrades what the memory will give back to you.
Andrä, S. C., & Schütz, J. (2011). The semantically-enriched translation interoperability protocol. Proceedings of the Workshop on Language Resources, Technology and Services in the Sharing Paradigm (IJCNLP 2011), 25–30. https://aclanthology.org/W11-3304.pdf
Hu, H., Vamvas, J., & Sennrich, R. (2025). Source-primed multi-turn conversation helps large language models translate documents. Findings of the Association for Computational Linguistics: EMNLP 2025, 23702–23712. https://aclanthology.org/2025.findings-emnlp.1289/
Iranzo-Sánchez, J., Iranzo-Sánchez, J., Giménez, A., Civera, J., & Juan, A. (2024). Segmentation-free streaming machine translation. Transactions of the Association for Computational Linguistics, 12, 1104–1121. https://aclanthology.org/2024.tacl-1.61/
Karpinska, M., & Iyyer, M. (2023). Large language models effectively leverage document-level context for literary translation, but critical errors persist. Proceedings of the Eighth Conference on Machine Translation (WMT 2023). https://aclanthology.org/2023.wmt-1.41/
Läubli, S., Sennrich, R., & Volk, M. (2018). Has machine translation achieved human parity? A case for document-level evaluation. Proceedings of EMNLP 2018, 4791–4796. https://aclanthology.org/D18-1512/
Maruf, S., Saleh, F., & Haffari, G. (2021). A survey on document-level neural machine translation: Methods and evaluation. ACM Computing Surveys, 54(2), article 45. https://doi.org/10.1145/3441691
Peng, Z., Bawden, R., & Yvon, F. (2025). Investigating length issues in document-level machine translation. Proceedings of Machine Translation Summit XX: Volume 1. https://aclanthology.org/2025.mtsummit-1.3/
Ramos, M. M., Fernandes, P., Agrawal, S., & Martins, A. F. T. (2025). Multilingual contextualization of large language models for document-level machine translation. Second Conference on Language Modeling (COLM 2025). https://openreview.net/forum?id=Ah0U1r5Ldq
Voita, E., Sennrich, R., & Titov, I. (2019). When a good translation is wrong in context: Context-aware machine translation improves on deixis, ellipsis, and lexical cohesion. Proceedings of the 57th Annual Meeting of the ACL, 1198–1212. https://aclanthology.org/P19-1116/
Les outils le savent et vous le demandent. À l’import d’un fichier TMX, memoQ
propose des réglages différents selon la provenance du fichier : venu de memoQ,
venu de Trados Translator’s Workbench 2007 ou antérieur, venu d’ailleurs. Dans
les deux derniers cas, il faut lui dire de convertir les <ut> et les balises
maison en balises memoQ, et sa documentation lie ce réglage à la qualité des
correspondances obtenues. Un import fait sans ces réglages laisse passer les
segments, mais dégrade ce que la mémoire vous rendra.
Andrä, S. C., & Schütz, J. (2011). The semantically-enriched translation interoperability protocol. Proceedings of the Workshop on Language Resources, Technology and Services in the Sharing Paradigm (IJCNLP 2011), 25–30. https://aclanthology.org/W11-3304.pdf
Hu, H., Vamvas, J., & Sennrich, R. (2025). Source-primed multi-turn conversation helps large language models translate documents. Findings of the Association for Computational Linguistics: EMNLP 2025, 23702–23712. https://aclanthology.org/2025.findings-emnlp.1289/
Iranzo-Sánchez, J., Iranzo-Sánchez, J., Giménez, A., Civera, J., & Juan, A. (2024). Segmentation-free streaming machine translation. Transactions of the Association for Computational Linguistics, 12, 1104–1121. https://aclanthology.org/2024.tacl-1.61/
Karpinska, M., & Iyyer, M. (2023). Large language models effectively leverage document-level context for literary translation, but critical errors persist. Proceedings of the Eighth Conference on Machine Translation (WMT 2023). https://aclanthology.org/2023.wmt-1.41/
Läubli, S., Sennrich, R., & Volk, M. (2018). Has machine translation achieved human parity? A case for document-level evaluation. Proceedings of EMNLP 2018, 4791–4796. https://aclanthology.org/D18-1512/
Maruf, S., Saleh, F., & Haffari, G. (2021). A survey on document-level neural machine translation: Methods and evaluation. ACM Computing Surveys, 54(2), article 45. https://doi.org/10.1145/3441691
Peng, Z., Bawden, R., & Yvon, F. (2025). Investigating length issues in document-level machine translation. Proceedings of Machine Translation Summit XX: Volume 1. https://aclanthology.org/2025.mtsummit-1.3/
Ramos, M. M., Fernandes, P., Agrawal, S., & Martins, A. F. T. (2025). Multilingual contextualization of large language models for document-level machine translation. Second Conference on Language Modeling (COLM 2025). https://openreview.net/forum?id=Ah0U1r5Ldq
Voita, E., Sennrich, R., & Titov, I. (2019). When a good translation is wrong in context: Context-aware machine translation improves on deixis, ellipsis, and lexical cohesion. Proceedings of the 57th Annual Meeting of the ACL, 1198–1212. https://aclanthology.org/P19-1116/
Exchange formats in the AI eraLes formats d'échange à l'ère de l'IA
Terminology. A TBX glossary can be used to supply information about terms
to be added to prompts for LLMs. A model given them tends to use them more
often, without their being imposed on it: a prompt steers, it does not
constrain.
The value of your linguistic resources does not disappear with LLMs. A clean
memory and up-to-date terminology remain what separates a generic translation
from one that sounds like the client’s.
De la terminologie. Un glossaire TBX peut servir à fournir de l’information
sur les termes à ajouter aux requêtes adressées aux GML. Un modèle à qui on les
donne tend à les employer plus souvent, sans qu’on puisse les lui imposer : une
requête oriente, elle ne contraint pas.
La valeur de vos ressources linguistiques ne disparaît pas avec les GML. Une
mémoire propre et une terminologie à jour restent ce qui distingue une
traduction générique d’une traduction qui ressemble à celle du client.
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Two senses of the wordLes deux sens du mot
The corpus as a research instrument
Corpus linguistics uses the word in a demanding sense. Sinclair’s definition
is “a collection of pieces of language text in electronic form, selected
according to external criteria to represent, as far as possible, a language
or language variety as a source of data for linguistic research” (Sinclair,
2004). External criteria means the texts are picked for what they are and
where they come from, not for what they happen to say, so that the sample
cannot be built to confirm what its builder expects to find in it.
A corpus in that sense is a sample of something, so it can be judged against
that something. Biber describes it as “a sample, designed to
represent a textual domain in a language”, and gives as examples everyday
conversation in English, newspaper editorials, personal email messages and
the novels of Charles Dickens (Biber, 2011). There is no fixed recipe, then,
for what a corpus should contain: the composition follows the question the
corpus has to answer, and a corpus of one author is as legitimate as a
corpus of a whole language, provided the target is stated.
Corpora are read in more places than linguistics, and not always in order to
describe the language system: corpus stylistics uses the same methods to ask
about one author rather than about English (Biber, 2011).
Two examples with very different profiles:
The Canadian Hansard gathers the parliamentary debates of Canada in
English and French, with precise metadata on who is speaking and when
(Roukos et al., 1995).
French Web 2023 (frTenTen23) is a giant web corpus built by crawling:
23.9 billion words from 61 million web pages (Sketch Engine, n.d.). It
belongs to the TenTen family, a set of web corpora built for many
languages to one shared method (Jakubíček et al., 2013).
The two senses coexist without contradicting each other: how much rigour is
needed depends on what the corpus is for. Publishing a study on linguistic
variation takes a constructed corpus; checking the terminology of one job
takes the client’s file.
Sources
Biber, D. (2011). Corpus linguistics and the study of literature: Back to the future?. Scientific Study of Literature, 1(1), 15–23. https://doi.org/10.1075/ssol.1.1.02bib
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Burnard, L. (2004). Metadata for Corpus Work. In M. Wynne (Ed.), Developing Linguistic Corpora: a Guide to Good Practice. AHDS Literature, Languages and Linguistics. https://users.ox.ac.uk/~martinw/dlc/chapter3.htm
Sinclair, J. (2004). Corpus and Text: Basic Principles. In M. Wynne (Ed.), Developing Linguistic Corpora: a Guide to Good Practice. AHDS Literature, Languages and Linguistics. https://users.ox.ac.uk/~martinw/dlc/chapter1.htm
La linguistique de corpus donne au mot un sens exigeant. La définition de
Sinclair est « un ensemble de fragments de texte langagier sous forme
électronique, choisis selon des critères externes pour représenter, autant
que possible, une langue ou une variété de langue, comme source de données
pour la recherche linguistique » (Sinclair, 2004, ma traduction). Des
critères externes, cela veut dire que les textes sont retenus pour ce qu’ils
sont et pour leur provenance, et non pour ce qu’ils disent, afin que
l’échantillon ne puisse pas être constitué de manière à confirmer ce que la
personne qui le construit s’attend à y trouver.
Un corpus en ce sens est l’échantillon de quelque chose, et peut donc être
jugé par rapport à ce quelque chose. Biber le décrit comme
« un échantillon conçu pour représenter un domaine textuel dans une langue »,
et donne pour exemples la conversation courante en anglais, les éditoriaux de
presse, les courriels personnels et les romans de Charles Dickens (Biber,
2011, ma traduction). Il n’existe donc pas de recette fixe de ce qu’un corpus
doit contenir : la composition suit la question à laquelle le corpus doit
répondre, et un corpus d’un seul auteur est aussi légitime qu’un corpus de
toute une langue, pourvu que la cible soit annoncée.
Les corpus se lisent ailleurs qu’en linguistique, et pas toujours pour
décrire le système de la langue : la stylistique de corpus emploie les mêmes
méthodes pour interroger un auteur plutôt que l’anglais (Biber, 2011).
Deux exemples aux profils très différents :
Le Hansard canadien regroupe les débats parlementaires du Canada, en
anglais et en français, avec des métadonnées précises sur les personnes qui
parlent et les dates (Roukos et al., 1995).
French Web 2023 (frTenTen23) est un corpus web géant construit par
moissonnage : 23,9 milliards de mots tirés de 61 millions de pages web
(Sketch Engine, s. d.). Il appartient à la famille TenTen, un ensemble de
corpus web construits pour de nombreuses langues selon une même méthode
(Jakubíček et al., 2013).
Les deux sens coexistent sans se contredire : la rigueur exigée dépend de ce
qu’on veut faire du corpus. Pour publier une étude sur la variation
linguistique, il faut un corpus construit ; pour vérifier la terminologie
d’un mandat, le dossier du client suffit.
Sources
Biber, D. (2011). Corpus linguistics and the study of literature: Back to the future?. Scientific Study of Literature, 1(1), 15–23. https://doi.org/10.1075/ssol.1.1.02bib
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Burnard, L. (2004). Metadata for Corpus Work. In M. Wynne (Ed.), Developing Linguistic Corpora: a Guide to Good Practice. AHDS Literature, Languages and Linguistics. https://users.ox.ac.uk/~martinw/dlc/chapter3.htm
Sinclair, J. (2004). Corpus and Text: Basic Principles. In M. Wynne (Ed.), Developing Linguistic Corpora: a Guide to Good Practice. AHDS Literature, Languages and Linguistics. https://users.ox.ac.uk/~martinw/dlc/chapter1.htm
Texts from varied domains, genres and registers; aims to represent a language as a whole.
frTenTen23 (general web); the large national corpora
Specialized corpus
Texts from one domain or one genre; gives access to the vocabulary, style and usage of a sector.
Legal corpus (statutes, contracts, judgments); medical corpus (protocols, package inserts); video game corpus (dialogue, interfaces)
Specialized corpora are particularly useful in translation to observe the
use of terminology and other domain-specific linguistic conventions (Bowker
and Pearson, 2002).
Monolingual, comparable or parallel
Type
Description
Examples
Monolingual corpus
Texts in one language; serves to observe usage in a register or a domain.
A corpus of Quebec press; user reviews in English
Comparable multilingual corpus
Texts in several languages on the same subject or of the same genre, each typically written originally in its own language rather than translated from another.
French and English press articles on climate policy; product sheets written separately for each market
Parallel multilingual corpus
Source texts and their translations, usually aligned sentence by sentence.
Canadian Hansard (Roukos et al., 1995); Europarl (Koehn, 2005); the United Nations parallel corpus (Ziemski et al., 2016); the OPUS collection (Tiedemann, 2012)
The two multilingual types complete each other. A parallel corpus allows a
segment-by-segment look at the equivalences other translators settled on. A
comparable corpus shows how each language natively expresses similar
content, with no translation behind it: valuable for checking that a phrase
sounds natural rather than calqued.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/
Deux façons de classer les corpus
Général ou spécialisé
Type
Description
Exemples
Corpus général
Textes de domaines, genres et registres variés ; vise à représenter une langue dans sa globalité.
frTenTen23 (web généraliste) ; les grands corpus nationaux
Corpus spécialisé
Textes d’un domaine ou d’un genre particulier ; donne accès au lexique, au style et aux usages propres à un secteur.
Corpus juridique (lois, contrats, jugements) ; corpus médical (protocoles, notices) ; corpus de jeux vidéo (dialogues, interfaces)
Les corpus spécialisés sont particulièrement utiles en traduction pour
observer l’emploi de la terminologie et les autres conventions linguistiques
propres à un domaine (Bowker et Pearson, 2002).
Monolingue, comparable ou parallèle
Type
Description
Exemples
Corpus monolingue
Textes dans une seule langue ; sert à observer les usages dans un registre ou un domaine.
Corpus de presse québécoise ; commentaires d’utilisateurs en anglais
Corpus multilingue comparable
Textes en plusieurs langues sur un même sujet ou du même genre, généralement rédigés à l’origine dans leur langue respective plutôt que traduits d’une autre.
Articles de presse français et anglais sur les politiques climatiques ; fiches produits rédigées séparément pour chaque marché
Corpus multilingue parallèle
Textes originaux et leurs traductions, le plus souvent alignés phrase par phrase.
Hansard canadien (Roukos et al., 1995) ; Europarl (Koehn, 2005) ; le corpus parallèle des Nations Unies (Ziemski et al., 2016) ; la collection OPUS (Tiedemann, 2012)
Les deux types multilingues se complètent. Le corpus parallèle permet une
analyse segment par segment des équivalences choisies par d’autres
traducteurs et traductrices. Le corpus comparable montre comment chaque
langue exprime nativement un contenu semblable, sans influence de la
traduction : précieux pour vérifier qu’une formulation sonne naturelle, et
non calquée.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/
What corpora are forÀ quoi servent les corpus ?
Observing language rather than imagining it
Suppose you are translating a text for the Belgian parliament. You may
wonder whether to write “courriel” or “e-mail”. You may not have a good
intuition and need a way to verify. A Google search may not give you a
definite answer. But if you consult a corpus of specifically Belgian French
texts, relative to your target audience, you can simply check the
frequencies of both words. You can even get an idea for whether the choice
depends on certain contexts, for instance “e-mail” when in a list of contact
information next to “website” and “téléphone”, versus “courriel” more in
running text.
Figure 1. Word Sketch Difference between 'e-mail' (337 occurrences) and 'courriel' (208) in the ParlaTalk Belgium corpus of French parliamentary debates, on the 'and/or' relation: what each word gets listed alongside. Captured 5 September 2026.
Does “porter plainte” take “contre” or “à l’encontre de” more often?
Adjusting register
Comparing general and specialized texts
On a form: “veuillez remplir ce champ” or “remplissez ce champ”?
Spotting calques and false friends
Comparing translated corpora with original ones
“Effectuer une différence” instead of “faire une différence”
Staying consistent for a client
Building a corpus of the client’s documents
Reusing the phrasing of an organization’s earlier reports in a new job
Figure 2. The verbs that co-occur with 'plainte' in frTenTen23, seen in Sketch Engine. Figure 3. The same collocations of 'plainte', shown by grammatical relation.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Supposons que vous traduisiez un texte pour le Parlement belge. Vous pouvez
vous demander s’il faut écrire « courriel » ou « e-mail ». Votre intuition ne
vous donne peut-être pas de réponse sûre, et il vous faut un moyen de
vérifier. Une recherche Google ne tranchera pas forcément. Mais en consultant
un corpus de textes proprement belges, correspondant à votre public cible,
vous pouvez simplement comparer les fréquences des deux mots. Vous pouvez
même vous faire une idée du rôle que joue le contexte dans ce choix :
« e-mail » dans une liste de coordonnées, à côté de « website » et de
« téléphone », contre « courriel » plutôt en texte suivi.
Figure 1. Word Sketch Difference entre « e-mail » (337 occurrences) et « courriel » (208) dans le corpus ParlaTalk Belgium des débats parlementaires belges en français, sur la relation « and/or » : ce à côté de quoi chaque mot est cité. Capture du 5 septembre 2026.
« Porter plainte » se construit-il plus souvent avec « contre » ou avec « à l’encontre de » ?
Adapter le registre
Comparer des textes généraux et spécialisés
Formulaire : « veuillez remplir ce champ » ou « remplissez ce champ » ?
Repérer les calques et les faux amis
Comparer corpus traduits et corpus originaux
« Effectuer une différence » au lieu de « faire une différence »
Assurer la cohérence pour un client
Constituer un corpus des documents du client
Réutiliser les tournures des rapports antérieurs d’un organisme dans un nouveau mandat
Figure 2. Les verbes qui cooccurrent avec « plainte » dans frTenTen23, vus dans Sketch Engine. Figure 3. Les mêmes collocations de « plainte », visualisées par relation grammaticale.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Working with Sketch EngineTravailler avec Sketch Engine
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Getting started with Sketch EngineDécouvrir Sketch Engine
What it is
Sketch Engine (sketchengine.eu) is a
commercial online corpus analysis tool, used by translators, linguists,
lexicographers and NLP specialists (Kilgarriff et al., 2014). Among other
things, it lets you:
analyze frequencies, registers and grammatical constructions.
Why this tool here, and what else exists
This module works in Sketch Engine because my students have access to it:
the Université de Montréal subscribes, so you log in with your usual
credentials and there is nothing to install or configure. Outside an institutional subscription it is
a paid service with a 30-day free trial.
With a browser-based tool that is relatively intuitive, you can learn a lot
by simply clicking around and exploring, without worrying about doing
something “wrong”. The built-in documentation is where to look first: the
small “i” icons beside most fields, and the “LEARN” tabs.
It is one tool among several, and what you learn here transfers. AntConc
(Anthony, 2026) is free to download, runs on Windows, macOS and Linux, and
does concordances, word lists, collocations and keywords on files you supply
yourself. What it does not give you is the other half of this module: a
collection of ready-made corpora of billions of words, and a corpus built
from the web in a few minutes.
Logging in
On the site, click “Log In”.
Figure 1. The Sketch Engine home page, with the Log In button in the top right.
Choose “Full Access Login” (the site sometimes skips this step, which is
normal), then “Institutional Login”.
Figure 2. The login options, including Full Access Login. Figure 3. The login page, with the Institutional Login option for universities.
Choose your institution from the list, for instance “Université de Montréal”,
and log in with your usual credentials.
Figure 4. The list of partner institutions, including the Université de Montréal.
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Ce que c’est
Sketch Engine (sketchengine.eu) est un
outil commercial d’analyse de corpus en ligne, utilisé par des traducteurs et
traductrices, des linguistes, des lexicographes et des spécialistes du TAL
(Kilgarriff et al., 2014). Il permet notamment de :
comparer les usages entre deux corpus (mots-clés) ;
analyser fréquences, registres et constructions grammaticales.
Pourquoi cet outil ici, et ce qui existe à côté
Ce module travaille dans Sketch Engine parce que mes étudiantes et étudiants
y ont accès : l’Université de Montréal y est abonnée, vous vous connectez
donc avec vos identifiants habituels et il n’y a rien à installer ni à
configurer. Hors
abonnement institutionnel, c’est un service payant, avec un essai gratuit de
30 jours.
Avec un outil en ligne relativement intuitif, vous pouvez apprendre beaucoup
en cliquant un peu partout et en explorant, sans craindre de mal faire. La
documentation intégrée est le premier réflexe : les petits « i » à côté de la
plupart des champs, et les onglets « LEARN ».
C’est un outil parmi d’autres, et ce que vous y apprenez se transpose.
AntConc (Anthony, 2026) est gratuit, fonctionne sous Windows, macOS et
Linux, et produit concordances, listes de fréquences, collocations et
mots-clés sur les fichiers que vous lui fournissez. Ce qu’il ne donne pas,
c’est l’autre moitié de ce module : une collection de corpus prêts à
l’emploi de plusieurs milliards de mots, et un corpus construit depuis le web
en quelques minutes.
Se connecter
Sur le site, cliquez sur « Log In ».
Figure 1. La page d'accueil de Sketch Engine, avec le bouton « Log In » en haut à droite.
Choisissez « Full Access Login » (le site saute parfois cette étape, c’est
normal), puis « Institutional Login ».
Figure 2. Les options de connexion, dont « Full Access Login ». Figure 3. La page de connexion, avec l'option « Institutional Login » pour les universités.
Choisissez votre établissement dans la liste, par exemple « Université de
Montréal », et connectez-vous avec vos identifiants habituels.
Figure 4. La liste des institutions partenaires, dont l'Université de Montréal.
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Exploring the existing corporaExplorer les corpus existants
The starting page
After logging in you land on the starting page: a search box and, if you
have used the tool before, your recent corpora.
Figure 5. The home page after login: search box and recently used corpora.
Finding a corpus
Clicking in “type to search” already suggests a selection of corpora. To see
everything, click “ADVANCED SEARCH”.
Figure 6. Corpus search, with the ADVANCED SEARCH option for browsing the whole collection.
The full list shows the language, name and size in words of each corpus,
with categories on the right: web corpora, spoken language, parallel
(multilingual), specialized, diachronic, and so on.
Figure 7. The list of available corpora: language, name, size.
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
La page de départ
Après la connexion, vous arrivez sur la page de départ : une barre de
recherche et, si vous avez déjà utilisé l’outil, vos corpus récents.
Figure 5. La page d'accueil après connexion : barre de recherche et corpus récemment utilisés.
Chercher un corpus
Un clic dans « type to search » propose déjà une sélection de corpus. Pour
tout voir, cliquez sur « ADVANCED SEARCH ».
Figure 6. La recherche de corpus, avec l'option « ADVANCED SEARCH » pour explorer toute la collection.
La liste complète affiche la langue, le nom et la taille en mots de chaque
corpus, avec des catégories à droite : corpus web, langue parlée, parallèles
(multilingues), spécialisés, diachroniques, etc.
Figure 7. La liste des corpus disponibles : langue, nom, taille.
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Building a corpus from the webCréer un corpus à partir du web
Click “NEW CORPUS” (the button in the top right corner of the corpus list,
or the option at the bottom of the search box).
Figure 9. The NEW CORPUS button.
Give the corpus a name, choose “single language corpus” and French. The
description is optional.
Figure 10. The initial configuration: name and language of the corpus.
What is available depends on the language: “available features” shows what
is possible in French. For comparison, a less-resourced language such as
Chuj offers far fewer options.
Figure 11. The features available for the chosen language.
Where the texts come from
Next you choose between uploading your own files (to analyze a corpus you
already have) and building a corpus from texts found online. We have no
corpus at hand, so: “find texts on the web”. The page also shows your
account’s storage space and how much of it you have used.
Figure 12. Choosing the source: your own files or texts from the web.
There are three ways of finding texts:
“web search”: search online from a few keywords;
“URLs”: supply a list of addresses to download;
“website”: download a complete site.
The ”?” beside each option gives more detail. We take “web search”: the tool
will query the Bing search engine with different combinations of your
keywords.
Figure 13. Three ways of building a web corpus: keywords, a list of addresses or a whole site. Figure 14. The question mark explains each option.
The settings of the web search can also be adjusted at this step; the
defaults are fine for this exercise.
The keywords
What is left is the keywords that will guide the search. I suggest you start
from your own expertise and build a corpus on a subject you know well:
crochet, manga, figure skating, translation. You will be all the better
placed to judge whether the texts it finds are relevant.
Figure 15. Entering the keywords that will guide the search for texts.
Then click GO! and wait a little.
Figure 16. The progress of the search.
The tool shows how many pages each combination of keywords found. Each line
unfolds to show the addresses of the pages; deselect the ones that are not
relevant to keep them out of the final corpus.
Figure 17. The pages found for each combination of keywords.
One more wait while the tool downloads and processes the texts, especially
if it found a lot of pages.
Figure 18. The texts being downloaded and processed. Figure 19. The corpus is ready.
Sources
Kilgarriff, A., & Grefenstette, G. (2003). Introduction to the Special Issue on the Web as Corpus. Computational Linguistics, 29(3). https://doi.org/10.1162/089120103322711569
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Cliquez sur « NEW CORPUS » (le bouton dans le coin supérieur droit de la
liste des corpus, ou l’option au bas de la barre de recherche).
Figure 9. Le bouton « NEW CORPUS ».
Donnez un nom au corpus, choisissez « single language corpus » et le
français. La description est facultative.
Figure 10. La configuration initiale : nom et langue du corpus.
Les fonctionnalités dépendent de la langue : « available features » montre
ce qui est possible en français. À titre de comparaison, une langue peu
dotée comme le chuj offre beaucoup moins d’options.
Figure 11. Les fonctionnalités disponibles selon la langue choisie.
La source des textes
Il faut ensuite choisir entre téléverser vos propres fichiers (pour analyser
un corpus que vous possédez déjà) et construire un corpus à partir de textes
en ligne. Nous n’avons pas de corpus sous la main, donc : « find texts on
the web ». La page indique aussi l’espace de stockage de votre compte et ce
que vous en avez utilisé.
Figure 12. Le choix de la source : fichiers personnels ou textes du web.
Pour trouver des textes, trois options :
« web search » : chercher en ligne à partir de quelques mots-clés ;
« URLs » : fournir une liste d’adresses à télécharger ;
« website » : télécharger un site complet.
Les « ? » à côté de chaque option donnent plus de détails. Nous prenons
« web search » : l’outil interrogera le moteur de recherche Bing avec
différentes combinaisons de vos mots-clés.
Figure 13. Trois façons de construire un corpus web : mots-clés, liste d'adresses ou site complet. Figure 14. Le « ? » explique chaque option.
Les paramètres de la recherche web se règlent aussi à cette étape ; les
valeurs par défaut conviennent pour cet exercice.
Les mots-clés
Reste à définir les mots-clés qui guideront la recherche. Je propose que
vous partiez de votre propre expertise et créiez un corpus sur un sujet que
vous connaissez bien : le crochet, les mangas, le patinage artistique, la
traduction… Vous saurez d’autant mieux juger si les textes récoltés sont
pertinents.
Figure 15. La saisie des mots-clés qui guideront la recherche de textes.
Puis cliquez sur GO! et patientez un peu.
Figure 16. La progression de la recherche.
L’outil montre combien de pages chaque combinaison de mots-clés a trouvées.
Chaque ligne se déplie pour afficher les adresses des pages ; désélectionnez
celles qui ne sont pas pertinentes pour les exclure du corpus final.
Figure 17. Les pages trouvées pour chaque combinaison de mots-clés.
Une dernière attente pendant que l’outil télécharge et traite les textes,
surtout s’il a trouvé beaucoup de pages.
Figure 18. Le traitement des textes récoltés. Figure 19. Le corpus est prêt.
Sources
Kilgarriff, A., & Grefenstette, G. (2003). Introduction to the Special Issue on the Web as Corpus. Computational Linguistics, 29(3). https://doi.org/10.1162/089120103322711569
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Checking and tuning your web corpusVérifier et régler son corpus web
Checking what you collected
Once the corpus is ready, start with its statistics (“corpus details and
statistics”). I do not explain each indicator here: the small “i” icons of
the interface do it very well.
Figure 20. The statistics of a freshly built corpus: word counts, frequencies, composition.
“Text type analysis” details the text types and the sources the corpus is
made of. That is where you see whether what you collected matches what you were
after: a corpus on figure skating that draws half its pages from a single
online shop is not the one you were looking for.
Figure 21. The analysis of the text types and sources of the corpus.
What the settings control
The defaults were enough to build a first corpus. When the result is not the
one you wanted, these are the settings to go back to.
Figure 22. The settings of the web search.
Size or relevance
A slider sets the balance between “size” (quantity) and “relevance”:
more relevance: the algorithm keeps only the first results of each
Bing search, taken to be the most relevant;
more size: it goes further down the results and takes more texts, but
texts that may be less relevant.
Allowlist and denylist
Figure 23. The denylist and allowlist options.
The allowlist names required words: a page enters the corpus only if it
contains a minimum number of them. The denylist names words to avoid,
with a setting for how strict to be.
These lists mostly serve to disambiguate polysemous keywords. For a corpus
on the programming languages “Java” and “Python”, the web also talks about
an island and a snake; hence, for example:
The web being immense, you can also cap the number of documents and their
length, to obtain a smaller corpus.
Figure 24. The size caps of the corpus.
Managing the corpus
To come back to the corpus, click the Sketch Engine logo in the top left,
then “manage corpus”.
Figure 25. The management menu: download, extend, share, delete.
There you can download the corpus, extend it with new texts, share it or
delete it. You can also create subcorpora, for instance to separate French
sites from Canadian ones and compare the two.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Vérifier ce que vous avez récolté
Une fois le corpus prêt, commencez par ses statistiques (« corpus details
and statistics »). Je n’explique pas chaque indicateur ici : les petits
« i » de l’interface le font très bien.
Figure 20. Les statistiques d'un corpus fraîchement créé : nombre de mots, fréquences, composition.
Le « text type analysis » détaille les types de textes et les sources qui
composent le corpus. C’est là que vous voyez si la récolte correspond à ce
que vous vouliez : un corpus sur le patinage artistique qui tire la moitié
de ses pages d’une seule boutique en ligne n’est pas celui que vous
cherchiez.
Figure 21. L'analyse des types de textes et des sources du corpus.
Ce que contrôlent les paramètres
Les valeurs par défaut suffisaient pour construire un premier corpus. Quand
le résultat n’est pas celui que vous vouliez, ce sont ces paramètres qu’il
faut reprendre.
Figure 22. Les paramètres de la recherche web.
Taille ou pertinence
Un curseur règle l’équilibre entre « size » (quantité) et « relevance »
(pertinence) :
plus de pertinence : l’algorithme ne retient que les premiers
résultats de chaque recherche Bing, censés être les plus pertinents ;
plus de taille : il descend plus loin dans les résultats, récolte plus
de textes, mais des textes potentiellement moins pertinents.
Allowlist et denylist
Figure 23. Les options « denylist » et « allowlist ».
L’allowlist énumère des mots obligatoires : une page n’entre dans le
corpus que si elle en contient un nombre minimal. La denylist énumère
des mots à éviter, avec un réglage plus ou moins strict.
Ces listes servent surtout à désambiguïser des mots-clés polysémiques. Pour
un corpus sur les langages de programmation « Java » et « Python », le web
parle aussi d’une île et d’un serpent ; d’où, par exemple :
Le web étant immense, on peut aussi plafonner le nombre de documents et leur
longueur pour obtenir un corpus plus petit.
Figure 24. Les plafonds de taille du corpus.
Gérer le corpus
Pour revenir au corpus, cliquez sur le logo Sketch Engine en haut à gauche,
puis sur « manage corpus ».
Figure 25. Le menu de gestion : télécharger, élargir, partager, supprimer.
On peut y télécharger le corpus, l’élargir avec de nouveaux textes, le
partager ou le supprimer. On peut aussi créer des sous-corpus
(« subcorpora »), par exemple pour séparer les sites français des sites
canadiens et comparer les deux.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
The practice corpusLe corpus des exercices
Your own web corpus is unique: nobody else has exactly the same one. So that
the exercises have checkable answers, they use a corpus that is already in
Sketch Engine and identical for everyone: Gutenberg French 2020, a large
corpus of French literary texts built from the ebooks of the Gutenberg
project.
Go back to the corpus search and select it.
Figure 26. Selecting the Gutenberg French 2020 corpus in the list of corpora. Figure 27. The corpus record as given on the Sketch Engine site. Figure 28. The statistics of the corpus: 234,716,070 tokens and 197,560,500 words.
The statistics of the Gutenberg French 2020 corpus read 234,716,070 tokens and 197,560,500 words. Which of the following best explains why there are more tokens than words?
Dans les statistiques du corpus Gutenberg French 2020, on lit 234 716 070 « tokens » et 197 560 500 « words ». Lequel des énoncés suivants explique le mieux pourquoi le nombre de tokens est supérieur au nombre de words ?
Show the solutionVoir la solution
In Sketch Engine every token is a separate textual unit (usually separated by spaces or punctuation), but only those that begin with a letter count as words. Punctuation, numbers and symbols are therefore among the tokens and not among the words.
What to take from it: the definition of "word" varies from one tool to another. In Sketch Engine a word is a token that begins with a letter of the alphabet (or with an ideogram, in some Asian languages).
Dans Sketch Engine, tous les tokens sont des unités textuelles séparées (généralement par des espaces ou des signes de ponctuation), mais seuls ceux qui commencent par une lettre sont comptés comme words. La ponctuation, les nombres et les symboles comptent donc parmi les tokens, mais pas parmi les words.
Point à retenir : la définition de « mot » varie d'un outil à l'autre. Dans Sketch Engine, un word est un token qui commence par une lettre de l'alphabet (ou un idéogramme dans certaines langues asiatiques).
Votre propre corpus web est unique : personne d’autre n’a exactement le
même. Pour que les exercices aient des réponses vérifiables, ils utilisent
donc un corpus déjà présent dans Sketch Engine, identique pour tout le
monde : Gutenberg French 2020, un grand corpus de textes littéraires
français construit à partir des livres numériques du projet Gutenberg.
Retournez à la recherche de corpus et sélectionnez-le.
Figure 26. La sélection du corpus Gutenberg French 2020 dans la liste des corpus. Figure 27. La fiche du corpus selon le site de Sketch Engine. Figure 28. Les statistiques du corpus : 234 716 070 « tokens » et 197 560 500 « words ».
The statistics of the Gutenberg French 2020 corpus read 234,716,070 tokens and 197,560,500 words. Which of the following best explains why there are more tokens than words?
Dans les statistiques du corpus Gutenberg French 2020, on lit 234 716 070 « tokens » et 197 560 500 « words ». Lequel des énoncés suivants explique le mieux pourquoi le nombre de tokens est supérieur au nombre de words ?
Show the solutionVoir la solution
In Sketch Engine every token is a separate textual unit (usually separated by spaces or punctuation), but only those that begin with a letter count as words. Punctuation, numbers and symbols are therefore among the tokens and not among the words.
What to take from it: the definition of "word" varies from one tool to another. In Sketch Engine a word is a token that begins with a letter of the alphabet (or with an ideogram, in some Asian languages).
Dans Sketch Engine, tous les tokens sont des unités textuelles séparées (généralement par des espaces ou des signes de ponctuation), mais seuls ceux qui commencent par une lettre sont comptés comme words. La ponctuation, les nombres et les symboles comptent donc parmi les tokens, mais pas parmi les words.
Point à retenir : la définition de « mot » varie d'un outil à l'autre. Dans Sketch Engine, un word est un token qui commence par une lettre de l'alphabet (ou un idéogramme dans certaines langues asiatiques).
Wordlist: frequency listsWordlist : les listes de fréquences
Producing a frequency list
For this first function I set out the steps; for the ones after it, you
explore more on your own.
Go to Wordlist in the left-hand menu.
Figure 29. Reaching Wordlist from the main menu. Figure 30. The Wordlist form.
Wordlist produces the ranking of the most frequent words of a corpus. It
is a basic function, and it answers several questions at once: what
vocabulary dominates a domain, which words are function words, what the
nouns alone look like, what is frequent and what is rare.
Start with the “LEARN” tab, which documents the function well.
Figure 31. The LEARN tab: the built-in documentation of Wordlist.
Go back to “BASIC”, keep the default values (“words”, “all”) and click “GO”.
Figure 32. The results: every word of the corpus, sorted by frequency.
The result lists every word of the corpus by decreasing frequency. Finding
nothing but function words in the top 50 is normal: that is the profile of
every language.
Filtering the list
Do the same thing again, selecting “noun” to keep only nouns.
Figure 33. The most frequent nouns of the corpus.
Hardly a surprise for classical literature, but telling: the corpus contains
far more “homme” than “femme”, and even more “monsieur” than “femme”.
Another cut, the French verb forms ending in “ée”:
Figure 34. The most frequent verb forms in 'ée'.
Advanced mode gives more control still: treating capitals as distinctive or
not, setting a minimum and a maximum frequency, restricting to a subcorpus
or to text types.
Figure 35. The advanced options of Wordlist.
Exercises
The three exercises are done in Gutenberg French 2020, with the
Wordlist function. Look in the tool first; the answer is checked right in
the page.
ExerciseExercice 2 · the most frequent adjective containing an al'adjectif le plus fréquent avec un anot startedà fairesolvedréussikeep tryingà retravailler
In the Gutenberg corpus, what is the frequency of the most frequent adjective that contains an "a"? Include nonwords and ignore capitalization.
Dans le corpus Gutenberg, quelle est la fréquence de l'adjectif le plus fréquent qui contient un « a » ? Incluez les « nonwords » et ignorez la casse.
Show the explanationVoir l'explication
The most frequent adjective containing an "a" is "grand", with 383,550 occurrences. To find it: in Wordlist, select "adjective" as the part of speech; the results are sorted by frequency, so look for the first one that contains an "a".
L'adjectif le plus fréquent contenant un « a » est « grand », avec 383 550 occurrences. Pour le trouver : dans Wordlist, sélectionnez « adjective » comme catégorie grammaticale ; les résultats sont triés par fréquence, cherchez le premier qui contient un « a ».
ExerciseExercice 3 · the most frequent pronounle pronom le plus fréquentnot startedà fairesolvedréussikeep tryingà retravailler
What is the most frequent pronoun in the Gutenberg corpus? Include nonwords and ignore capitalization.
Quel est le pronom le plus fréquent dans le corpus Gutenberg ? Incluez les « nonwords » et ignorez la casse.
Show the explanationVoir l'explication
The pronoun "il" occurs 2,784,254 times in the corpus. "Elle" comes only 9th, with 994,019 occurrences, almost three times fewer. That reflects the unequal place of male and female characters in the classical French literature this corpus is made of.
Le pronom « il » apparaît 2 784 254 fois dans le corpus. « elle » n'arrive qu'en 9e position, avec 994 019 occurrences, presque trois fois moins. Cela reflète la place inégale des personnages masculins et féminins dans la littérature française classique qui compose ce corpus.
The last one needs advanced mode, and one detail: the search has to stay
case-sensitive.
ExerciseExercice 4 · the most frequent capital Ble B majuscule le plus fréquentnot startedà fairesolvedréussikeep tryingà retravailler
Use the advanced search of Wordlist to find the most frequent word beginning with a capital B.
Utilisez la recherche avancée de Wordlist pour trouver le mot le plus fréquent qui commence par un B majuscule.
Show the explanationVoir l'explication
Answer: "Bien", with 14,923 occurrences. In Wordlist > ADVANCED, use find words > starting with and enter B, then uncheck A = a so that the search tells capitals from lower case. "Bien" owes its frequency to its position at the start of a sentence, very common in literary dialogue.
Réponse : « Bien », avec 14 923 occurrences. Dans Wordlist > ADVANCED, utilisez find words > starting with et entrez B, puis décochez A = a pour que la recherche distingue les majuscules des minuscules. « Bien » doit sa fréquence à sa position en début de phrase, très courante dans les dialogues littéraires.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Pour cette première fonctionnalité, je détaille les étapes ; pour les
suivantes, ce sera à vous d’explorer de façon plus autonome.
Naviguez vers Wordlist dans le menu de gauche.
Figure 29. L'accès à Wordlist depuis le menu principal. Figure 30. Le formulaire de Wordlist.
Wordlist produit le classement des mots les plus fréquents d’un corpus.
C’est une fonction de base, et elle répond à plusieurs questions à la fois :
quel vocabulaire domine un domaine, quels mots sont des mots-outils, à quoi
ressemblent les noms seuls, ce qui est fréquent et ce qui est rare.
Commencez par l’onglet « LEARN », qui documente bien la fonction.
Figure 31. L'onglet LEARN : la documentation intégrée de Wordlist.
Revenez à « BASIC », gardez les valeurs par défaut (« words », « all ») et
cliquez sur « GO ».
Figure 32. Les résultats : tous les mots du corpus, triés par fréquence.
Le résultat liste tous les mots du corpus par fréquence décroissante. Ne
trouver que des mots de fonction dans le top 50 est normal : c’est le
profil de toutes les langues.
Filtrer la liste
Refaites la même chose en sélectionnant « noun » pour ne garder que les
noms.
Figure 33. Les noms les plus fréquents du corpus.
Peu surprenant pour de la littérature classique, mais parlant : le corpus
contient beaucoup plus de « homme » que de « femme », et même plus de
« monsieur » que de « femme ».
Autre découpage, les verbes qui se terminent par « ée » :
Figure 34. Les formes verbales en « ée » les plus fréquentes.
Le mode avancé donne encore plus de contrôle : traiter ou non les
majuscules comme distinctives, fixer une fréquence minimale et maximale,
restreindre à un sous-corpus ou à des types de textes.
Figure 35. Les options avancées de Wordlist.
Exercices
Les trois exercices se font dans Gutenberg French 2020, avec la fonction
Wordlist. Cherchez d’abord dans l’outil ; la réponse se vérifie
directement dans la page.
ExerciseExercice 2 · the most frequent adjective containing an al'adjectif le plus fréquent avec un anot startedà fairesolvedréussikeep tryingà retravailler
In the Gutenberg corpus, what is the frequency of the most frequent adjective that contains an "a"? Include nonwords and ignore capitalization.
Dans le corpus Gutenberg, quelle est la fréquence de l'adjectif le plus fréquent qui contient un « a » ? Incluez les « nonwords » et ignorez la casse.
Show the explanationVoir l'explication
The most frequent adjective containing an "a" is "grand", with 383,550 occurrences. To find it: in Wordlist, select "adjective" as the part of speech; the results are sorted by frequency, so look for the first one that contains an "a".
L'adjectif le plus fréquent contenant un « a » est « grand », avec 383 550 occurrences. Pour le trouver : dans Wordlist, sélectionnez « adjective » comme catégorie grammaticale ; les résultats sont triés par fréquence, cherchez le premier qui contient un « a ».
ExerciseExercice 3 · the most frequent pronounle pronom le plus fréquentnot startedà fairesolvedréussikeep tryingà retravailler
What is the most frequent pronoun in the Gutenberg corpus? Include nonwords and ignore capitalization.
Quel est le pronom le plus fréquent dans le corpus Gutenberg ? Incluez les « nonwords » et ignorez la casse.
Show the explanationVoir l'explication
The pronoun "il" occurs 2,784,254 times in the corpus. "Elle" comes only 9th, with 994,019 occurrences, almost three times fewer. That reflects the unequal place of male and female characters in the classical French literature this corpus is made of.
Le pronom « il » apparaît 2 784 254 fois dans le corpus. « elle » n'arrive qu'en 9e position, avec 994 019 occurrences, presque trois fois moins. Cela reflète la place inégale des personnages masculins et féminins dans la littérature française classique qui compose ce corpus.
Le dernier demande le mode avancé, et un détail : la recherche doit rester
sensible à la casse.
ExerciseExercice 4 · the most frequent capital Ble B majuscule le plus fréquentnot startedà fairesolvedréussikeep tryingà retravailler
Use the advanced search of Wordlist to find the most frequent word beginning with a capital B.
Utilisez la recherche avancée de Wordlist pour trouver le mot le plus fréquent qui commence par un B majuscule.
Show the explanationVoir l'explication
Answer: "Bien", with 14,923 occurrences. In Wordlist > ADVANCED, use find words > starting with and enter B, then uncheck A = a so that the search tells capitals from lower case. "Bien" owes its frequency to its position at the start of a sentence, very common in literary dialogue.
Réponse : « Bien », avec 14 923 occurrences. Dans Wordlist > ADVANCED, utilisez find words > starting with et entrez B, puis décochez A = a pour que la recherche distingue les majuscules des minuscules. « Bien » doit sa fréquence à sa position en début de phrase, très courante dans les dialogues littéraires.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
ExerciseExercice 5 · the frequency of "de"fréquence de « de »not startedà fairesolvedréussikeep tryingà retravailler
What is the frequency of the word "de" in the French UNPC corpus?
Quelle est la fréquence du mot « de » dans le corpus UNPC français ?
Show the explanationVoir l'explication
"De" occurs 50,020,990 times. It is the most frequent word of the UNPC corpus, as it is of the Gutenberg corpus: typical of French.
This corpus carries metadata about when each text was published. The results therefore give more than one overall frequency: they also show how that frequency moves over time.
« de » apparaît 50 020 990 fois. C'est le mot le plus fréquent du corpus UNPC, comme du corpus Gutenberg : typique du français.
Ce corpus porte des métadonnées sur la date de publication de chaque texte. Les résultats ne donnent donc pas qu'une fréquence globale : ils montrent aussi son évolution dans le temps.
ExerciseExercice 6 · the frequency of the apostrophefréquence de l'apostrophenot startedà fairesolvedréussikeep tryingà retravailler
What is the frequency of the apostrophe (') in the UNPC corpus?
Quelle est la fréquence de l'apostrophe (« ' ») dans le corpus UNPC ?
Show the explanationVoir l'explication
The apostrophe occurs 41,107,133 times. It is very frequent in French because of elision: "l'", "d'", "qu'", and so on. And since it is a token in its own right, it appears in the list alongside the words.
L'apostrophe apparaît 41 107 133 fois. Elle est très fréquente en français à cause des élisions : « l' », « d' », « qu' », etc. Et comme il s'agit d'un token à part entière, elle figure dans la liste au même titre que les mots.
The word at the top is the same in both corpora, “de”, which is the ordinary
profile of French. Every frequency in the UNPC is nonetheless several times
higher, because that corpus is much bigger. Raw counts therefore measure the
size of the corpus in part, and two corpora of different sizes do not compare
directly.
Proportions like that are hard to read and hard to compare at a glance, so
corpus tools scale them to a common base, usually one million words (Brezina,
2018, chap. 2):
relative frequency = (absolute frequency ÷ corpus size) × 1,000,000
A worked example. A word appears 300 times in a corpus of one million words:
300 occurrences per million. The same word appears 1,200 times in a corpus
of ten million words: 120 occurrences per million. Despite four times as
many occurrences, it is proportionally rarer there.
For the exercises that follow, go back to the Gutenberg French 2020
corpus.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/
La même fonction sur un autre corpus
Dans le corpus Gutenberg, fait de textes littéraires, les cinq mots les plus
fréquents sont ceux-ci :
Figure 36. Le top 5 du corpus Gutenberg French 2020.
ExerciseExercice 5 · the frequency of "de"fréquence de « de »not startedà fairesolvedréussikeep tryingà retravailler
What is the frequency of the word "de" in the French UNPC corpus?
Quelle est la fréquence du mot « de » dans le corpus UNPC français ?
Show the explanationVoir l'explication
"De" occurs 50,020,990 times. It is the most frequent word of the UNPC corpus, as it is of the Gutenberg corpus: typical of French.
This corpus carries metadata about when each text was published. The results therefore give more than one overall frequency: they also show how that frequency moves over time.
« de » apparaît 50 020 990 fois. C'est le mot le plus fréquent du corpus UNPC, comme du corpus Gutenberg : typique du français.
Ce corpus porte des métadonnées sur la date de publication de chaque texte. Les résultats ne donnent donc pas qu'une fréquence globale : ils montrent aussi son évolution dans le temps.
ExerciseExercice 6 · the frequency of the apostrophefréquence de l'apostrophenot startedà fairesolvedréussikeep tryingà retravailler
What is the frequency of the apostrophe (') in the UNPC corpus?
Quelle est la fréquence de l'apostrophe (« ' ») dans le corpus UNPC ?
Show the explanationVoir l'explication
The apostrophe occurs 41,107,133 times. It is very frequent in French because of elision: "l'", "d'", "qu'", and so on. And since it is a token in its own right, it appears in the list alongside the words.
L'apostrophe apparaît 41 107 133 fois. Elle est très fréquente en français à cause des élisions : « l' », « d' », « qu' », etc. Et comme il s'agit d'un token à part entière, elle figure dans la liste au même titre que les mots.
Le mot en tête est le même dans les deux corpus, « de », ce qui est le
profil ordinaire du français. Toutes les fréquences de l’UNPC sont pourtant
plusieurs fois plus élevées, parce que ce corpus est beaucoup plus gros. Les
comptes bruts mesurent donc en partie la taille du corpus, et deux corpus de
tailles différentes ne se comparent pas directement.
De telles proportions se lisent et se comparent mal d’un coup d’œil ; les
outils de corpus les ramènent donc à une base commune, d’habitude un million
de mots (Brezina, 2018, chap. 2) :
Un exemple chiffré. Un mot apparaît 300 fois dans un corpus d’un million de
mots : 300 occurrences par million. Le même mot apparaît 1 200 fois dans un
corpus de dix millions de mots : 120 occurrences par million. Malgré quatre
fois plus d’occurrences, il y est proportionnellement plus rare.
Pour la suite des exercices, revenez au corpus Gutenberg French 2020.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/
ConcordancesLes concordances
This is the basic tool of corpus linguistics. A frequency list tells you how
often a word appears; a concordance shows you the word at work, which is
where you can see:
frequent collocations;
the syntactic construction around the word (verb plus preposition, and so
on);
register and style (formal, narrative, archaizing);
The exercises that follow are done in the Concordance function, still on
the Gutenberg corpus.
ExerciseExercice 7 · the first collocate of "homme"le premier collocatif de « homme »not startedà fairesolvedréussikeep tryingà retravailler
Search for "homme" in Concordance (Gutenberg corpus), then find how to display the collocations of the word from the concordance itself, without going through another function such as Word Sketch. What is the first word of the list of collocates?
Cherchez « homme » dans Concordance (corpus Gutenberg), puis trouvez comment afficher les collocations du mot à partir de la concordance, sans passer par une autre fonctionnalité comme Word Sketch. Quel est le premier mot de la liste de collocatifs ?
Show the explanationVoir l'explication
Answer: "jeune". From a concordance, an icon in the toolbar (top right of the results) computes the collocations of the words surrounding the occurrences. "Jeune homme" is an extremely common expression in classical French literature, which is why "jeune" comes first.
Réponse : « jeune ». Depuis une concordance, une icône de la barre d'outils (en haut à droite des résultats) calcule les collocations des mots qui entourent les occurrences. « Jeune homme » est une expression extrêmement courante dans la littérature française classique, d'où la première place de « jeune ».
Still in Concordance, search this time for "femme", then find the GDEX function (Good Dictionary EXamples) and look at the sentences it offers. What does GDEX do?
Toujours dans Concordance, cherchez cette fois « femme », puis trouvez la fonction GDEX (Good Dictionary EXamples) et regardez les phrases qu'elle propose. Que fait GDEX ?
Show the solutionVoir la solution
GDEX is a Sketch Engine algorithm that automatically picks out good example sentences for a word: short enough to be readable, grammatically complete, representative of typical usage, without too many rare or technical words. It defines nothing and invents nothing: every sentence comes from the corpus.
For translation, GDEX helps you see how a word is used "naturally", and gives examples to quote or to imitate. The order of the sentences it offers can vary from one session to another.
GDEX est un algorithme de Sketch Engine qui repère automatiquement de bonnes phrases d'exemple pour un mot : assez courtes pour être lisibles, grammaticalement complètes, représentatives de l'usage typique, sans trop de mots rares ou techniques. Il ne définit rien et n'invente rien : toutes les phrases viennent du corpus.
Pour la traduction, GDEX aide à voir comment un mot s'utilise « naturellement » et fournit des exemples à citer ou à imiter. L'ordre des phrases proposées peut varier d'une session à l'autre.
Search for the word "canada" (simple search) in Concordance, then display the distribution of that word across the corpus: does it turn up more or less everywhere, or does it cluster in certain texts? Among the four distributions above, which one is that of "Canada"?
Cherchez le mot « canada » (recherche simple) dans Concordance, puis visualisez la distribution de ce mot dans le corpus : apparaît-il un peu partout, ou se concentre-t-il dans certains textes ? Parmi les quatre distributions ci-dessus, laquelle est celle de « Canada » ?
Show the solutionVoir la solution
The distribution of "Canada" is distribution A: heavily concentrated in a few texts that talk about Canada specifically. (The other three are those of "Belgique", "France" and "Suisse" in the same corpus.)
Why it matters: a very concentrated distribution warns you that the frequency of a word may be inflated by a handful of texts. Reliable analysis wants occurrences spread over several texts; the distribution also helps tell "general" words from "thematic" ones. Compare with "France", spread far more evenly across this French literature.
La distribution de « Canada » est la distribution A : très concentrée dans quelques textes qui parlent spécifiquement du Canada. (Les autres distributions sont celles de « Belgique », « France » et « Suisse » dans le même corpus.)
Pourquoi c'est important : une distribution très concentrée signale que la fréquence d'un mot peut être gonflée par une poignée de textes. Pour une analyse fiable, mieux vaut des occurrences réparties dans plusieurs textes ; la distribution aide aussi à distinguer les mots « généraux » des mots « thématiques ». Comparez avec « France », répartie beaucoup plus uniformément dans cette littérature française.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
C’est l’outil de base de la linguistique de corpus. Une liste de fréquences
dit combien de fois un mot apparaît ; une concordance le montre à l’œuvre, et
c’est là qu’on peut voir :
les collocations fréquentes ;
la construction syntaxique autour du mot (verbe + préposition, etc.) ;
le registre et le style (soutenu, narratif, archaïsant) ;
les habitudes d’une autrice, d’une époque, d’un genre textuel.
Les exercices qui suivent se font dans la fonction Concordance, toujours
sur le corpus Gutenberg.
ExerciseExercice 7 · the first collocate of "homme"le premier collocatif de « homme »not startedà fairesolvedréussikeep tryingà retravailler
Search for "homme" in Concordance (Gutenberg corpus), then find how to display the collocations of the word from the concordance itself, without going through another function such as Word Sketch. What is the first word of the list of collocates?
Cherchez « homme » dans Concordance (corpus Gutenberg), puis trouvez comment afficher les collocations du mot à partir de la concordance, sans passer par une autre fonctionnalité comme Word Sketch. Quel est le premier mot de la liste de collocatifs ?
Show the explanationVoir l'explication
Answer: "jeune". From a concordance, an icon in the toolbar (top right of the results) computes the collocations of the words surrounding the occurrences. "Jeune homme" is an extremely common expression in classical French literature, which is why "jeune" comes first.
Réponse : « jeune ». Depuis une concordance, une icône de la barre d'outils (en haut à droite des résultats) calcule les collocations des mots qui entourent les occurrences. « Jeune homme » est une expression extrêmement courante dans la littérature française classique, d'où la première place de « jeune ».
Still in Concordance, search this time for "femme", then find the GDEX function (Good Dictionary EXamples) and look at the sentences it offers. What does GDEX do?
Toujours dans Concordance, cherchez cette fois « femme », puis trouvez la fonction GDEX (Good Dictionary EXamples) et regardez les phrases qu'elle propose. Que fait GDEX ?
Show the solutionVoir la solution
GDEX is a Sketch Engine algorithm that automatically picks out good example sentences for a word: short enough to be readable, grammatically complete, representative of typical usage, without too many rare or technical words. It defines nothing and invents nothing: every sentence comes from the corpus.
For translation, GDEX helps you see how a word is used "naturally", and gives examples to quote or to imitate. The order of the sentences it offers can vary from one session to another.
GDEX est un algorithme de Sketch Engine qui repère automatiquement de bonnes phrases d'exemple pour un mot : assez courtes pour être lisibles, grammaticalement complètes, représentatives de l'usage typique, sans trop de mots rares ou techniques. Il ne définit rien et n'invente rien : toutes les phrases viennent du corpus.
Pour la traduction, GDEX aide à voir comment un mot s'utilise « naturellement » et fournit des exemples à citer ou à imiter. L'ordre des phrases proposées peut varier d'une session à l'autre.
Search for the word "canada" (simple search) in Concordance, then display the distribution of that word across the corpus: does it turn up more or less everywhere, or does it cluster in certain texts? Among the four distributions above, which one is that of "Canada"?
Cherchez le mot « canada » (recherche simple) dans Concordance, puis visualisez la distribution de ce mot dans le corpus : apparaît-il un peu partout, ou se concentre-t-il dans certains textes ? Parmi les quatre distributions ci-dessus, laquelle est celle de « Canada » ?
Show the solutionVoir la solution
The distribution of "Canada" is distribution A: heavily concentrated in a few texts that talk about Canada specifically. (The other three are those of "Belgique", "France" and "Suisse" in the same corpus.)
Why it matters: a very concentrated distribution warns you that the frequency of a word may be inflated by a handful of texts. Reliable analysis wants occurrences spread over several texts; the distribution also helps tell "general" words from "thematic" ones. Compare with "France", spread far more evenly across this French literature.
La distribution de « Canada » est la distribution A : très concentrée dans quelques textes qui parlent spécifiquement du Canada. (Les autres distributions sont celles de « Belgique », « France » et « Suisse » dans le même corpus.)
Pourquoi c'est important : une distribution très concentrée signale que la fréquence d'un mot peut être gonflée par une poignée de textes. Pour une analyse fiable, mieux vaut des occurrences réparties dans plusieurs textes ; la distribution aide aussi à distinguer les mots « généraux » des mots « thématiques ». Comparez avec « France », répartie beaucoup plus uniformément dans cette littérature française.
Sources
Bowker, L., & Pearson, J. (2002). Working with Specialized Language: A Practical Guide to Using Corpora. Routledge. https://doi.org/10.4324/9780203469255
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Word Sketch and Word Sketch DifferenceWord Sketch et Word Sketch Difference
The Word Sketch function, which gives the tool its name, shows the typical
collocations of a word grouped by grammatical relation: which verbs take it
as a subject or an object, which adjectives modify it, which prepositions go
with it (Kilgarriff et al., 2014).
The Word Sketch Difference function compares two close words (“regarder”
and “voir”, “dire” and “répondre”): it lists the collocates specific to one,
to the other, and those they share. Its visualization spreads the collocates
between the two words, each one placed according to the word it goes with
more often.
Figure 41. Word Sketch Difference between 'homme' and 'femme'. The layout is partly random, so the same query does not draw the same picture twice.
Four exercises, still on the Gutenberg corpus. The first two work from the
table rather than from that visualization, because the table comes out the
same every time. It shows the “sans” relation, the count with “homme” in the
first column and with “femme” in the second, and the row at each end is
masked.
Figure 42. The 'sans' relation for 'homme' against 'femme': each row gives the count with 'homme', then with 'femme'. The row at each end is masked.
ExerciseExercice 10 · the noun most characteristic of "homme"le nom le plus caractéristique de « homme »not startedà fairesolvedréussikeep tryingà retravailler
Reproduce this table in Word Sketch Difference: "homme" (man) against "femme" (woman), on the "sans" (without) relation, in the table rather than the visualization. Which noun fills the top row, the one most characteristic of "homme", with 25 occurrences against 0?
Reproduisez ce tableau dans Word Sketch Difference : « homme » contre « femme », relation « sans », dans le tableau et non dans la visualisation. Quel nom occupe la ligne du haut, la plus caractéristique de « homme » (25 occurrences avec « homme », 0 avec « femme ») ?
Show the explanationVoir l'explication
Answer: "arme", weapon. In this corpus a man is sans arme, unarmed, 25 times, and a woman never. The row sits at the very top because the word goes to "homme" and to "homme" alone.
Réponse : « arme ». Dans ce corpus, un homme est « sans arme » 25 fois, une femme jamais. La ligne est tout en haut parce que le mot va à « homme » et à lui seul.
ExerciseExercice 11 · the noun most characteristic of "femme"le nom le plus caractéristique de « femme »not startedà fairesolvedréussikeep tryingà retravailler
Same table, bottom row: which noun is most characteristic of "femme", with 0 occurrences against 10?
Même tableau, ligne du bas : quel nom est le plus caractéristique de « femme » (0 occurrence avec « homme », 10 avec « femme ») ?
Show the explanationVoir l'explication
Answer: "mari", husband. A woman is sans mari 10 times and a man never: the literature in this corpus defines women by an absence that men do not have.
The trap in both exercises: most characteristic is not most frequent. "Sans foi" (without faith, 46 occurrences with "homme") and "sans cœur" (heartless, 35 with "femme") are far more frequent, but the two words share them, which is why they stay in the middle of the table. Word Sketch Difference ranks the gap between the two profiles, not the raw count.
Réponse : « mari ». Une femme est « sans mari » 10 fois, un homme jamais : la littérature du corpus définit les femmes par une absence que les hommes n'ont pas.
Le piège des deux exercices : le plus caractéristique n'est pas le plus fréquent. « Sans foi » (46 occurrences avec « homme ») et « sans cœur » (35 avec « femme ») sont bien plus fréquents, mais les deux mots se les partagent, et ils restent donc au milieu du tableau. Word Sketch Difference classe l'écart entre les deux profils, pas le compte brut.
Then the full profile of a single word. Sketch Engine can draw it as a wheel,
one sector per grammatical relation, which shows at a glance which relations
carry the most:
Figure 43. The Word Sketch of 'cheval' drawn as a wheel, one sector per grammatical relation. The top preposition is masked.
ExerciseExercice 12 · the preposition ranked first for "cheval"la préposition en tête pour « cheval »not startedà fairesolvedréussikeep tryingà retravailler
Search for "cheval" (horse) in Word Sketch and open the preposition relation, in the list rather than in the wheel. Which preposition does Sketch Engine put at the top?
Cherchez « cheval » dans Word Sketch et ouvrez la relation des prépositions, dans la liste plutôt que dans la roue. Quelle préposition Sketch Engine place-t-il en tête ?
Show the explanationVoir l'explication
Answer: "sur", in "sur un cheval" (on a horse). It is also the preposition masked in the wheel above.
Be careful about what that ranking means: a Word Sketch list is ordered by salience, meaning the strength of the link between the two words, and not by number of occurrences.
Réponse : « sur », dans « sur un cheval ». C'est aussi la préposition masquée dans la roue ci-dessus.
Attention à ce que ce classement veut dire : une liste de Word Sketch est ordonnée par saillance, c'est-à-dire par la force du lien entre les deux mots, et non par nombre d'occurrences.
ExerciseExercice 13 · the phrasing that is actually more frequentla tournure réellement la plus fréquentenot startedà fairesolvedréussikeep tryingà retravailler
From that relation, click each of the two lines to open its concordance. The blue banner above the results gives the number of occurrences. Which of the two is actually more frequent, "sur un cheval" (on a horse) or "à cheval" (on horseback)? Answer with the preposition alone.
Depuis cette relation, cliquez sur chacune des deux lignes pour ouvrir la concordance correspondante. Le bandeau bleu au-dessus des résultats donne le nombre d'occurrences. Laquelle des deux tournures est réellement la plus fréquente, « sur un cheval » ou « à cheval » ? Répondez par la préposition seule.
Show the explanationVoir l'explication
Answer: "à". "À cheval" has 11,709 occurrences against 2,333 for "sur un cheval", which is 49.89 per million tokens against 9.94. The phrasing the Word Sketch puts at the top is five times rarer than the other one.
The score that orders a Word Sketch measures the strength of the association rather than the volume: it weighs the number of co-occurrences against how frequent each word is on its own. "À" is a very common preposition in French, so finding it near "cheval" is barely surprising; "sur" is much less common, so the link counts for more. The two measures answer two different questions, and a ranking is not a substitute for a count.
Meaning plays a part too: à cheval is a fixed expression about how someone travels, which makes it very common, while sur un cheval describes a position and is built case by case.
Réponse : « à ». « À cheval » compte 11 709 occurrences contre 2 333 pour « sur un cheval », soit 49,89 par million de tokens contre 9,94. La tournure que le Word Sketch place en tête est donc cinq fois moins fréquente que l'autre.
Le score qui ordonne un Word Sketch mesure la force de l'association et non le volume : il met en regard le nombre de cooccurrences et la fréquence de chaque mot pris à part. « À » est une préposition très courante en français, donc la trouver près de « cheval » surprend peu ; « sur » l'est beaucoup moins, et le lien pèse donc plus lourd. Les deux mesures répondent à deux questions différentes, et un classement ne remplace pas un comptage.
Le sens joue aussi : « à cheval » est une locution figée sur la manière de se déplacer, ce qui la rend très courante, tandis que « sur un cheval » décrit une position et se construit au cas par cas.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
La fonction Word Sketch, qui donne son nom à l’outil, visualise les
collocations typiques d’un mot regroupées par relation grammaticale : quels
verbes le prennent pour sujet ou pour objet, quels adjectifs le modifient,
quelles prépositions l’accompagnent (Kilgarriff et al., 2014).
La fonction Word Sketch Difference compare deux mots proches (« regarder »
et « voir », « dire » et « répondre ») : elle liste les collocatifs
spécifiques à l’un, à l’autre, et ceux qu’ils partagent. Sa visualisation
répartit les collocatifs entre les deux mots, chacun placé selon celui avec
lequel il apparaît le plus souvent.
Figure 41. Word Sketch Difference entre « homme » et « femme ». La disposition est en partie aléatoire : la même requête ne dessine pas deux fois la même image.
Quatre exercices, toujours dans le corpus Gutenberg. Les deux premiers
travaillent à partir du tableau plutôt que de cette visualisation, parce que
le tableau sort identique à chaque fois. Il montre la relation « sans », le
compte avec « homme » dans la première colonne et avec « femme » dans la
seconde, et la ligne située à chaque extrémité est masquée.
Figure 42. La relation « sans » pour « homme » contre « femme » : chaque ligne donne le compte avec « homme », puis avec « femme ». La ligne située à chaque extrémité est masquée.
ExerciseExercice 10 · the noun most characteristic of "homme"le nom le plus caractéristique de « homme »not startedà fairesolvedréussikeep tryingà retravailler
Reproduce this table in Word Sketch Difference: "homme" (man) against "femme" (woman), on the "sans" (without) relation, in the table rather than the visualization. Which noun fills the top row, the one most characteristic of "homme", with 25 occurrences against 0?
Reproduisez ce tableau dans Word Sketch Difference : « homme » contre « femme », relation « sans », dans le tableau et non dans la visualisation. Quel nom occupe la ligne du haut, la plus caractéristique de « homme » (25 occurrences avec « homme », 0 avec « femme ») ?
Show the explanationVoir l'explication
Answer: "arme", weapon. In this corpus a man is sans arme, unarmed, 25 times, and a woman never. The row sits at the very top because the word goes to "homme" and to "homme" alone.
Réponse : « arme ». Dans ce corpus, un homme est « sans arme » 25 fois, une femme jamais. La ligne est tout en haut parce que le mot va à « homme » et à lui seul.
ExerciseExercice 11 · the noun most characteristic of "femme"le nom le plus caractéristique de « femme »not startedà fairesolvedréussikeep tryingà retravailler
Same table, bottom row: which noun is most characteristic of "femme", with 0 occurrences against 10?
Même tableau, ligne du bas : quel nom est le plus caractéristique de « femme » (0 occurrence avec « homme », 10 avec « femme ») ?
Show the explanationVoir l'explication
Answer: "mari", husband. A woman is sans mari 10 times and a man never: the literature in this corpus defines women by an absence that men do not have.
The trap in both exercises: most characteristic is not most frequent. "Sans foi" (without faith, 46 occurrences with "homme") and "sans cœur" (heartless, 35 with "femme") are far more frequent, but the two words share them, which is why they stay in the middle of the table. Word Sketch Difference ranks the gap between the two profiles, not the raw count.
Réponse : « mari ». Une femme est « sans mari » 10 fois, un homme jamais : la littérature du corpus définit les femmes par une absence que les hommes n'ont pas.
Le piège des deux exercices : le plus caractéristique n'est pas le plus fréquent. « Sans foi » (46 occurrences avec « homme ») et « sans cœur » (35 avec « femme ») sont bien plus fréquents, mais les deux mots se les partagent, et ils restent donc au milieu du tableau. Word Sketch Difference classe l'écart entre les deux profils, pas le compte brut.
Ensuite, le portrait complet d’un seul mot. Sketch Engine peut le dessiner en
roue, un secteur par relation grammaticale, ce qui montre d’un coup d’œil
quelles relations pèsent le plus :
Figure 43. Le Word Sketch de « cheval » dessiné en roue, un secteur par relation grammaticale. La première préposition est masquée.
ExerciseExercice 12 · the preposition ranked first for "cheval"la préposition en tête pour « cheval »not startedà fairesolvedréussikeep tryingà retravailler
Search for "cheval" (horse) in Word Sketch and open the preposition relation, in the list rather than in the wheel. Which preposition does Sketch Engine put at the top?
Cherchez « cheval » dans Word Sketch et ouvrez la relation des prépositions, dans la liste plutôt que dans la roue. Quelle préposition Sketch Engine place-t-il en tête ?
Show the explanationVoir l'explication
Answer: "sur", in "sur un cheval" (on a horse). It is also the preposition masked in the wheel above.
Be careful about what that ranking means: a Word Sketch list is ordered by salience, meaning the strength of the link between the two words, and not by number of occurrences.
Réponse : « sur », dans « sur un cheval ». C'est aussi la préposition masquée dans la roue ci-dessus.
Attention à ce que ce classement veut dire : une liste de Word Sketch est ordonnée par saillance, c'est-à-dire par la force du lien entre les deux mots, et non par nombre d'occurrences.
ExerciseExercice 13 · the phrasing that is actually more frequentla tournure réellement la plus fréquentenot startedà fairesolvedréussikeep tryingà retravailler
From that relation, click each of the two lines to open its concordance. The blue banner above the results gives the number of occurrences. Which of the two is actually more frequent, "sur un cheval" (on a horse) or "à cheval" (on horseback)? Answer with the preposition alone.
Depuis cette relation, cliquez sur chacune des deux lignes pour ouvrir la concordance correspondante. Le bandeau bleu au-dessus des résultats donne le nombre d'occurrences. Laquelle des deux tournures est réellement la plus fréquente, « sur un cheval » ou « à cheval » ? Répondez par la préposition seule.
Show the explanationVoir l'explication
Answer: "à". "À cheval" has 11,709 occurrences against 2,333 for "sur un cheval", which is 49.89 per million tokens against 9.94. The phrasing the Word Sketch puts at the top is five times rarer than the other one.
The score that orders a Word Sketch measures the strength of the association rather than the volume: it weighs the number of co-occurrences against how frequent each word is on its own. "À" is a very common preposition in French, so finding it near "cheval" is barely surprising; "sur" is much less common, so the link counts for more. The two measures answer two different questions, and a ranking is not a substitute for a count.
Meaning plays a part too: à cheval is a fixed expression about how someone travels, which makes it very common, while sur un cheval describes a position and is built case by case.
Réponse : « à ». « À cheval » compte 11 709 occurrences contre 2 333 pour « sur un cheval », soit 49,89 par million de tokens contre 9,94. La tournure que le Word Sketch place en tête est donc cinq fois moins fréquente que l'autre.
Le score qui ordonne un Word Sketch mesure la force de l'association et non le volume : il met en regard le nombre de cooccurrences et la fréquence de chaque mot pris à part. « À » est une préposition très courante en français, donc la trouver près de « cheval » surprend peu ; « sur » l'est beaucoup moins, et le lien pèse donc plus lourd. Les deux mesures répondent à deux questions différentes, et un classement ne remplace pas un comptage.
Le sens joue aussi : « à cheval » est une locution figée sur la manière de se déplacer, ce qui la rend très courante, tandis que « sur un cheval » décrit une position et se construit au cas par cas.
Sources
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: ten years on. Lexicography, 1(1), 7–36. https://doi.org/10.1007/s40607-014-0009-9