TRA2600 · Bloc 1 · TAO (séances 1 à 4, examen à la séance 6)TRA2600 · Bloc 1 · TAO (séances 1 à 4, examen à la séance 6)
Entre les séances · pour la séance 3 · mercredi 16 September 2026Entre les séances · pour la séance 3 · mercredi 16 septembre 2026
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
🔒 TRA2600 · The exchange formats readingTRA2600 · La lecture sur les formats d'échangeis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
TRA2600 · The exchange formats readingTRA2600 · La lecture sur les formats d'échange
Files, tools and markupFichiers, outils et balisage
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
Why interchange formats?Pourquoi des formats d'échange ?
Internal storage belongs to the tool and is optimized for it. A classic
local memory in memoQ, for instance, is a folder of files identified by an
.mtm file; Trados Studio keeps its own in an .sdltm file. These formats are
not meant to be read by other programs, and nothing obliges their vendor to
document them or to keep them stable from one version to the next.
A backup copies that internal storage. It protects you against a failure,
not against a change of tool.
An interchange export produces a file meant to leave the tool: TMX, TBX,
XLIFF. It is the only one of the three that crosses the boundary between
programs.A tool does sometimes read a competitor’s format directly:
memoQ imports Trados .sdltm files. That stays the exception, and it depends
on the vendor’s goodwill.
Without those exports, exchange would not be impossible, but it would happen
ad hoc, with a lot of copy-pasting and as much room for error or data loss. The
more complex the data, the more problematic such conversions become.
Imagine a very simple bilingual glossary in Excel, where each source term is
linked to exactly one target term: two terms per row. Easy enough. But we all
know that a glossary rarely stays that simple: you start adding synonyms,
cross-references, related terms, definitions, sources, example sentences. The
moment the data is more complex than a plain, consistent table with no links in
it, you can assume that sharing it becomes more difficult as well.
Producing the file is only half of the problem. The tool that receives it also
has to make sense of what is inside, and exchanging data that the other side can
actually use is what these formats are for. That property has a name.
A tool can claim support for TMX or XLIFF without reading them exactly the way
yours does, so what interoperability delivers in practice is a separate
question from what the standards define.
Le stockage interne appartient à l’outil et est optimisé pour lui. Une
mémoire locale classique de memoQ, par exemple, est un dossier de fichiers
repéré par un fichier .mtm ; Trados Studio range la sienne dans un fichier
.sdltm. Ces formats ne sont pas faits pour être lus par d’autres logiciels,
et rien n’oblige leur éditeur à les documenter ni à les garder stables d’une
version à l’autre.
La sauvegarde copie ce stockage interne. Elle vous protège d’une panne, pas
d’un changement d’outil.
L’export d’échange produit un fichier destiné à sortir de l’outil : TMX,
TBX, XLIFF. C’est le seul des trois qui traverse la frontière entre
logiciels.Il arrive qu’un outil lise directement le format d’un
concurrent : memoQ importe les fichiers .sdltm de Trados. Cela reste
l’exception, et cela dépend du bon vouloir de l’éditeur.
Sans ces exports, l’échange ne serait pas impossible, mais il se ferait au cas
par cas, avec beaucoup de copier-coller et autant d’occasions de se tromper ou
de perdre des données. Plus les données sont complexes, plus ces conversions
improvisées posent problème.
Imaginez un glossaire bilingue très simple dans Excel, où chaque terme source
correspond à exactement un terme cible : deux termes par ligne. Jusque-là, rien
de compliqué. Mais nous savons tous qu’un glossaire reste rarement aussi
simple : on y ajoute des synonymes, des renvois, des termes apparentés, des
définitions, des sources, des exemples d’emploi. Dès que les données dépassent
le tableau simple et régulier, sans liens internes, on peut supposer que leur
partage devient lui aussi plus difficile.
Produire le fichier ne règle que la moitié du problème. L’outil qui le reçoit
doit encore comprendre ce qu’il contient, et échanger des données que l’autre
côté peut réellement exploiter, c’est ce à quoi servent ces formats. Cette
propriété porte un nom.
Un outil peut annoncer qu’il prend en charge TMX ou XLIFF sans les lire
exactement comme le vôtre : ce que l’interopérabilité donne en pratique est
donc une autre question que ce que les normes définissent.
The sentence from our fictional client, Cascade Pumps Inc., as it travels in their XLIFF file:
<segment> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target></segment>
HTML
HTML is the other markup language you are certain to come across. Web pages are written
in it, so any web content that is not a PDF or an image reaches you as HTML. Unlike an XML format, it comes with its tag names already
fixed by its standard.
Here is the same sentence as it exists on the client’s website:
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p><img src="pump-diagram.png" alt="Cutaway view of a centrifugal pump">
Three things to notice:
<p> marks a paragraph and <strong> an emphasis. Those names come from the
HTML standard; you do not choose them.
The text to translate is the text between the tags.
Some of it is inside a tag: alt gives the description of the image,
read by people who cannot see it. src, which names the image file, is not
translated.
La phrase de notre client fictif, Cascade Pumps Inc., telle qu’elle voyage dans
son fichier XLIFF :
<segment> <source>Install the centrifugal pump on a level surface.</source> <target>Installez la pompe centrifuge sur une surface plane.</target></segment>
HTML
HTML est l’autre langage de balisage que vous rencontrerez à coup sûr. Les pages
web sont écrites en HTML ; tout contenu web qui n’est ni un PDF ni une image vous
arrive donc sous cette forme. Contrairement à un
format XML, ses noms de balises sont déjà fixés par sa norme.
Voici la même phrase telle qu’elle existe sur le site web du client :
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p><img src="pump-diagram.png" alt="Cutaway view of a centrifugal pump">
Trois choses à remarquer :
<p> marque un paragraphe et <strong> une mise en relief. Ces noms
viennent de la norme HTML ; vous ne les choisissez pas.
Le texte à traduire est celui qui se trouve entre les balises.
Du texte à traduire se trouve aussi dans une balise : alt porte la
description de l’image, lue par les personnes qui ne la voient pas. src,
qui nomme le fichier image, ne se traduit pas.
Plain text and its linesLe texte brut et ses lignes
Any editor opens it
You can open a TMX, XLIFF or HTML file in Notepad (Windows) or TextEdit (Mac)
and see how it is put together. No specialized software is needed, because
there is nothing in the file to decode: characters, one after another.
A line break is a character
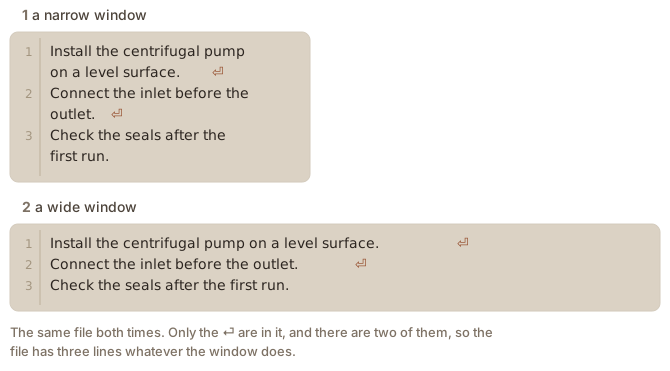
Among those characters is the one that ends a line. You never see it, but it is
in the file like any other, and it is what divides the file into lines. A file
with two of them has three lines, whatever it looks like on screen.
Word processors give you a way to see them: the button usually marked ¶, which
displays the invisible characters on screen, paragraph marks and line breaks
along with spaces and tabs. It changes nothing in the file. It only stops hiding
what is already in it.
Word wrap writes nothing
When a line is too long for the window, an editor breaks it so you can read it
without scrolling sideways. That break is drawn, not written: the same file
wraps differently in a narrower window, in another editor, or at a larger font
size, and none of that changes the file.
Figure 1. A narrow window and a wide one, showing the same file. The rows move, the line breaks do not.
The two get confused because both look like a new line. The difference shows the
moment you count something:
Line numbers. An editor numbers the lines in the file, not the rows on
screen, so line 2 can occupy four rows.
One record per line. A CSV or TSV file normally puts one record on each
line. A record that wraps on screen is still one record, and a stray line
break inside one splits it in two, unless the field it falls in is quoted.
XML. A file that arrives on one very long line is intact, which is why
what an XML file looks like says the
indentation is a convention rather than a requirement.
N’importe quel éditeur l’ouvre
Vous pouvez ouvrir un fichier TMX, XLIFF ou HTML dans le Bloc-notes (Windows) ou
TextEdit (Mac) et voir comment il est construit. Aucun logiciel spécialisé n’est
nécessaire, parce qu’il n’y a rien à décoder dans le fichier : des caractères,
les uns après les autres.
Le saut de ligne est un caractère
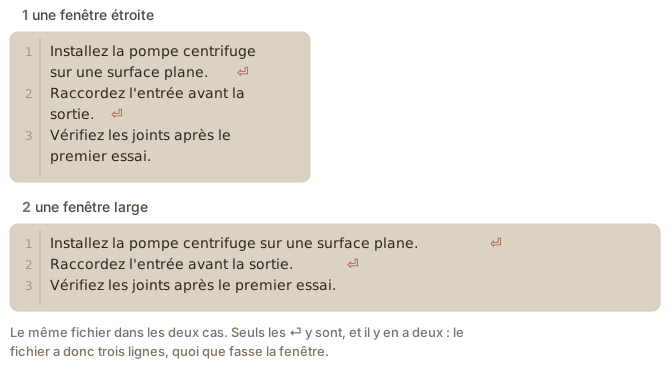
Parmi ces caractères, il y en a un qui termine la ligne. Vous ne le voyez jamais,
mais il est dans le fichier comme les autres, et c’est lui qui découpe le fichier
en lignes. Un fichier qui en compte deux a trois lignes, quelle que soit son
allure à l’écran.
Les traitements de texte offrent un moyen de les voir : le bouton marqué 
d’ordinaire, qui affiche à l’écran les caractères invisibles, marques de
paragraphe et sauts de ligne, mais aussi espaces et tabulations. Il ne change
rien au fichier. Il cesse seulement de cacher ce qui s’y trouve déjà.
Le retour à la ligne automatique n’écrit rien
Quand une ligne est trop longue pour la fenêtre, l’éditeur la coupe pour vous
éviter de défiler latéralement. Cette coupure est dessinée, pas écrite : le même
fichier se replie autrement dans une fenêtre plus étroite, dans un autre éditeur
ou avec une police plus grande, et rien de tout cela ne change le fichier.
Figure 1. Une fenêtre étroite et une fenêtre large, pour le même fichier. Les rangées bougent, les sauts de ligne restent.
On confond les deux parce que l’une comme l’autre ressemble à une nouvelle ligne.
La différence apparaît dès qu’il faut compter :
Les numéros de ligne. L’éditeur numérote les lignes du fichier, pas les
rangées à l’écran : la ligne 2 peut donc occuper quatre rangées.
Un enregistrement par ligne. Un fichier CSV ou TSV place normalement un
enregistrement par ligne. Un enregistrement qui se replie à l’écran reste un
seul enregistrement, et un saut de ligne égaré à l’intérieur le coupe en deux,
sauf si le champ où il tombe est entre guillemets.
XML. Un fichier qui arrive sur une seule très longue ligne est intact,
et c’est pourquoi à quoi ressemble le XML
présente l’indentation comme une convention et non comme une obligation.
Reading XMLLire du XML
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
What XML looks likeÀ quoi ressemble le XML
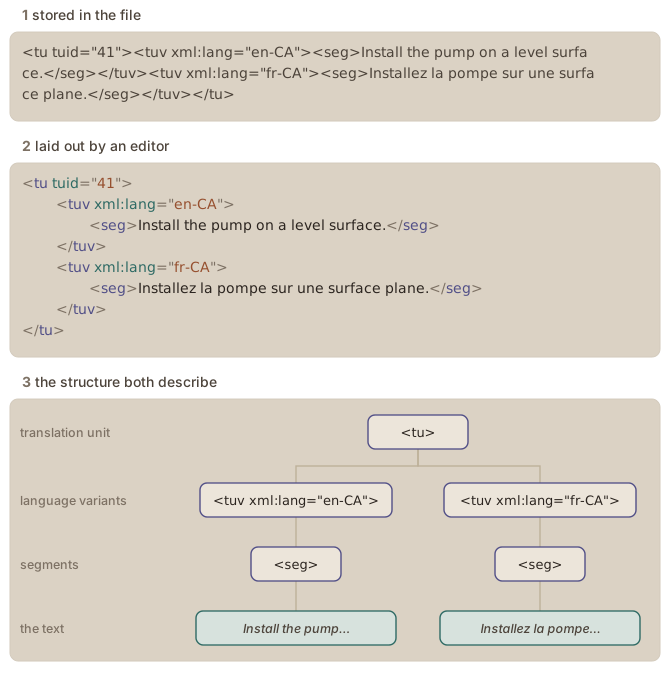
Figure 1. One document, three views: what is in the file, how an editor shows it, and the structure behind both.
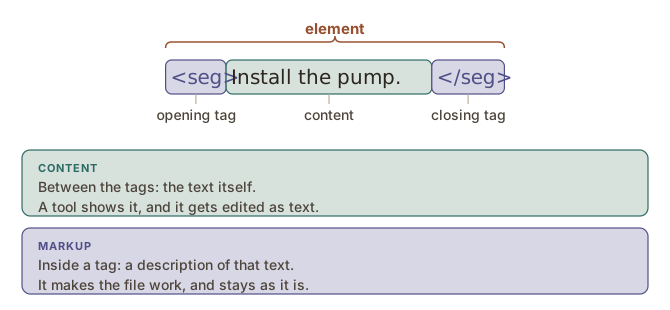
That structure is made of elements and tags, of the attributes attached to
them, and of the hierarchy they build.Every
example in this chapter is an excerpt. A complete XML file opens with a
declaration, <?xml version="1.0" encoding="UTF-8"?>, taken up on the encoding
page.
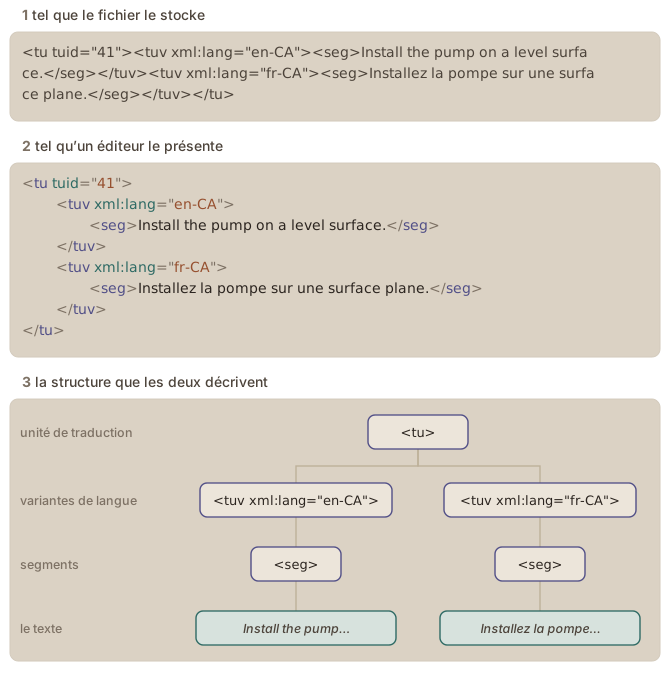
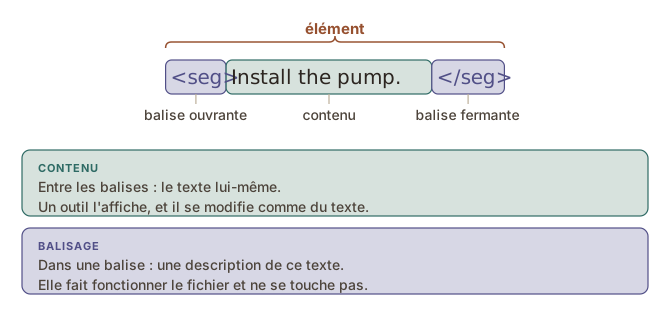
Cette structure est faite d’éléments et de balises, des attributs qu’ils
portent, et de la hiérarchie qu’ils construisent.Tous les exemples de ce chapitre sont des extraits. Un
fichier XML complet s’ouvre par une déclaration, <?xml version="1.0" encoding="UTF-8"?>, reprise à la page sur le codage.
Elements nest inside one another and form a tree: each element can contain
other elements, its children.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
Les éléments s’imbriquent les uns dans les autres et forment un arbre : chaque
élément peut contenir d’autres éléments, ses enfants.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
Plain text and its lines said a
file is characters and nothing else. That is true of what the file means; what
it stores is bytes, and an encoding is the agreement that turns one back into
the other. If the agreement is wrong, the letters come
back wrong, which is why this is the problem French text hits first.
The declaration says which one
The very first line of an XML file is its declaration:
<?xml version="1.0" encoding="UTF-8"?>
encoding names the agreement the file was written under. UTF-8 covers accents,
non-Latin alphabets and almost everything else, and it is what TMX, TBX and
XLIFF use.Some programs, Windows ones above all, start a UTF-8 file
with three invisible bytes announcing the encoding, called a byte order mark or
BOM. Most tools take it in their stride, but one that does not will show it as
 in front of the first character, or trip over a first line that looks
perfectly normal on screen. If a file misbehaves only on its first line, this is
usually why, and a text editor that offers to save “UTF-8 without BOM” is
offering the fix.
When it goes wrong
An accented letter is where the trouble shows, because in UTF-8 it takes two
bytes rather than one. Written as UTF-8 and read as if it were an older
one-byte encoding, “é” arrives as two letters instead:
A whole file of that is the classic symptom: every accent has turned into two
characters, and nothing else has moved. It means the file was written under one
agreement and read under another, not that the text was damaged, so opening it
again with the right encoding usually brings it back.The other
direction is uglier. In a one-byte file opened as UTF-8, the accented bytes make
no valid character at all, so they come back as �. Save the file in that state
and the original letter is gone for good.
Le texte brut et ses lignes
disait qu’un fichier est fait de caractères et de rien d’autre. C’est vrai de ce
que le fichier signifie ; ce qu’il stocke, ce sont des
octets, et le codage est la convention qui fait passer des uns aux autres.
Si la convention est fausse, les lettres reviennent fausses, et c’est pourquoi
le texte français rencontre ce problème avant tout autre.
La déclaration dit laquelle
La toute première ligne d’un fichier XML est sa déclaration :
<?xml version="1.0" encoding="UTF-8"?>
encoding nomme la convention selon laquelle le fichier a été écrit. UTF-8
couvre les accents, les alphabets non latins et à peu près tout le reste, et
c’est ce qu’emploient TMX, TBX et XLIFF.Certains logiciels, ceux de
Windows au premier chef, font commencer un fichier UTF-8 par trois octets
invisibles qui annoncent le codage, ce qu’on appelle une marque d’ordre des
octets, ou BOM (byte order mark). La plupart des outils s’en accommodent, mais
celui qui ne le fait pas l’affiche sous la forme  devant le premier
caractère, ou bute sur une première ligne qui semble pourtant normale à l’écran.
Quand un fichier ne pose problème que sur sa première ligne, c’est en général
cela, et un éditeur de texte qui propose d’enregistrer en « UTF-8 sans BOM »
propose la solution.
Quand cela tourne mal
C’est sur les lettres accentuées que l’ennui se voit, parce qu’en UTF-8 elles
occupent deux octets au lieu d’un. Écrit en UTF-8 puis relu comme s’il
s’agissait d’un ancien codage à un octet, le « é » arrive sous la forme de deux
lettres :
Un fichier entier dans cet état, c’est le symptôme classique : chaque accent
s’est transformé en deux caractères, et rien d’autre n’a bougé. Cela veut dire
que le fichier a été écrit selon une convention et relu selon une autre, non
que le texte a été abîmé : le rouvrir avec le bon codage le rétablit
généralement.L’autre sens est plus vilain. Dans un fichier à un octet relu
en UTF-8, les octets accentués ne forment aucun caractère valide : ils
reviennent sous la forme de �. Enregistrez le fichier dans cet état et la
lettre d’origine est perdue pour de bon.
What to translate, what to leaveCe qui se traduit, ce qui ne se touche pas
The same sentence in two languages
Back to the sentence from the guide of our fictional client, Cascade Pumps Inc.:
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
In French:
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
The text changed, the structure did not. The tags are the same and there are as
many of them, and <strong> followed the term it emphasizes, which no longer
comes at the same place in the sentence.
Reprenons la phrase du guide de notre client fictif, Cascade Pumps Inc. :
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
En français :
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
Le texte a changé, la structure non. Les balises sont les mêmes et en même
nombre, et <strong> a suivi le terme qu’il met en relief, lequel n’occupe
plus la même place dans la phrase.
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
The three formats side by sideLes trois formats côte à côte
ISO (2019). ISO 30042:2019. Management of terminology resources — TermBase eXchange (TBX). International Organization for Standardization. https://www.iso.org/standard/62510.html
ISO (2024). ISO 21720:2024. XLIFF (XML Localization Interchange File Format) — Version 2.1. International Organization for Standardization. https://www.iso.org/standard/87344.html