Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
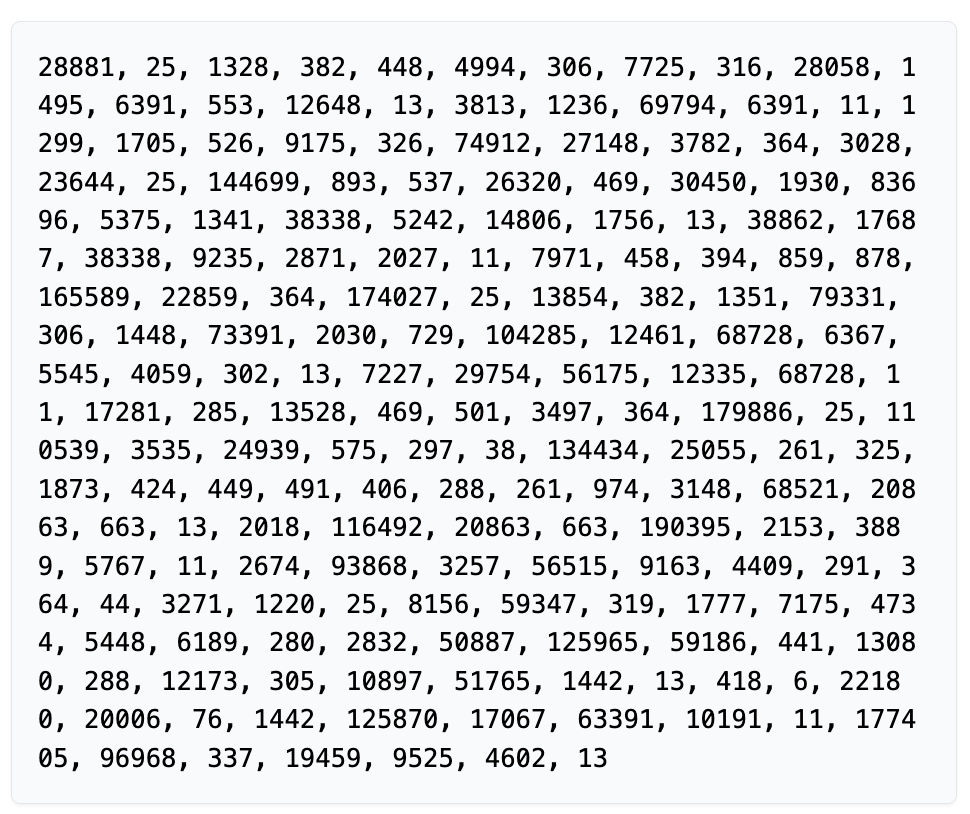
Figure 1. The same sentence read three ways. The token split and IDs are the real output of OpenAI's o200k_base tokenizer (checked 29 August 2026).
The live demonstration goes here, and it needs a model open in front of the
room rather than a slide: ask one to spell a word backwards, or to count
the letters of a rare word, and show the same word split in Tiktokenizer
beside it. Two warnings from the writing of this chapter. First, the famous
strawberry question is patched in current models and will probably answer
correctly, so pick a rarer word, or a task that manipulates the letters
rather than reciting them. Second, whatever the answer, the point is not
that the model is bad at counting: it is that the letters were never
separate units it received. If a run produces something worth keeping, paste
the transcript into the chapter and date it.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. From your sentence to the vectors the model works on. The split shown is real o200k_base output (tiktokenizer.vercel.app, checked 29 August 2026).
Spaces belong to the word that follows
The spaces are inside the tokens. In this tokenizer a space belongs to the word
that follows it, which is why two of the boxes carry one and the first does
not. The same word is therefore a different token at the start of a line and in
the middle of a sentence, and a text already cut on its spaces is counted
differently.
Every model has a fixed list of tokens, chosen before training starts and never
added to afterwards. Every text it will ever read or write has to be expressed
using the tokens in that list, and whatever is not in the list cannot be
represented at all.
How long that list should be is the question this page turns on, and the two
obvious answers sit at either end.
Figure 3. The two obvious answers, and what is wrong with each. Image generated withImage générée avec Gemini.
One number per word?
Each token would then be a unit that means something. But a list of words runs
into three walls at once.
Rare entries stay poorly learned. A word seen a handful of times in
training gets a vector built from those few occurrences, which is not enough
to place it usefully. Enlarging the list adds entries of exactly that kind.
Every entry costs. The model keeps one row of numbers per entry, and at
every step it scores every entry in the list to decide what comes next. A
longer list means more memory and more computing, for entries that are
mostly rare.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 4. A vocabulary of whole words: a vector is learned for each word the text contained, and none for the word it never contained.
One number per character?
The list would be tiny, a few hundred entries at most, and nothing would ever
be missing: any text at all can be spelled out, in any language, typos
included. The cost is at the other end. A single character tells you almost
nothing, t on its own means nothing, and a page of text becomes a very
long run of them, as the character row of
Figure 1figure 1 shows.
The model would have to rebuild every word from scratch, every time one occurred.
Pieces in between
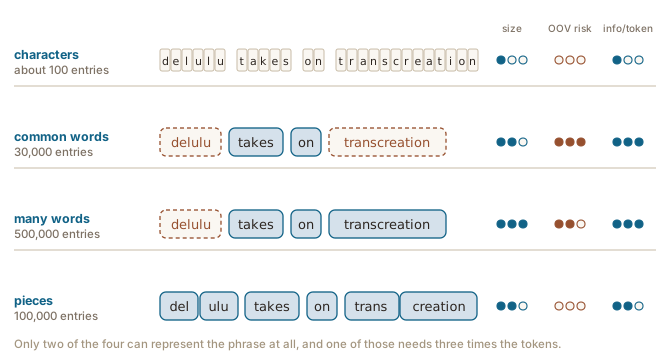
New words are mostly made of familiar pieces, and that is the way out. You can
read antibacterial without having seen it before, because anti-, bacteri
and -al are old acquaintances. A vocabulary of pieces, some of them whole
words and some fragments, keeps the common words whole and can still spell out
anything at all, down to single characters in the worst case.
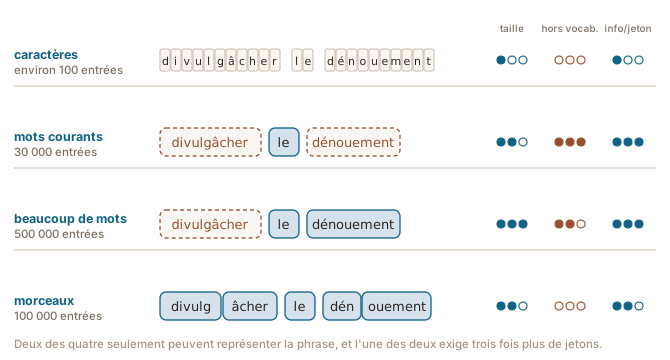
Figure 5. The same phrase represented with four different types of vocabulary, rated for the size of the list, the risk of a word falling outside it, and how much a single token tells you.
Split the whole corpus into single characters. These are the first
tokens.
Count every pair of adjacent tokens, and merge the most frequent pair
into one new token, everywhere it occurs.
Repeat step 2 until the vocabulary reaches the size you chose.
Learned once, applied forever
Frequent words quickly get their own token (the is one of the first) and
rarer ones stay in a few pieces. Length counts as well as frequency: every
merge joins two neighbours, so a long word needs many of them before it is
whole again, and a short word of the same frequency gets there sooner.
Frequent endings and stems, -ing, -tion, get a token too, because they
recur across thousands of words.
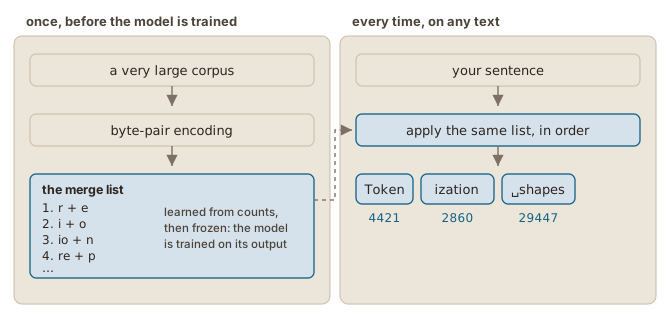
The counting happens once and produces a list of merges. That
list is then applied unchanged to every text the model ever reads, including
yours.
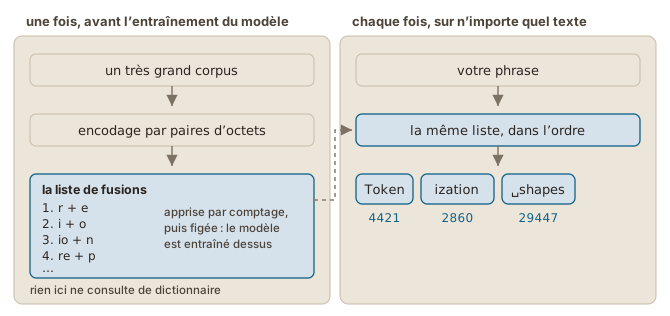
Figure 6. Byte-pair encoding runs twice over in two different senses: once as learning, on a corpus, and then as a lookup applied unchanged to everything the model reads.
Byte-pair encoding
Counting pairs, one merge at a time
Here the whole training corpus is three words: representation, retention,
repression. Three steps by hand are enough to see what kind of vocabulary
comes out.
Start by splitting everything into characters, nine distinct ones in all:
r e p r e s e n t a t i o nr e t e n t i o nr e p r e s s i o n
Count adjacent pairs. The pair r e occurs five times (twice in
representation, once in retention, twice in repression), more than any
other, so it becomes the first new token:
re p re s e n t a t i o nre t e n t i o nre p re s s i o n
Recounting and merging seven more times, io then ion, then the three
merges that build repres and the two that make ent, leaves a corpus in
which no pair occurs more than once:
repres ent a t ionre t ent ionrepres s ion
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 7. Every merge is chosen by one number, the count of the pair. No step consults a dictionary or a morphological analysis.
Morphemes by accident
Seven tokens (repres, ent, a, t, ion, re, s) now cover all three
words. Counting pairs and nothing else found ion and ent, real English
morphemes, and repres, a shared stem. It also produced
repres·ent·a·t·ion, which no linguist would propose as a morphological
analysis of representation.
Run the first merge with the room before showing the trace: three words on
the board, count the pairs, find that r + e wins with five. Then the
figure does the rest. The two things to draw out at the end: ion and
ent are real morphemes nobody told it about, and repres·ent·a·t·ion is
not a morphological analysis anyone would defend.
Paste and look
Any text pasted into a tokenizer comes back split, token by token.
The two screenshots below were taken on 8 September 2026 with GPT-4o selected, and
cropped to the panels that matter. Both the interface and the splits change, so
what you see today may not match them.
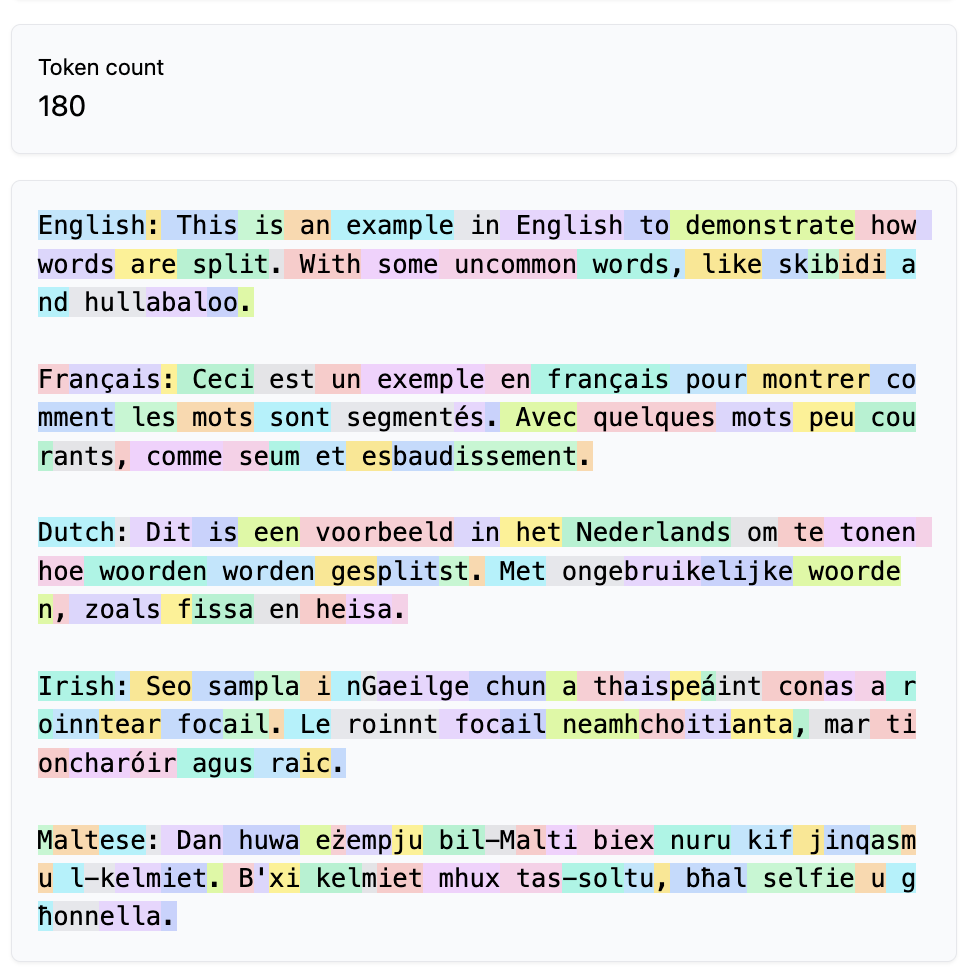
Figure 8. One paste, five languages, 180 tokens on GPT-4o. English runs almost word by word; the further down the list, the more the colours cut inside words. Figure 9. The same five paragraphs as the model receives them. The colours above are for you; this is the input.
What you should see
Common English words are one token each, because the merges that build
them ran often enough.
Rare words and typos shatter.Tokenization itself comes out in two or
three pieces, and htis in more.
Other languages cost more tokens for the same sentence, and the further
a language is from the training text, the more it costs.
One vocabulary per model
The vocabulary behind the splitting is a design decision, and it has grown.
GPT-2 worked with 50,257 tokens (Radford et al., 2019); the tokenizers OpenAI
has released since, in its open
tiktoken library, reach roughly 200,000.
Much of that growth went to non-English text: a recent tokenizer keeps whole
many French and Dutch words an older one fragmented. The differences between
languages shrink without disappearing, and they can be
measured (see also the Consequences of tokenization chapter) (voir aussi le chapitre Conséquences de la jetonisation).
Tiktokenizer offers a choice of models, and the most recent OpenAI one it
lists is GPT-4o. That is the tool lagging rather than anything withheld:
tiktoken maps GPT-5 to the same vocabulary as GPT-4o, so the split above is
the current one. Other companies are less open about this than OpenAI.
Anthropic publishes no tokenizer for Claude, only an
endpoint
that reports how many tokens a text costs, so for those models the count can
be checked and the cuts cannot be seen.
Tiktokenizer live, and let the room supply the text: an English sentence,
the same sentence in French, then a surname. The French cost is the result
that matters for this course, and it is measured properly in the
consequences chapter, read for séance 3.
Pas des mots, mais des jetons
Tout ce qui précède a dit mot : un vecteur par mot, de l’attention entre les
mots. C’est une simplification.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 1. La même phrase lue de trois façons. Le découpage en jetons et les identifiants sont la sortie réelle du segmenteur o200k_base d'OpenAI (vérifiée le 29 août 2026).
La démonstration en direct va ici, et il faut un modèle ouvert devant le
groupe plutôt qu’une diapositive : demander d’épeler un mot à l’envers, ou de
compter les lettres d’un mot rare, et montrer le même mot découpé dans
Tiktokenizer à côté. Deux avertissements issus de l’écriture de ce
chapitre. D’abord, la fameuse question de strawberry est corrigée dans les
modèles actuels et recevra probablement la bonne réponse : prendre un mot
plus rare, ou une tâche qui manipule les lettres plutôt que de les réciter.
Ensuite, quelle que soit la réponse, le point n’est pas que le modèle compte
mal : c’est que les lettres n’ont jamais été des unités distinctes qu’il ait
reçues. Si un essai donne quelque chose à garder, coller la transcription
dans le chapitre et la dater.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. De votre phrase aux vecteurs sur lesquels le modèle travaille. Le découpage montré est la sortie réelle d'o200k_base (tiktokenizer.vercel.app, vérifiée le 29 août 2026).
Les espaces appartiennent au mot qui suit
Les espaces sont à l’intérieur des jetons. Dans ce segmenteur, une espace
appartient au mot qui la suit, ce qui explique que deux des cases en portent
une et que la première n’en porte pas. Un même mot est donc un jeton différent
au début d’une ligne et au milieu d’une phrase, et un texte déjà découpé sur
ses espaces se compte autrement.
Chaque modèle a une liste fixe de jetons, choisie avant le début de
l’entraînement et jamais complétée ensuite. Tout texte qu’il lira ou écrira
doit s’exprimer avec les jetons de cette liste, et ce qui n’y figure pas ne
peut pas être représenté du tout.
Quelle doit être la longueur de cette liste ? C’est la question qui occupe cette
page, et les deux réponses évidentes se trouvent aux deux extrémités.
Figure 3. Les deux réponses évidentes, étiquetées en anglais, et ce qui ne va pas avec chacune. Image generated withImage générée avec Gemini.
Un numéro par mot ?
Chaque jeton serait alors une unité qui veut dire quelque chose. Mais une liste
de mots se heurte à trois murs à la fois.
Les entrées rares restent mal apprises. Un mot vu une poignée de fois à
l’entraînement reçoit un vecteur construit sur ces quelques occurrences, ce
qui ne suffit pas à le placer utilement. Agrandir la liste ajoute des entrées
exactement de ce genre.
Chaque entrée coûte. Le modèle garde une rangée de nombres par entrée,
et à chaque étape il attribue un score à chaque entrée de la liste pour
décider de la suite. Une liste plus longue veut dire plus de mémoire et plus
de calcul, pour des entrées le plus souvent rares.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 4. Un vocabulaire de mots entiers : un vecteur est appris pour chaque mot que le texte contenait, et aucun pour le mot qu'il n'a jamais contenu.
Un numéro par caractère ?
La liste serait minuscule, quelques centaines d’entrées au plus, et rien ne
manquerait jamais : n’importe quel texte peut s’épeler, dans n’importe quelle
langue, coquilles comprises. Le coût est à l’autre bout. Un caractère isolé ne
dit presque rien, t tout seul ne veut rien dire, et une page de texte devient
une très longue suite de caractères, comme le montre la rangée des caractères
de la
Figure 1figure 1. Le
modèle devrait reconstruire chaque mot depuis le début, chaque fois qu’il en
rencontre un.
Des morceaux entre les deux
Les mots nouveaux sont surtout faits de morceaux familiers, et c’est là que se trouve
l’issue. Vous pouvez lire antibactérien sans l’avoir jamais vu, parce que
anti-, bactér et -ien sont de vieilles connaissances. Un vocabulaire de
morceaux, dont certains sont des mots entiers et d’autres des fragments, garde
les mots courants entiers et peut malgré tout épeler n’importe quoi, jusqu’aux caractères
isolés dans le pire des cas.
Figure 5. La même expression représentée avec quatre types de vocabulaire différents, évalués selon la taille de la liste, le risque qu'un mot en sorte, et ce que dit un seul jeton.
Découper tout le corpus en caractères isolés. Ce sont les premiers jetons.
Compter chaque paire de jetons voisins, et fusionner la paire la plus
fréquente en un nouveau jeton, partout où elle apparaît.
Répéter l’étape 2 jusqu’à ce que le vocabulaire atteigne la taille choisie.
Appris une fois, appliqué pour toujours
Les mots fréquents obtiennent vite leur propre jeton (le est l’un des
premiers) et les plus rares restent en quelques morceaux. La longueur compte
aussi, en plus de la fréquence : chaque fusion joint deux voisins, un long mot a donc
besoin de nombreuses fusions avant d’être entier de nouveau, et un mot court de
même fréquence y arrive plus tôt. Les terminaisons et les radicaux fréquents,
-ion, -ment, obtiennent aussi un jeton, parce qu’ils reviennent dans des
milliers de mots.
Le comptage n’a lieu qu’une fois et produit une liste de fusions. Cette liste
est ensuite appliquée sans changement à tous les textes que le modèle lira, y
compris les vôtres.
Figure 6. L'encodage par paires d'octets tourne deux fois en deux sens différents : une fois comme apprentissage, sur un corpus, puis comme consultation appliquée sans changement à tout ce que le modèle lit.
L'encodage par paires d'octets
Compter les paires, une fusion à la fois
Ici, tout le corpus d’entraînement tient en trois mots : representation,
retention, repression. Trois étapes à la main suffisent à voir quel genre
de vocabulaire en sort.
On commence par tout découper en caractères, neuf caractères distincts en
tout :
r e p r e s e n t a t i o nr e t e n t i o nr e p r e s s i o n
On compte les paires voisines. La paire r e apparaît cinq fois (deux fois
dans representation, une fois dans retention, deux fois dans
repression), plus que toute autre ; elle devient donc le premier nouveau
jeton :
re p re s e n t a t i o nre t e n t i o nre p re s s i o n
En recomptant et en fusionnant sept fois de plus, io puis ion, puis les
trois fusions qui construisent repres et les deux qui font ent, on obtient
un corpus où aucune paire n’apparaît plus d’une fois :
repres ent a t ionre t ent ionrepres s ion
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 7. Chaque fusion est choisie par un seul nombre, le compte de la paire. Aucune étape ne consulte de dictionnaire ni d'analyse morphologique.
Des morphèmes par accident
Sept jetons (repres, ent, a, t, ion, re, s) couvrent maintenant
les trois mots. Compter les paires et rien d’autre a trouvé ion et ent, de
vrais morphèmes de l’anglais, et repres, un radical commun. Cela a aussi
produit repres·ent·a·t·ion, qu’aucune linguiste ne proposerait comme analyse
morphologique de representation.
Faire la première fusion avec le groupe avant de montrer la trace : trois
mots au tableau, compter les paires, trouver que r + e gagne avec cinq.
Ensuite la figure fait le reste. Les deux choses à faire ressortir à la
fin : ion et ent sont de vrais morphèmes que personne ne lui a appris, et
repres·ent·a·t·ion n’est pas une analyse morphologique défendable.
Coller un texte et regarder
N’importe quel texte collé dans un segmenteur en ressort découpé, jeton par
jeton.
Les deux captures ci-dessous ont été prises le 8 septembre 2026 avec GPT-4o
sélectionné, et rognées sur les panneaux qui comptent. L’interface comme les
découpages changent : ce que vous verrez aujourd’hui peut ne pas y
correspondre.
Figure 8. Un seul collage, cinq langues, 180 jetons sur GPT-4o. L'anglais avance presque mot à mot ; plus on descend dans la liste, plus les couleurs coupent à l'intérieur des mots. Figure 9. Les mêmes cinq paragraphes tels que le modèle les reçoit. Les couleurs au-dessus sont pour vous ; ceci est l'entrée.
Ce que vous devriez voir
Les mots anglais courants font un jeton chacun, parce que les fusions qui
les construisent ont tourné assez souvent.
Les mots rares et les coquilles éclatent.Tokenization lui-même ressort
en deux ou trois morceaux, et htis en davantage.
Les autres langues coûtent plus de jetons pour la même phrase, et plus
une langue est éloignée des textes d’entraînement, plus elle coûte cher.
Un vocabulaire par modèle
Le vocabulaire derrière le découpage est une décision de conception, et il a
grandi. GPT-2 travaillait avec 50 257 jetons (Radford et al., 2019) ; les
segmenteurs qu’OpenAI a publiés depuis, dans sa bibliothèque ouverte
tiktoken, atteignent environ 200 000.
Une bonne part de cette croissance est allée aux textes non anglais : un
segmenteur récent garde entiers de nombreux mots français et néerlandais qu’un
ancien fragmentait. Les écarts entre les langues se réduisent sans disparaître,
et ils se
mesurent (see also the Consequences of tokenization chapter) (voir aussi le chapitre Conséquences de la jetonisation).
Tiktokenizer propose un choix de modèles, et le plus récent d’OpenAI qu’il
énumère est GPT-4o. C’est l’outil qui est en retard, non quelque chose qu’on
retiendrait : tiktoken associe GPT-5 au même vocabulaire que GPT-4o, si bien
que le découpage ci-dessus est celui d’aujourd’hui. D’autres entreprises sont
moins ouvertes qu’OpenAI là-dessus. Anthropic ne publie aucun segmenteur pour
Claude, seulement un
point d’accès
qui indique combien de jetons coûte un texte : pour ces modèles, le compte se
vérifie et les coupes ne se voient pas.
Tiktokenizer en direct, et laisser le groupe fournir le texte : une phrase
anglaise, la même phrase en français, puis un nom de famille. Le coût du
français est le résultat qui compte pour ce cours, et il est mesuré
correctement dans le chapitre sur les conséquences, à lire pour la séance 3.
The page behind this slideLa page derrière cette diapositive
1 / 2The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter