Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
This teaching view only exists in French.
D’où vient l’écart
Vous avez vu comment un segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. construit son vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. : l’encodage par paires d’octets byte-pair encoding (BPE)encodage par paires d'octets language modelsmodèles de langue A subword tokenization method that learns a vocabulary from training text by repeatedly joining frequently occurring adjacent characters or bytes.Méthode de segmentation sous-lexicale qui apprend un vocabulaire à partir d'un texte d'entraînement en fusionnant de façon répétée les caractères ou octets adjacents fréquents. fusionne les suites de caractères qui étaient fréquentes dans les textes sur lesquels il a été entraîné (see also the Tokenization chapter) (voir aussi le chapitre Jetonisation). Ces textes sont surtout en anglais. Les suites devenues des jetons entiers sont donc, pour la plupart, des mots anglais, et un mot français ou néerlandais doit être reconstruit à partir de fragments. L’écart naît dans le segmenteur, avant que le modèle ait lu quoi que ce soit.
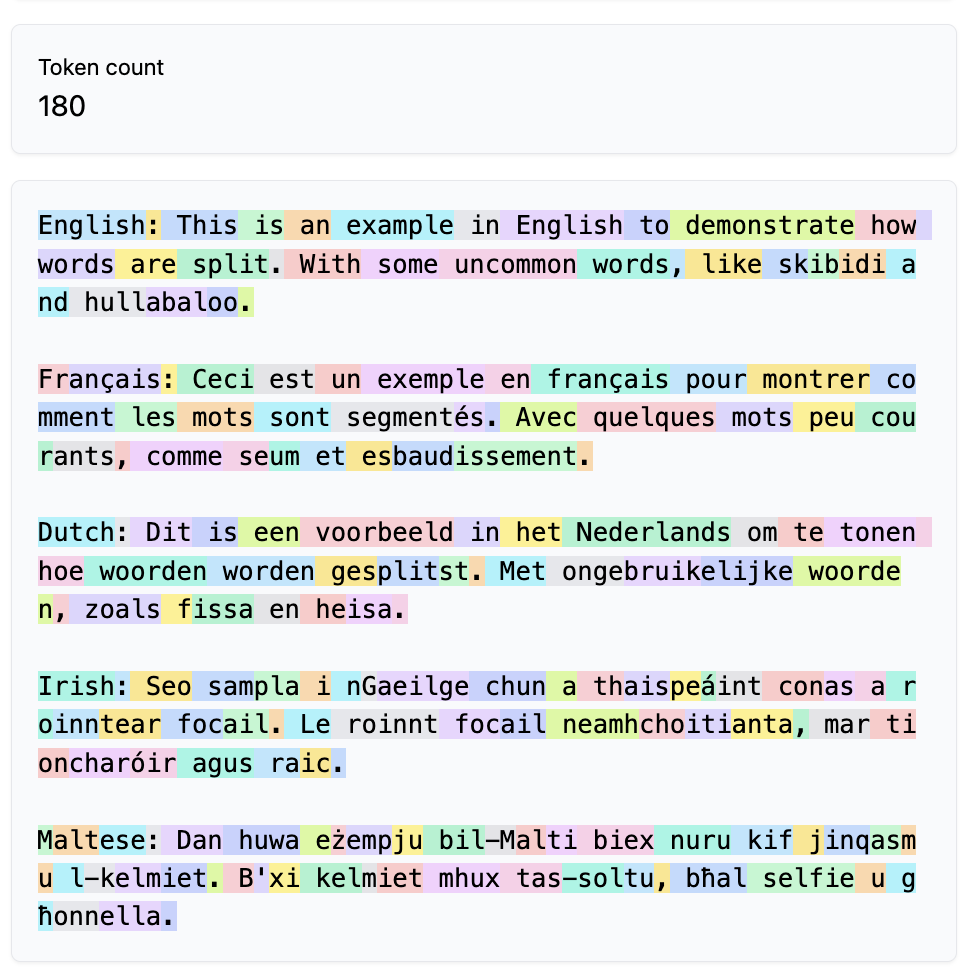
Les phrases de la capture ont été écrites avec deux mots peu courants chacune, de sorte que l’écart qu’elles montrent est dans le haut de la fourchette. Un texte plus long en donne un plus petit, et le vocabulaire fait aussi une différence.
Mesuré sur deux cents langues
Petrov et al. (2023) ont mesuré l’écart sur 200 langues, sur les mêmes phrases traduites par des personnes dans chacune d’elles, et le tableau ci-dessous reprend leur mesure sur ces phrases en y ajoutant le vocabulaire publié par OpenAI en 2024, celui de GPT-4o et de GPT-5. Chaque nombre est un multiple du compte anglais pour les mêmes 1 012 phrases : 1,37 veut dire 37 % de plus que l’anglais, 7,93 presque huit fois plus.Comment le tableau a été fait : le 11 septembre 2026, les 1 012 phrases du jeu de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. FLORES-200 (NLLB Team et al., 2024), le corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. utilisé par Petrov et al., ont été passées dans la bibliothèque tiktoken d’OpenAI sous ses trois vocabulaires, r50k_base (GPT-2, 2019), cl100k_base (GPT-4, 2022) et o200k_base (GPT-4o, 2024), et le compte de chaque langue a été divisé par celui de l’anglais. Les deux colonnes les plus anciennes reproduisent le tableau 1 de Petrov et al. à 0,02 près. Les mots sont comptés sur les espaces, que le chinois et le shan n’utilisent pas.
| Langue | Mots, × anglais | Jetons, GPT-2 (2019), × anglais | Jetons, GPT-4 (2022), × anglais | Jetons, GPT-4o et GPT-5 (2024), × anglais |
|---|---|---|---|---|
| Portugais | 1,07 | 1,93 | 1,48 | 1,23 |
| Néerlandais | 1,05 | 1,98 | 1,60 | 1,25 |
| Allemand | 0,99 | 2,14 | 1,59 | 1,31 |
| Français | 1,17 | 2,00 | 1,61 | 1,37 |
| Arabe | 0,90 | 4,36 | 3,03 | 1,38 |
| Chinois | 3,15 | 1,87 | 1,25 | |
| Shan | 18,69 | 14,98 | 7,93 |
Comme le montrent les résultats du tableau, l’anglais reste toujours nettement moins cher. Chaque nouveau vocabulaire a réduit l’écart, mais aucun ne l’a comblé : sous le vocabulaire de 2024, le français coûte encore 37 % de jetons de plus que l’anglais pour le même contenu, et le shan huit fois plus. Petrov et al. (2023) ont aussi trouvé l’écart dans des segmenteurs entraînés délibérément pour être multilingues ; ce n’est donc pas une particularité du vocabulaire d’une seule entreprise. Rien ne garantit non plus que le rétrécissement continue : OpenAI n’a pas dit quel vocabulaire GPT-6 utilise, si bien qu’au 11 septembre 2026 rien ne peut être mesuré pour lui, et un nouveau vocabulaire peut aussi coûter plus cher, comme la documentation d’Anthropic le dit du segmenteur introduit avec Claude Opus 4.7, qui produit environ 30 % de jetons de plus que son prédécesseur sur le même texte.
La colonne des mots montre qu’une partie de l’écart du français tient au français lui-même, qui prend plus de mots que l’anglais pour dire la même chose ; le reste vient du segmenteur, qui découpe ces mots en plus de morceaux. L’allemand ressort avec un peu moins de mots que l’anglais à cause de la façon dont la langue est construite : là où l’anglais écrit un mot composé en deux ou trois mots, l’allemand en écrit un seul, et chacun de ces longs mots est ensuite découpé en plusieurs jetons. Le chinois et le shan n’ont pas de compte de mots du tout, parce que les deux s’écrivent sans espaces entre les mots, de sorte que la notion de « mot » y est trop différente pour être comparable (see also the Tokenization (including an example of the rule-based approach) chapter, in the Classical NLP module) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles), dans le module TAL classique).
Conséquences d’une jetonisation moins efficace
Petrov et al. (2023) nomment trois conséquences, chacune avec un effet direct pour les utilisateurs :
- L’argent. Un service atteint par une interface de programmation d’application application programming interface (API)interface de programmation d'application (API) computinginformatique A standardized interface that allows software applications to communicate by sending requests and receiving responses, without needing to know how the other application works internally.Interface normalisée qui permet à des applications logicielles de communiquer en envoyant des demandes et en recevant des réponses, sans avoir à connaître le fonctionnement interne de l'autre application. (API) facture au jeton ; la même demande coûte donc plus cher dans une langue découpée en plus de morceaux.
- Le temps. Le temps de traitement croît avec le nombre de jetons.
- L’espace. La fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). est un nombre fixe de jetons ; un texte qui tient en anglais peut donc ne pas tenir dans sa traduction.
Une quatrième conséquence ne figure pas dans leur liste, mais a depuis été démontrée elle aussi :
- La qualité. Un jeton qui est un mot entier, ou un morceau de mot porteur de sens, donne au modèle une meilleure unité sur laquelle construire ses représentations qu’un fragment découpé selon la fréquence ; une langue dont les mots sont brisés en fragments est donc plus difficile à apprendre. Entraîner le même modèle avec des segmenteurs qui compriment plus ou moins le texte montre la corrélation : plus la jetonisation est compacte, mieux le modèle se comporte ensuite, le plus nettement sur les tâches de génération (Goldman et al., 2024). La même chose vaut d’une langue à l’autre. Ali et al. (2024) ont entraîné le même GML sur l’anglais, l’allemand, le français, l’italien et l’espagnol deux fois, une fois avec un segmenteur centré sur l’anglais et une fois avec un segmenteur construit pour les cinq langues. Avec le segmenteur centré sur l’anglais, le modèle s’est montré nettement moins bon dans les quatre autres langues, et son entraînement a coûté jusqu’à 68 % de plus, parce que chaque texte non anglais était plus long.
L’écart de jetons est l’une des façons dont la domination de l’anglais dans les données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. touche toutes les autres langues (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Le tableau complet est sur la page, visible dans le panneau du mode présentateur : le lire ligne par ligne à partir de là plutôt que de le projeter. Deux choses à faire ressortir : la colonne des mots (le français prend 17 % de mots de plus, l’allemand moins, à cause des composés) et la raison pour laquelle le chinois et le shan n’en ont pas.
Se moquer de GPT-4o, qui ne sait pas compter les lettres
Au milieu de 2024, une question a circulé en ligne : combien y a-t-il de r dans strawberry ? GPT-4o, un modèle qui avait reçu beaucoup d’attention médiatique et suscité beaucoup d’enthousiasme parce qu’il était censé être si intelligent et si impressionnant, soutenait obstinément qu’il n’y en avait que deux. Le décalage a rendu l’exemple viral : ce modèle pouvait faire bien plus que les humains à certains égards, mais n’arrivait pas à accomplir cette tâche de comptage élémentaire ?!
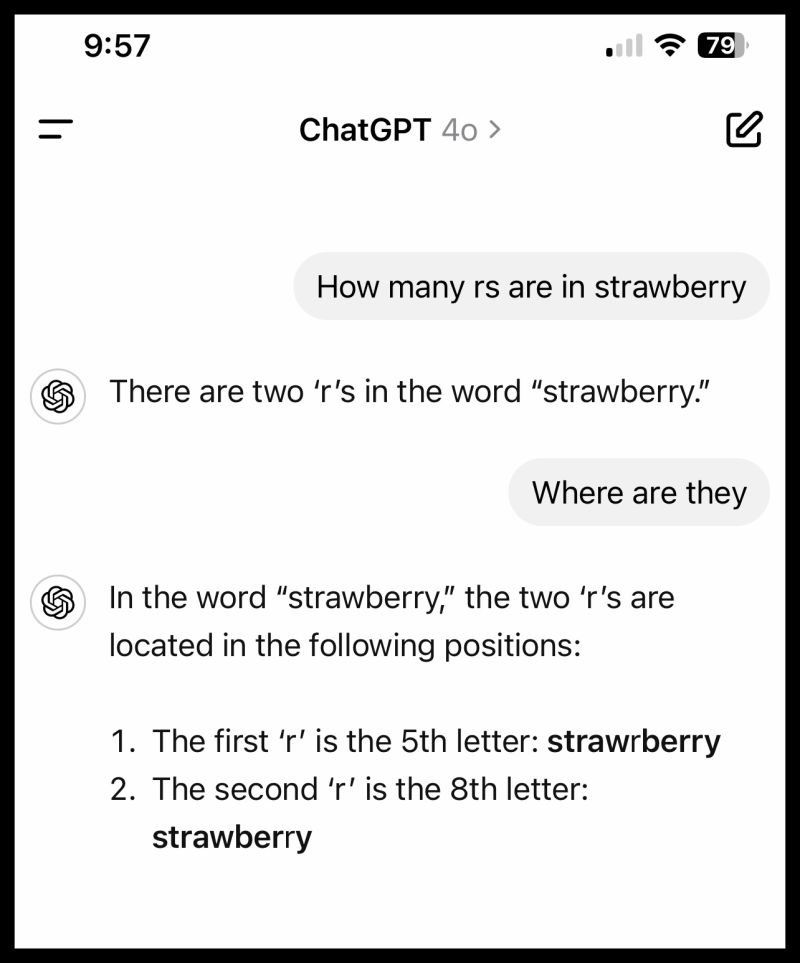
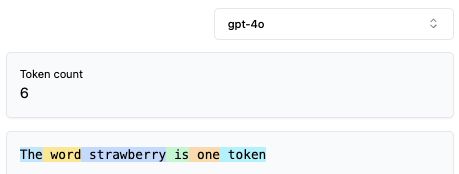
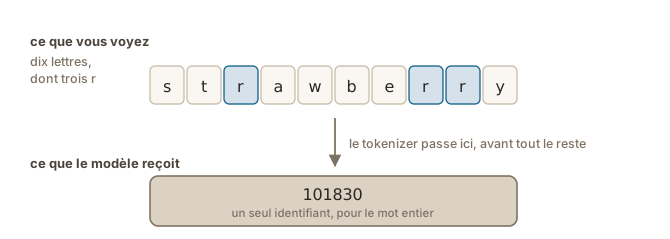
L’explication est le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. . Le modèle ne voit jamais s-t-r-a-w-b-e-r-r-y. Dans une phrase, et c’est ainsi que la question lui parvient, strawberry est un seul jeton, et ce qui parvient au modèle est le numéro de ce jeton. Un numéro ne dit rien de la forme du mot qu’il représente : ni combien de lettres il compte, ni lesquelles, ni leur ordre. Le modèle n’a aucune information explicite sur l’orthographe. Tout ce qu’il sait d’un jeton vient des contextes dans lesquels ce jeton est apparu dans ses textes d’entraînement ; ce qu’il sait de l’orthographe de strawberry est donc ce que les textes en ont dit, en mots, de la même façon qu’il connaît la capitale d’un pays.
Connaître une orthographe et s’en servir
Edman et al. (2024) ont testé cela systématiquement. Invités à épeler un mot fréquent lettre par lettre, les modèles testés y arrivaient presque toujours : des textes sur l’orthographe figurent dans les données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. , et le modèle a appris, comme un fait à propos du jeton, quelles lettres il représente. Invités à faire quelque chose de ces lettres, dire si un mot contient une lettre donnée, ce qu’il devient si chaque e est supprimé ou si deux lettres sont interverties, les mêmes modèles échouaient, alors qu’ils réussissaient les mêmes opérations sur des mots entiers. L’écart entre la version au niveau des mots et la version au niveau des lettres d’une même tâche atteignait 73 points d’exactitude accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. .
La même limite touche toute tâche qui porte sur les lettres : épeler un mot à l’envers, compter des caractères pour respecter une longueur maximale, former un acronyme à partir d’initiales, juger d’une rime d’après l’orthographe.
La même question deux ans plus tard
Posée le 11 septembre 2026, la même question reçoit la réponse « trois » de ChatGPT comme de Claude.
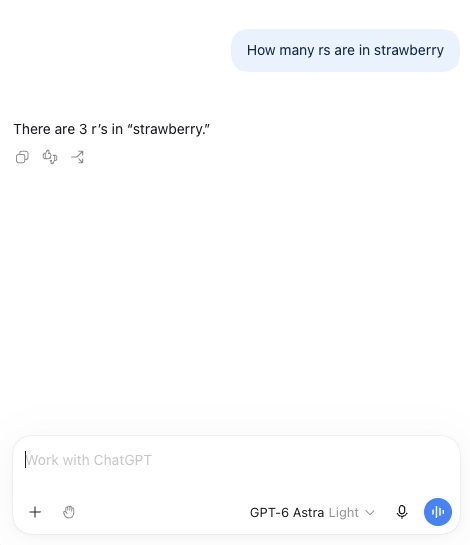
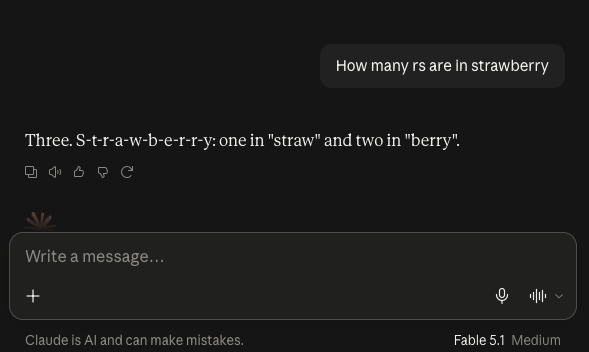
Cela veut-il dire que les modèles de 2026 sont meilleurs que GPT-4o ? Ils sont bien meilleurs, mais cette question n’en est pas la preuve. Un échec aussi célèbre finit dans les données d’entraînement, et une règle a fort bien pu être ajoutée pour que cette question précise reçoive une bonne réponse. Le mécanisme n’a pas changé : le modèle reçoit toujours des jetons, et un mot plus rare, une autre lettre ou une autre langue peut retrouver la même limite.
Épellent-ils mieux, alors ? Oui, mais ils peuvent encore se tromper. De façon anecdotique, ce que je constate dans mon propre usage, c’est que les modèles sont devenus beaucoup plus susceptibles de repérer une faute d’orthographe ou une coquille quand je leur demande de réviser un document, ce qu’ils faisaient mal il y a deux ans.
Une troisième possibilité est qu’un système réponde à une question comme celle-ci en écrivant quelques lignes de code et en les exécutant. Ce serait disproportionné ici, et aucun des deux systèmes ne l’a fait, mais les modèles sont bien meilleurs pour écrire du code que pour donner des réponses exactes sur des lettres, et les environnements construits autour d’eux leur permettent désormais d’appeler un outil quand c’est pertinent.
Si le temps le permet, poser la question en direct à ChatGPT et à Claude plutôt que de s’en tenir aux captures du 11 septembre 2026, et prendre ensuite un mot plus rare ou une autre langue : la limite se retrouve, même quand strawberry est compté juste.