Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Key pointsL'essentiel
Tokenization (including an example of the rule-based approach)La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)
A text is counted in two ways: its running words, the , and its distinct forms, the ; what counts as one word is itself a decision.
Un texte se compte de deux façons : chaque mot tel qu'il apparaît, ce sont les , et chaque forme distincte une seule fois, ce sont les ; ce qui compte pour un mot est déjà une décision.
Key pointsL'essentiel
Tokenization (including an example of the rule-based approach)La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)
Cutting a text into words looks like a job for one rule, but every kind of text adds an exception, and the rule set grows until it covers one language but still has holes; cutting it into sentences runs into the full stop, which does several jobs.
Couper un texte en mots semble demander une seule règle, mais chaque type de texte ajoute une exception, et l'ensemble de règles grossit jusqu'à couvrir une langue tout en gardant des trous ; couper un texte en phrases bute sur le point, qui joue plusieurs rôles.
Key pointsL'essentiel
Tokenization (including an example of the rule-based approach)La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)
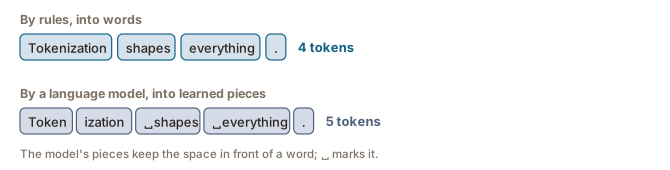
A language model also cuts text into tokens, but its cuts are learned from a corpus rather than written as rules, and its tokens are not the word tokens of this chapter.
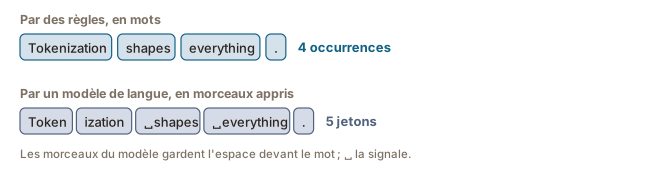
Un modèle de langue coupe lui aussi le texte en jetons, mais ses coupes sont apprises à partir d'un corpus au lieu d'être écrites sous forme de règles, et ses jetons ne sont pas les occurrences de mots de ce chapitre.
Page 1Page 1
Counting words: types and tokensCompter les mots : types et occurrences
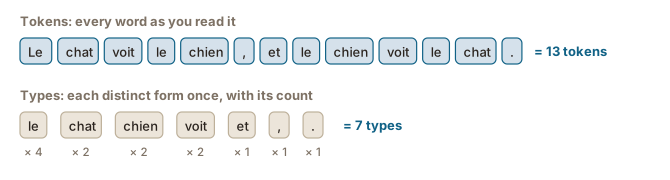
- A text can be counted in two ways: the running words, called , and the distinct forms, called . A text has more tokens than types, since common words come back.
- Tokens measure how long a text is, types how many different words it uses, and the ratio between them how much it repeats itself. The ratio falls as a text gets longer, so it only compares texts of a similar length.
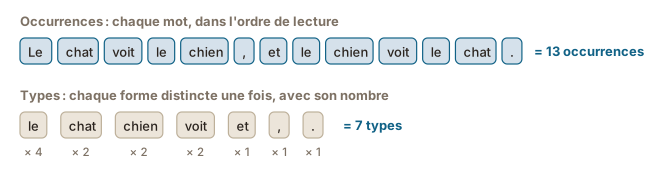
- Un texte se compte de deux façons : chaque mot tel qu'il apparaît, ce sont les , et chaque forme distincte une seule fois, ce sont les . Un texte compte plus d'occurrences que de types, puisque les mots courants reviennent.
- Les occurrences mesurent la longueur d'un texte, les types le nombre de mots différents qu'il emploie, et le rapport entre les deux sa tendance à se répéter. Ce rapport baisse à mesure qu'un texte s'allonge : il ne compare donc que des textes de longueur semblable.
Page 1Page 1
Page 2Page 2
Tokenizing a text with rulesSegmenter un texte avec des règles
- Cutting a text into words looks like a job for one rule, split at every space. Each new kind of text adds an exception, and the rule set grows until it covers one language, but still has holes.
- is the first step of almost every pipeline, and tokenization into words is still mostly done with rules: deterministic programs, fast and predictable.
- Couper un texte en mots semble demander une seule règle : couper à chaque espace. Chaque nouveau type de texte ajoute une exception, et l'ensemble de règles grossit jusqu'à couvrir une langue, mais il garde des trous.
- La est la première étape de presque toutes les chaînes de traitement, et la segmentation en mots se fait encore surtout avec des règles : des programmes déterministes, rapides et prévisibles.
Page 2Page 2
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Page 2Page 2
Page 3Page 3
Hard cases for tokenizationLes cas difficiles de la segmentation
- Dates, amounts, addresses, abbreviations and names all break the simple rules, and each language and each kind of text adds cases of its own.
- Two tokenizers often cut a text differently, so the counts, the searches and the matches that depend on them differ from one tool to another.
- Les dates, les montants, les adresses, les abréviations et les noms propres mettent tous en défaut les règles simples, et chaque langue et chaque type de texte ajoutent leurs propres cas.
- Deux segmenteurs coupent souvent un texte différemment : les comptes, les recherches et les correspondances qui en dépendent changent donc d'un outil à l'autre.
Page 4Page 4
Segmenting a text into sentencesSegmenter un texte en phrases
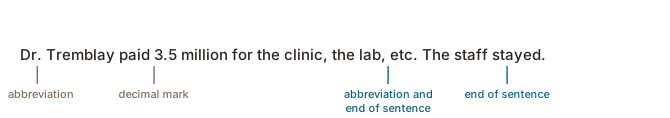
- cuts a text into sentences. Question and exclamation marks almost always end one; the full stop is the difficulty, since it also marks abbreviations and appears inside numbers.
- Rules for the full stop nest: each exception fixes a case the rule above got wrong, and opens a new one. The segmentation rules of translation tools are lists of the same kind.
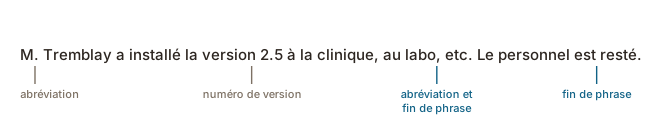
- La coupe un texte en phrases. Les points d'interrogation et d'exclamation en terminent presque toujours une ; la difficulté vient du point, qui marque aussi les abréviations et apparaît dans les nombres.
- Les règles pour le point s'emboîtent : chaque exception corrige un cas que la règle au-dessus traitait mal, et en ouvre un nouveau. Les règles de segmentation des outils de traduction sont des listes du même genre.
Page 4Page 4