Exchange formats in translationLes formats d'échange en traduction
Reading XMLLire du XML
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Written alternately in EN and FR, translation partly generated in both directions.
Rédigé en alternance en EN et en FR, traduction en partie générée dans les deux sens.
What XML looks likeÀ quoi ressemble le XML
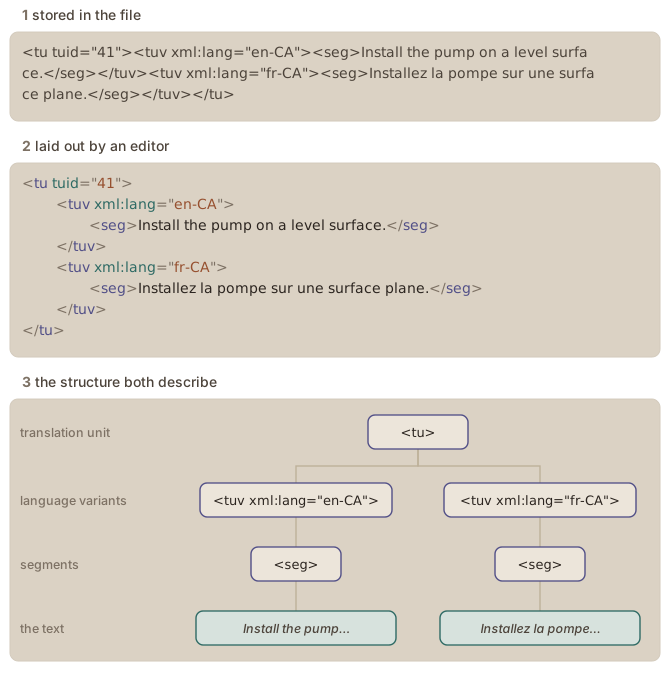
Figure 1. One document, three views: what is in the file, how an editor shows it, and the structure behind both.
That structure is made of elements and tags, of the attributes attached to
them, and of the hierarchy they build.Every
example in this chapter is an excerpt. A complete XML file opens with a
declaration, <?xml version="1.0" encoding="UTF-8"?>, taken up on the encoding
page.
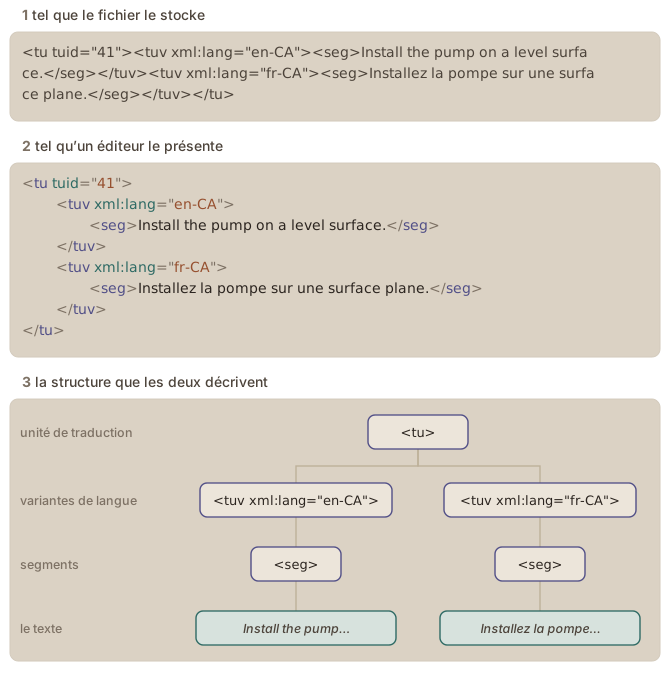
Cette structure est faite d’éléments et de balises, des attributs qu’ils
portent, et de la hiérarchie qu’ils construisent.Tous les exemples de ce chapitre sont des extraits. Un
fichier XML complet s’ouvre par une déclaration, <?xml version="1.0" encoding="UTF-8"?>, reprise à la page sur le codage.
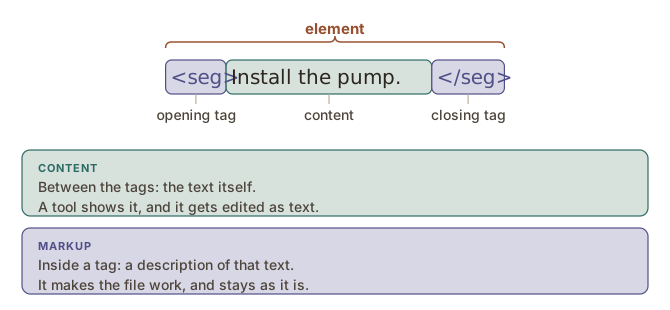
Elements nest inside one another and form a tree: each element can contain
other elements, its children.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
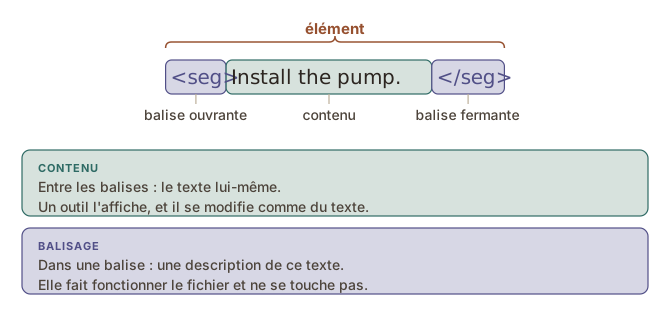
Les éléments s’imbriquent les uns dans les autres et forment un arbre : chaque
élément peut contenir d’autres éléments, ses enfants.
<tu> <tuv xml:lang="en-CA"> <seg>Install the pump on a level surface.</seg> </tuv> <tuv xml:lang="fr-CA"> <seg>Installez la pompe sur une surface plane.</seg> </tuv></tu>
Reserved characters and namespacesCaractères réservés et espaces de noms
Strange characters, files that will not open
Two points of syntax turn up in every interchange file. Recognizing them saves
you a headache later, over strange characters in the text or a file that no
longer opens the way it should.
Reserved characters
Angle brackets delimit tags: a < in text would be read as the start of a tag.
XML therefore gives it a replacement spelling, and gives the ampersand one too,
since every replacement begins with an ampersand:
In the text
Written in the file
<
<
&
&
>, " and ' have replacement spellings too (>, ", '),
required only in certain contexts; tools often write them anyway.
In practice: a company called Smith & Sons appears in the file as
Smith & Sons, and the translation is written the same way. Do not replace
& with & by hand, you would break the file.
xmlns announces that <unit>, <segment> and the other tags that follow are
XLIFF’s, and not those of some other format using the same names. A document
can declare several namespaces, each marked by a prefix of the form
prefix:tag. This is how a tool adds tags of its own to a standard format
without colliding with it, and it is also a source of trouble in exchange: a
tool that does not know that vocabulary will get nothing out of those tags.
One namespace is declared in advance by the XML standard itself, the one for
the xml prefix. That is why xml:lang appears everywhere with no matching
declaration in the file.
Deux détails de syntaxe reviennent dans tous les fichiers d’échange. Les
reconnaître vous évitera bien des ennuis devant des caractères étranges ou un
fichier qui ne s’ouvre plus comme il devrait.
Caractères réservés
Les chevrons délimitent les balises : un < dans du texte serait lu comme le
début d’une balise. XML lui prévoit donc une écriture de remplacement, et à
l’esperluette aussi, puisque chaque remplacement commence par une esperluette :
Dans le texte
S’écrit dans le fichier
<
<
&
&
>, " et ' ont eux aussi une écriture de remplacement (>, ",
'), obligatoire seulement dans certains contextes ; les outils les
écrivent souvent par prudence.
En pratique : une entreprise nommée Smith & Sons apparaît dans le fichier sous
la forme Smith & Sons, et la traduction s’écrit de la même façon. Ne
remplacez pas & par & à la main, vous casseriez le fichier.
xmlns annonce que <unit>, <segment> et les autres balises qui suivent
sont celles de XLIFF, et non celles d’un autre format qui emploierait les mêmes
noms. Un document peut déclarer plusieurs espaces de noms, chacun repéré par un
préfixe de la forme prefixe:balise. C’est ainsi qu’un outil ajoute ses
propres balises à un format normalisé sans entrer en conflit avec lui, et c’est
aussi une source de difficultés à l’échange : un outil qui ne connaît pas ce
vocabulaire ne tirera rien de ces balises.
Un espace de noms est déclaré d’avance par la norme XML elle-même, celui du
préfixe xml. C’est pourquoi xml:lang apparaît partout sans déclaration
correspondante dans le fichier.
Plain text and its lines said a
file is characters and nothing else. That is true of what the file means; what
it stores is bytes, and an encoding is the agreement that turns one back into
the other. If the agreement is wrong, the letters come
back wrong, which is why this is the problem French text hits first.
The declaration says which one
The very first line of an XML file is its declaration:
<?xml version="1.0" encoding="UTF-8"?>
encoding names the agreement the file was written under. UTF-8 covers accents,
non-Latin alphabets and almost everything else, and it is what TMX, TBX and
XLIFF use.Some programs, Windows ones above all, start a UTF-8 file
with three invisible bytes announcing the encoding, called a byte order mark or
BOM. Most tools take it in their stride, but one that does not will show it as
 in front of the first character, or trip over a first line that looks
perfectly normal on screen. If a file misbehaves only on its first line, this is
usually why, and a text editor that offers to save “UTF-8 without BOM” is
offering the fix.
When it goes wrong
An accented letter is where the trouble shows, because in UTF-8 it takes two
bytes rather than one. Written as UTF-8 and read as if it were an older
one-byte encoding, “é” arrives as two letters instead:
A whole file of that is the classic symptom: every accent has turned into two
characters, and nothing else has moved. It means the file was written under one
agreement and read under another, not that the text was damaged, so opening it
again with the right encoding usually brings it back.The other
direction is uglier. In a one-byte file opened as UTF-8, the accented bytes make
no valid character at all, so they come back as �. Save the file in that state
and the original letter is gone for good.
Le texte brut et ses lignes
disait qu’un fichier est fait de caractères et de rien d’autre. C’est vrai de ce
que le fichier signifie ; ce qu’il stocke, ce sont des
octets, et le codage est la convention qui fait passer des uns aux autres.
Si la convention est fausse, les lettres reviennent fausses, et c’est pourquoi
le texte français rencontre ce problème avant tout autre.
La déclaration dit laquelle
La toute première ligne d’un fichier XML est sa déclaration :
<?xml version="1.0" encoding="UTF-8"?>
encoding nomme la convention selon laquelle le fichier a été écrit. UTF-8
couvre les accents, les alphabets non latins et à peu près tout le reste, et
c’est ce qu’emploient TMX, TBX et XLIFF.Certains logiciels, ceux de
Windows au premier chef, font commencer un fichier UTF-8 par trois octets
invisibles qui annoncent le codage, ce qu’on appelle une marque d’ordre des
octets, ou BOM (byte order mark). La plupart des outils s’en accommodent, mais
celui qui ne le fait pas l’affiche sous la forme  devant le premier
caractère, ou bute sur une première ligne qui semble pourtant normale à l’écran.
Quand un fichier ne pose problème que sur sa première ligne, c’est en général
cela, et un éditeur de texte qui propose d’enregistrer en « UTF-8 sans BOM »
propose la solution.
Quand cela tourne mal
C’est sur les lettres accentuées que l’ennui se voit, parce qu’en UTF-8 elles
occupent deux octets au lieu d’un. Écrit en UTF-8 puis relu comme s’il
s’agissait d’un ancien codage à un octet, le « é » arrive sous la forme de deux
lettres :
Un fichier entier dans cet état, c’est le symptôme classique : chaque accent
s’est transformé en deux caractères, et rien d’autre n’a bougé. Cela veut dire
que le fichier a été écrit selon une convention et relu selon une autre, non
que le texte a été abîmé : le rouvrir avec le bon codage le rétablit
généralement.L’autre sens est plus vilain. Dans un fichier à un octet relu
en UTF-8, les octets accentués ne forment aucun caractère valide : ils
reviennent sous la forme de �. Enregistrez le fichier dans cet état et la
lettre d’origine est perdue pour de bon.
What to translate, what to leaveCe qui se traduit, ce qui ne se touche pas
The same sentence in two languages
Back to the sentence from the guide of our fictional client, Cascade Pumps Inc.:
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
In French:
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
The text changed, the structure did not. The tags are the same and there are as
many of them, and <strong> followed the term it emphasizes, which no longer
comes at the same place in the sentence.
Reprenons la phrase du guide de notre client fictif, Cascade Pumps Inc. :
<p>Install the <strong>centrifugal pump</strong> on a level surface.</p>
En français :
<p>Installez la <strong>pompe centrifuge</strong> sur une surface plane.</p>
Le texte a changé, la structure non. Les balises sont les mêmes et en même
nombre, et <strong> a suivi le terme qu’il met en relief, lequel n’occupe
plus la même place dans la phrase.