Foundations of AI & NLPFondements de l'IA et du TAL
From neural networks to large language modelsDes réseaux de neurones aux grands modèles de langue
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Neurons and layersNeurones et couches
The systems behind much of today’s language technology, including almost all
machine translation systems and chatbots with which you will interact, are
neural networks. The name suggests something brain-like, and the inspiration
is real, but loose: there are some similarities between artificial neural
networks and natural neural networks like our brain, but this does not go
beyond the very basics.
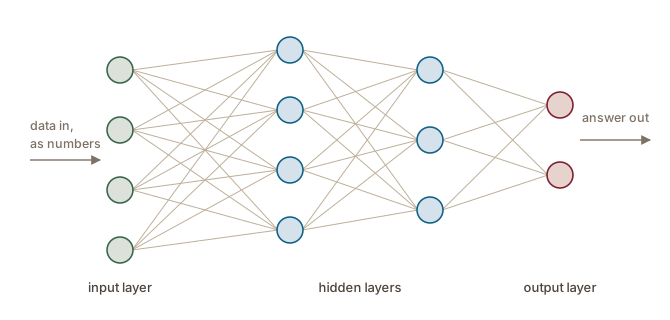
Figure 1. The standard picture of a neural network. Each circle is a unit, each line a weighted connection. Data enters on the left as numbers and comes out on the right as an answer.
The units are organized in layers. An input layer takes in the raw data as
numbers; one or more hidden layers transform it, step by step; an output
layer produces the answer, for example one value per possible category. When
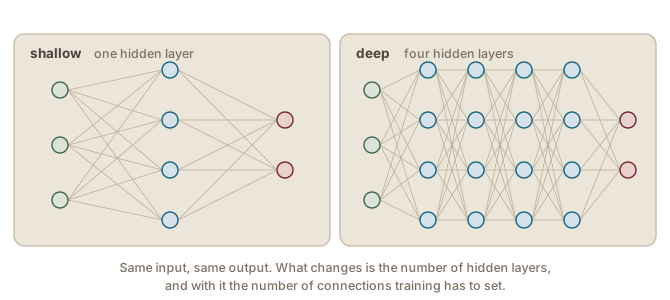
there are many hidden layers, the network is called deep, which is all that
the “deep” in deep learning means (LeCun et al., 2015).
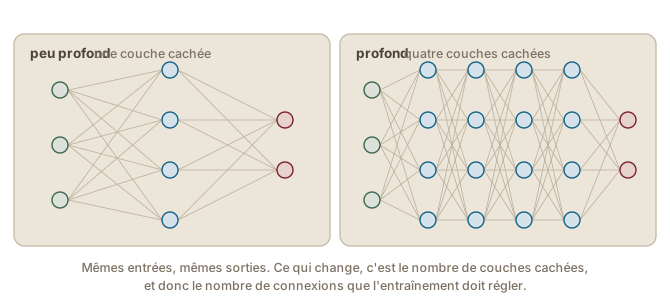
Figure 2. The same input and the same output, once with one hidden layer and once with four. Only the number of hidden layers changes.
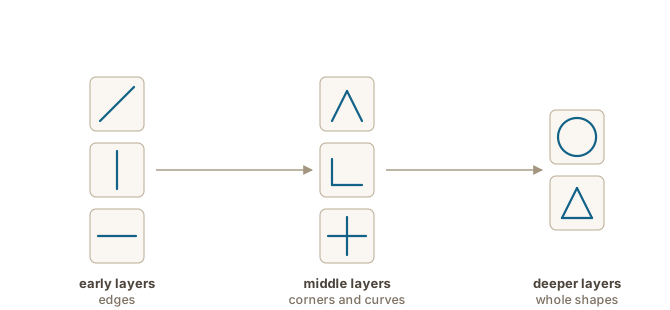
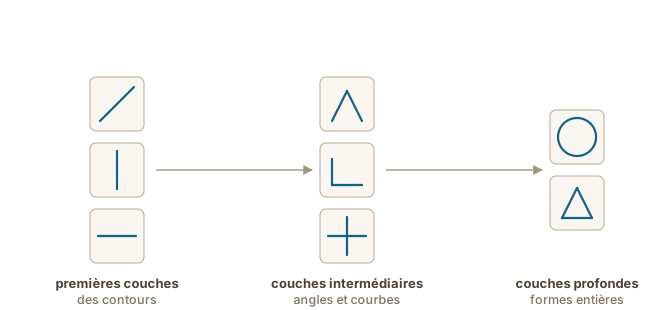
Depth is what lets a network build complex patterns out of simple ones. Early
layers pick up simple regularities in the raw input; later layers combine
those into larger ones. In image recognition, the classic illustration, first
edges, then shapes, then faces. For text the same principle applies, with one
catch: a network’s input layer takes numbers, so using one for language
requires a way to encode language as
numbers (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Figure 3. A schematic, not real network output: simple motifs in the early layers, combinations of them in the middle, closed shapes deeper in.
Les systèmes derrière une bonne partie des technologies langagières
d’aujourd’hui, dont la quasi-totalité des systèmes de traduction automatique et
des agents conversationnels avec lesquels vous interagirez, sont des réseaux de
neurones. Le nom évoque quelque chose de cérébral, et l’inspiration est réelle,
mais lâche : il existe certaines ressemblances entre les réseaux de neurones
artificiels et les réseaux de neurones naturels comme notre cerveau, mais cela
ne va pas au-delà des bases.
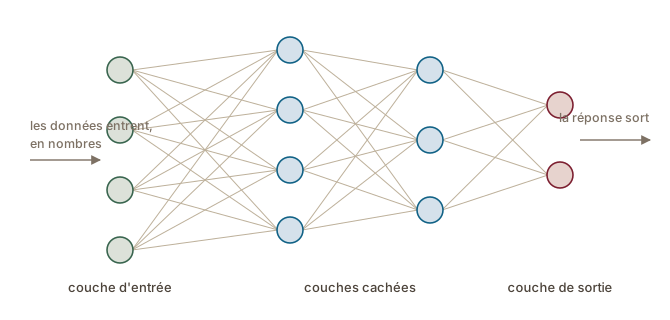
Figure 1. L'image habituelle d'un réseau de neurones. Chaque cercle est une unité, chaque trait une connexion pondérée. Les données entrent à gauche sous forme de nombres et la réponse sort à droite.
Les unités sont organisées en couches. Une couche d’entrée reçoit les données
brutes sous forme de nombres ; une ou plusieurs couches cachées les
transforment, étape par étape ; une couche de sortie produit la réponse, par
exemple une valeur par catégorie possible. Quand il y a beaucoup de couches
cachées, on dit que le réseau est profond, et c’est tout ce que veut dire le
« profond » d’apprentissage profond (LeCun et al., 2015).
Figure 2. Les mêmes entrées et les mêmes sorties, une fois avec une couche cachée et une fois avec quatre. Seul le nombre de couches cachées change.
C’est la profondeur qui permet à un réseau de construire des motifs complexes à
partir de motifs simples. Les premières couches relèvent des régularités
simples dans l’entrée brute ; les couches suivantes les combinent en motifs
plus grands. En reconnaissance d’images, l’illustration classique, d’abord des
contours, puis des formes, puis des visages. Pour le texte, le même principe
s’applique, avec une réserve : la couche d’entrée d’un réseau reçoit des
nombres, donc utiliser un réseau pour la langue demande une façon d’encoder la
langue en nombres (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Figure 3. Un schéma, et non la sortie réelle d'un réseau : des motifs simples dans les premières couches, leurs combinaisons au milieu, des formes fermées plus loin.
Suppose we want a network that tells diamonds, squares and circles
apart.Shapes are a toy task, chosen
for its simplicity and easy visualization. A real network
chooses among far more classes, and its input is rarely anything as tidy as a
drawn shape. The loop is the same either way, which is what lets the example
be this small. That already fixes the shape of its output layer:
one unit per category, one for square, one for circle, one for diamond.
Their scores are turned into percentages that add up to 100, so the three
answers compete, and raising one lowers the others.
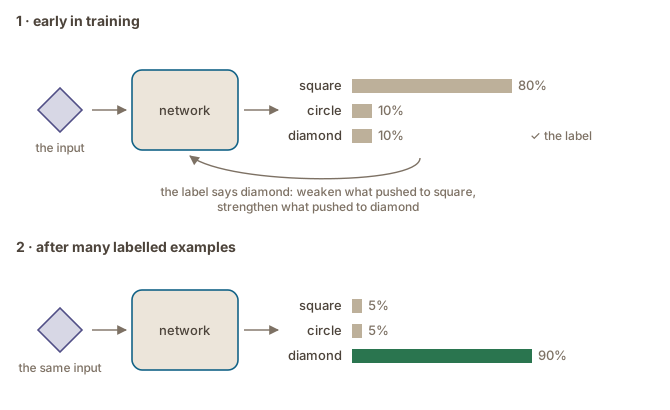
A network answers in probabilities from the start. Untrained, they are
essentially random. Given a picture of a diamond and asked what shape it is,
the answer might be something like: square 40%, circle 35%, diamond 25%. Early
in training they can be confidently wrong instead: square 80%, circle 10%,
diamond 10%. The network is then told the right answer, and the
predict-compare-adjust loop of supervised
learning reappears in its neural form (see also the From rules to machine learning chapter) (voir aussi le chapitre Des règles à l'apprentissage automatique):
the error flows backward through the network, and the connections that pushed
toward square are weakened, the ones that pushed toward diamond
strengthened.
Figure 4. The training loop. The network predicts, the prediction is compared with the label, and the connections are adjusted. Repeated over enough examples, the predictions sharpen.
The decisive difference from a feature-based model is what the network learns
from. A feature-based model needed a human to decide that suffixes and
capitalization matter. A neural network takes raw data (e.g., pixels of
an image, or numerical representations of words), and finds its own
regularities in it, including ones no human would have thought to specify. The
features are learned, and feature engineering disappears. The human work does
not disappear with it: choosing and encoding features used to be most of the
effort of building a system, and the effort now goes into collecting the data,
defining the task and designing the network.
Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. https://doi.org/10.1037/h0042519
Un exemple jouet
Supposons que nous voulions un réseau qui distingue les losanges, les carrés et
les cercles.Les formes sont une tâche jouet, choisie pour sa
simplicité et sa facilité de visualisation. Un vrai réseau choisit parmi
beaucoup plus de catégories, et son entrée est rarement aussi nette qu’une forme
dessinée. La boucle est la même dans les deux cas, et c’est ce qui permet à
l’exemple d’être aussi petit. Cela fixe déjà la forme de sa couche de
sortie : une unité par catégorie, une pour carré, une pour cercle, une pour
losange. Leurs scores sont transformés en pourcentages dont la somme fait 100,
si bien que les trois réponses sont en concurrence : en faire monter une fait
descendre les autres.
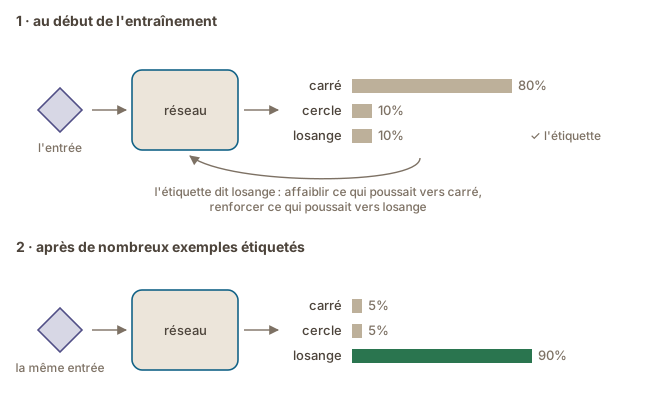
Un réseau répond en probabilités dès le départ. Sans entraînement, elles sont
essentiellement aléatoires. Si on lui montre l’image d’un losange en lui demandant de
quelle forme il s’agit, la réponse pourrait ressembler à ceci : carré 40 %,
cercle 35 %, losange 25 %. Tôt dans l’entraînement, elles peuvent au
contraire être fausses avec assurance : carré 80 %, cercle 10 %, losange
10 %. On donne ensuite la bonne réponse au réseau, et la boucle prédire,
comparer, ajuster de l’apprentissage supervisé reparaît sous sa forme
neuronale (see also the From rules to machine learning chapter) (voir aussi le chapitre Des règles à l'apprentissage automatique) : l’erreur remonte à
travers le réseau, les connexions qui poussaient vers carré sont affaiblies,
celles qui poussaient vers losange renforcées.
Figure 4. La boucle d'entraînement. Le réseau prédit, la prédiction est comparée à l'étiquette, et les connexions sont ajustées. Répétée sur assez d'exemples, la boucle affine les prédictions.
La différence avec un modèle fondé sur des attributs
La différence décisive avec un modèle fondé sur des attributs tient à ce à
partir de quoi le réseau apprend. Un tel modèle demandait à une personne de
décider que les suffixes et les majuscules comptent. Un réseau de neurones prend
des données brutes (p. ex. les pixels d’une image, ou des représentations
numériques de mots) et y trouve ses propres régularités, y compris celles que
personne n’aurait pensé à préciser. Les attributs sont appris, et l’ingénierie
des attributs disparaît. Le travail humain ne disparaît pas pour autant : choisir et
encoder les attributs constituait l’essentiel de l’effort de construction d’un
système, et l’effort va désormais à la collecte des données, à la définition de
la tâche et à la conception du réseau.
Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. https://doi.org/10.1037/h0042519
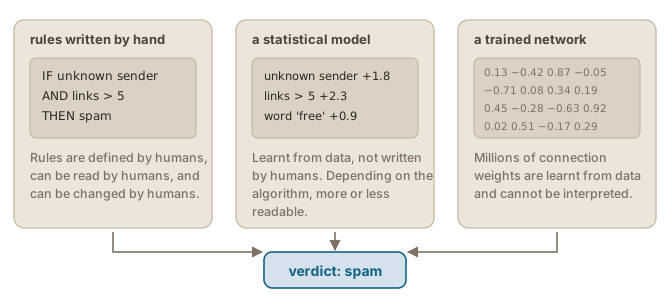
Statistical systems are a sort of middle ground: their rules are learnt from
data rather than written by hand, but stay more or less
readable (see also the Four paradigms page) (voir aussi la page Quatre paradigmes). How readable depends on
the algorithm: a decision tree can be printed and followed, while the weights
of a support vector machine with a non-linear kernel cannot be read that way.
Figure 5. The same verdict reached three ways: rules written by hand, rules learnt from data, and weights learnt from data.
This is what people mean when they call neural networks black boxes, and it
is a property of the approach rather than a defect to be patched later. The
power of the method comes from letting the system find regularities
too numerous and too diffuse for anyone to write down; a representation
humans could read would be a representation humans could have written.
Four consequences follow for anyone who works with these systems:
Behaviour is discovered by testing, not by inspection. The only way to
know how a system handles legal text, or Québécois French, is to try it on
legal text and Québécois French, which is why evaluation is a professional
skill in its own right (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières).
Confidence is not self-knowledge. A network reports probabilities, and
they measure how its training data looked, never how much it
“knows” (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1(5), 206-215. https://doi.org/10.1038/s42256-019-0048-x
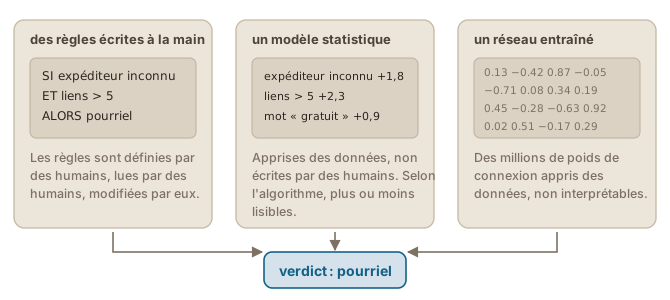
Les systèmes statistiques sont une sorte de moyen terme : leurs règles sont
apprises à partir de données plutôt qu’écrites à la main, mais restent plus ou
moins lisibles (see also the Four paradigms page) (voir aussi la page Quatre paradigmes). Le degré de
lisibilité dépend de l’algorithme : un arbre de décision peut être imprimé et
suivi, alors que les poids d’une machine à vecteurs de support à noyau non
linéaire ne se lisent pas ainsi.
Figure 5. Le même verdict atteint de trois façons : des règles écrites à la main, des règles apprises des données, et des poids appris des données.
C’est ce qu’on veut dire en appelant les réseaux de neurones des boîtes noires,
et c’est une propriété de l’approche plutôt qu’un défaut à corriger plus tard.
La puissance de la méthode vient de ce qu’on laisse le système trouver des
régularités trop nombreuses et trop diffuses pour que quiconque les écrive ;
une représentation lisible par des humains serait une représentation que des
humains auraient pu écrire.
Quatre conséquences en découlent pour qui travaille avec ces systèmes :
Le comportement se découvre en testant, pas en inspectant. La seule façon
de savoir comment un système traite un texte juridique, ou du français
québécois, est de l’essayer sur un texte juridique et sur du français
québécois, et c’est pourquoi l’évaluation est une compétence professionnelle à
part entière (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières).
L’assurance n’est pas de la connaissance de soi. Un réseau donne des
probabilités, et elles mesurent à quoi ressemblaient ses données
d’entraînement, jamais ce qu’il « sait » (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1(5), 206-215. https://doi.org/10.1038/s42256-019-0048-x
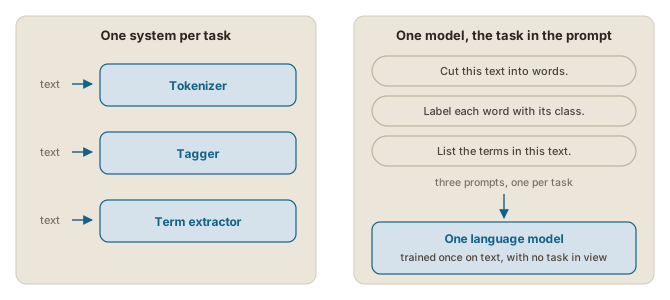
Figure 6. Three systems, each built for its task, and one model that is given each task in a prompt.
Decreasing human influence
Each shift took one thing out of the developer’s hands, as the table below
sets out, and the last took the largest: the task itself, which passes to the
person using the model.
Shift
No longer specified by the developer
Still specified by people
Rules to machine learning
the patterns
the task and the features, by the developer, before training
A far simpler interface, so far less specialized users. A prompt is
ordinary text rather than a program, so the person who describes the job
is often the person who used to be a user of someone else’s system. The
line between building a system and using one has moved.
An even larger appetite for data and computation, in place of explicit
knowledge. Each earlier shift already traded knowledge written by people
for data; this one trades the task description itself for more text and
more computation.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Un seul modèle, de nombreuses tâches
Chaque système des trois premiers paradigmes était construit pour une tâche :
un filtre antipourriel trie les courriels, un étiqueteur attribue à chaque mot
sa classe grammaticale, et le système suivant oblige à repartir de zéro, avec
de nouvelles règles, de nouveaux attributs ou de nouvelles données
étiquetées. Un grand modèle de langue est un
réseau de neuronesneural network (NN)réseau de neurones (RNA)machine learningapprentissage automatiqueA machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. du type que décrit ce
chapitre, entraîné à partir d’exemples comme dans les deuxième et troisième
paradigmes, à ceci près que les exemples sont du texte brut et que la tâche
consiste à prédire le mot suivant (Jurafsky & Martin, 2026). Rien dans cet
entraînement ne nomme une tâche, et une fois entraîné, le même modèle
traduit, résume, dresse la liste des termes d’un texte ou en étiquette les
mots, quand la demande lui est rédigée dans une requête (Brown et al., 2020).
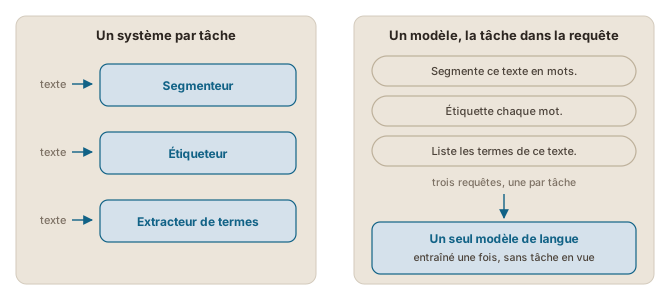
La Figure 6figure 6 compare les deux façons de faire.
Figure 6. Trois systèmes, chacun construit pour sa tâche, et un seul modèle qui reçoit chaque tâche dans une requête.
Une influence humaine qui diminue
Chaque changement a retiré une chose des mains du développeur, comme le
montre le tableau ci-dessous, et le dernier a retiré la plus importante : la
tâche elle-même, qui passe à la personne qui se sert du modèle.
Changement
N’est plus spécifié par le développeur
Reste spécifié par des personnes
Des règles à l’apprentissage automatique
les régularités
la tâche et les attributs, par le développeur, avant l’entraînement
De l’apprentissage automatique à l’apprentissage profond
la tâche et ses données, par le développeur, avant l’entraînement
De l’apprentissage profond aux grands modèles de langue
la tâche
la tâche, par la personne qui se sert du modèle, dans une requête
Les trois changements, et la part du travail que le développeur ne spécifie plus après chacun.
Un grand modèle de langue relève, techniquement, de l’apprentissage profond.
Quatre choses en font pourtant un paradigme à part entière, plutôt qu’une
étape à l’intérieur du troisième :
Une interface bien plus simple, donc des utilisateurs bien moins
spécialisés. Une requête est du texte ordinaire et non un programme, si
bien que la personne qui décrit la tâche est souvent celle qui, auparavant,
se servait du système de quelqu’un d’autre. La frontière entre construire
un système et s’en servir s’est déplacée.
Un appétit encore plus grand pour les données et le calcul, au lieu de
connaissances explicites. Chaque changement précédent troquait déjà des
connaissances écrites par des personnes contre des données ; celui-ci
troque la description même de la tâche contre davantage de texte et de
calcul.
Tout ce qui valait pour le troisième paradigme vaut encore pour le quatrième :
les régularités qu’il a apprises sont réparties sur des milliards de
nombres que personne ne sait lire (see also the black box page) (voir aussi la page La boîte noire) ;
tout ce qu’il fait vient de son texte d’entraînement, avec les lacunes et
les penchants de ce texte (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML) ;
les tâches qu’il réussit ou rate ne suivent pas ce qu’une personne trouve
difficile, si bien que ses capacités doivent être
testées ;
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/