Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Three sentences, one word
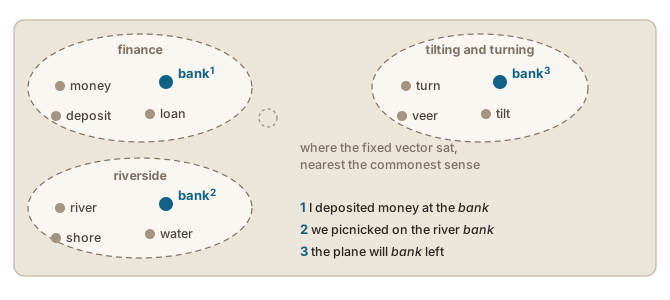
Take three sentences with bank in them:
- I deposited money at the bank.
- We picnicked on the river bank.
- The plane will bank left.
You would translate the word three different ways: banque, rive, virer. A fixed embedding gives all three the same vector.
A vector per occurrence
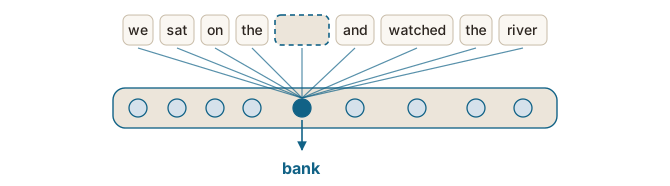
A contextual embedding sides with the translator. Instead of storing one finished vector per word, the model computes a vector for each occurrence, at the moment of use, from the whole sentence around it:
- the bank beside deposited and money comes out near the vocabulary of finance;
- the one beside river and picnicked, near geography;
- the one after will, in verb territory.
Same word, three vectors, each shaped by its company. Models that work this way arrived in the late 2010s, and ELMo was the landmark (Peters et al., 2018).
This is also where the material stops being machine learning machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. in general and becomes deep learning deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. . Word2vec kept its model deliberately simple, which let it train on billions of words (Mikolov et al., 2013a). Computing a vector for every occurrence takes many layers instead, and ELMo’s paper says so in its title, Deep contextualized word representations.
What happens to polysemy
Nobody lists the senses of bank or writes a rule to pick one. The senses simply stop being merged, because there is no single vector left for them to be merged into.
One consequence is easy to miss. A word no longer has “its vector”, the kind you could print in a table. It has a vector in each sentence, so the question “what does the model think bank means?” only has answers of the form “here, in this sentence”. Word meaning in isolation, the thing a dictionary records, has quietly left the system.
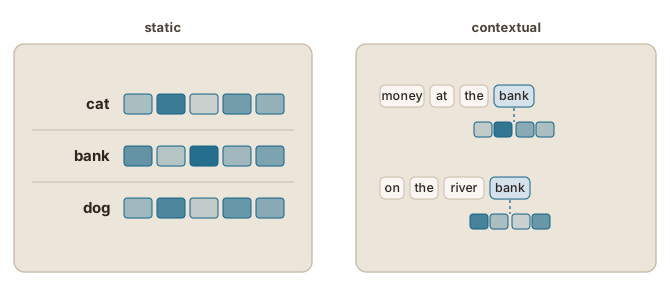
Three sentences on the board first: I deposited money at the bank, we picnicked on the river bank, the plane will bank left. Ask for the French of each. Then the figure: the room has already done what the model does.
Before or after
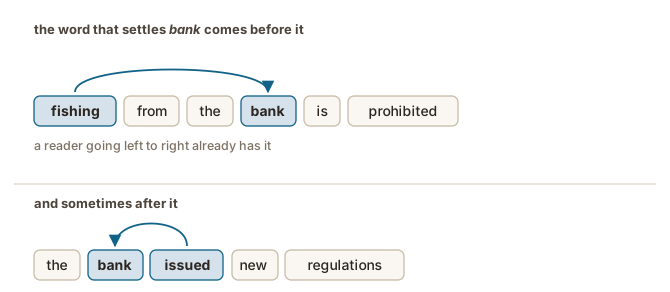
Where does the word that settles the ambiguity sit? Sometimes before the ambiguous word: in fishing from the bank is prohibited, fishing has settled the sense by the time bank arrives. Sometimes after it: in the bank issued new regulations, the deciding word only comes once bank has been read.
Reading both ways
ELMo already used both sides, but shallowly: one model read the sentence left to right, a second read it right to left, and their outputs were joined at the end, so the two directions were never combined during training (Devlin et al., 2019).
BERT is the model that put the two together.ELMo and BERT set a fashion, and the acronyms that followed were bent to land on Sesame Street characters: ERNIE, Grover, Big Bird.
Training a language model normally means predicting the next word, and that forces a single direction: a model allowed to see what follows would simply be handed the answer. BERT changes the exercise. It hides about 15 per cent of the tokens token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. in a text and trains the model to restore each one from everything around it, on both sides (Devlin et al., 2019). Nothing is being generated here, so nothing is spoiled by reading ahead.
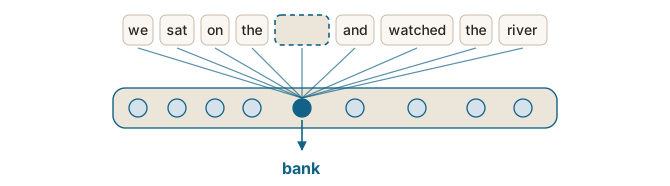
Every layer of the model therefore draws on both sides at once. The architecture underneath makes that possible (see also the Attention & transformers chapter) (voir aussi le chapitre Attention et transformeurs).
BERT reported new best results on eleven language-processing tasks, and this methodology became the standard: pretrain one model on raw text, then fine-tune it for each task. For translation, where the whole source text is there before any output is produced, reading it in both directions is the natural design.
What it costs
Two things.
- Computation. A fresh vector per occurrence, from the whole sentence, costs far more than looking up a stored one, so these models need serious hardware.
- Inspection. A static embedding table could at least be examined word by word. Contextual representations exist only inside a running model, one more step away from anything a person can read (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
The field judged the accuracy worth both.
The generator screen is the hinge to séance 3: a generator only ever sees what came before, which is why it commits to words it cannot revise. Worth naming now, so that behaviour is expected rather than surprising when the chatbots arrive.
What pretraining leaves you with
Pretraining leaves you with a model that turns any sentence into contextual embeddings contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. . It knows a great deal about the language it read and nothing about any particular task, which makes it worth keeping: one expensive training run, then many uses.
Two ways to use it
Its embeddings can be taken as they are and fed into a model of your own, which is how ELMo was used. Or the whole model can be kept and fine-tuned: a small output layer is added and trained on labelled examples for one task, so that what the model learned about language carries over to it (Devlin et al., 2019) (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML). Sentiment analysis, named-entity recognition and question answering were all built that way, and the task-specific training is small beside the pretraining.
That recipe still applies to a model like BERT. For large generative models, much of what once took a fine-tuned model of its own is now done by putting examples in the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. instead (Brown et al., 2020) (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
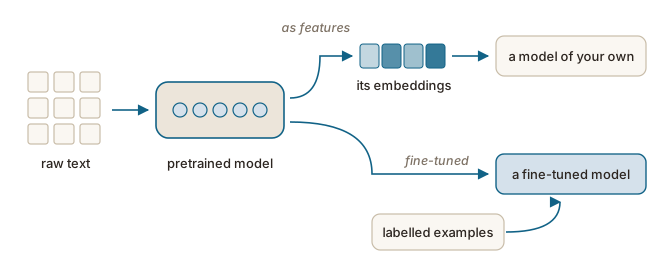
Two routes off one model: its embeddings as features, or the model itself fine-tuned. Say which one BERT made standard, and that the pretraining is the expensive half.
Trois phrases, un seul mot
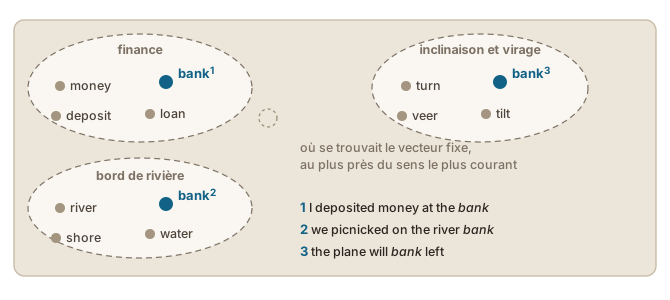
Prenons trois phrases contenant bank :
- I deposited money at the bank.
- We picnicked on the river bank.
- The plane will bank left.
Vous traduiriez le mot de trois façons différentes : banque, rive, virer. Un plongement fixe donne le même vecteur aux trois.
Un vecteur par occurrence
Un plongement contextuel donne raison à la traductrice ou au traducteur. Au lieu de conserver un vecteur tout fait par mot, le modèle calcule un vecteur pour chaque occurrence, au moment de l’usage, à partir de toute la phrase qui l’entoure :
- le bank voisin de deposited et de money ressort près du vocabulaire de la finance ;
- celui qui voisine avec river et picnicked, près de la géographie ;
- celui qui suit will, du côté des verbes.
Même mot, trois vecteurs, chacun façonné par sa compagnie. Les modèles qui fonctionnent ainsi arrivent à la fin des années 2010, et ELMo en est le jalon (Peters et al., 2018).
C’est aussi ici que la matière cesse d’être de l’apprentissage automatique machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. en général pour devenir de l’apprentissage profond deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. . Word2vec gardait son modèle délibérément simple, ce qui lui a permis de s’entraîner sur des milliards de mots (Mikolov et al., 2013a). Calculer un vecteur pour chaque occurrence demande au contraire de nombreuses couches, et l’article d’ELMo le dit dans son titre, Deep contextualized word representations.
Ce que devient la polysémie
Personne ne dresse la liste des sens de bank ni n’écrit de règle pour en choisir un. Les sens cessent simplement d’être fusionnés, parce qu’il ne reste aucun vecteur unique dans lequel les fusionner.
Une conséquence passe facilement inaperçue. Un mot n’a plus « son vecteur », celui qu’on pourrait imprimer dans un tableau. Il a un vecteur dans chaque phrase, si bien que la question « que pense le modèle du sens de bank ? » n’admet que des réponses de la forme « ici, dans cette phrase ». Le sens d’un mot hors contexte, ce que consigne un dictionnaire, a discrètement quitté le système.
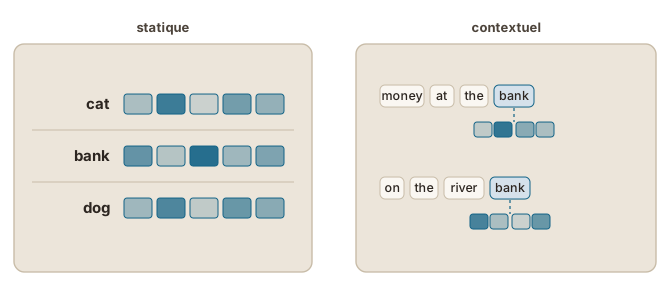
Trois phrases au tableau d’abord : I deposited money at the bank, we picnicked on the river bank, the plane will bank left. Demander la traduction française de chacune. Puis la figure : le groupe vient de faire ce que fait le modèle.
Avant ou après
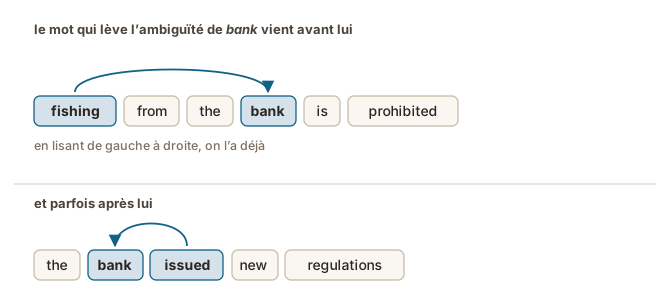
Où se trouve le mot qui lève l’ambiguïté ? Parfois avant le mot ambigu : dans fishing from the bank is prohibited, fishing a déjà fixé le sens quand bank arrive. Parfois après lui : dans the bank issued new regulations, le mot décisif ne vient qu’une fois bank lu.
Lire dans les deux sens
ELMo utilisait déjà les deux côtés, mais superficiellement : un modèle lisait la phrase de gauche à droite, un second la lisait de droite à gauche, et leurs sorties étaient réunies à la fin, si bien que les deux sens ne se rencontraient jamais pendant l’entraînement (Devlin et al., 2019).
BERT est le modèle qui a réuni les deux.ELMo et BERT ont lancé une mode, et les acronymes qui ont suivi ont été tordus pour tomber sur des personnages de Sesame Street : ERNIE, Grover, Big Bird.
Entraîner un modèle de langue veut normalement dire prédire le mot suivant, et cela impose un sens unique : un modèle autorisé à voir ce qui suit se verrait simplement donner la réponse. BERT change l’exercice. Il masque environ 15 % des jetons token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. d’un texte et entraîne le modèle à rétablir chacun d’eux à partir de tout ce qui l’entoure, des deux côtés (Devlin et al., 2019). Rien n’est produit ici, donc rien n’est gâché si le modèle lit plus loin.
Chaque couche du modèle puise donc des deux côtés à la fois. L’architecture sous-jacente rend cela possible (see also the Attention & transformers chapter) (voir aussi le chapitre Attention et transformeurs).
BERT a établi de nouveaux records sur onze tâches de traitement de la langue, et cette méthodologie est devenue la norme : préentraîner un modèle sur du texte brut, puis l’affiner pour chaque tâche. En traduction, où tout le texte de départ est là avant qu’aucune sortie ne soit produite, le lire dans les deux sens est la conception naturelle.
Ce que cela coûte
Deux choses.
- Le calcul. Un vecteur neuf par occurrence, à partir de toute la phrase, coûte bien plus cher que d’en consulter un déjà rangé : ces modèles exigent donc du matériel sérieux.
- L’inspection. Une table de plongements statiques pouvait au moins s’examiner mot à mot. Les représentations contextuelles n’existent qu’à l’intérieur d’un modèle en train de tourner, un cran plus loin encore de ce qu’une personne peut lire (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
Le domaine a jugé que la précision valait les deux.
L’écran sur le générateur est la charnière vers la séance 3 : un générateur ne voit jamais que ce qui précède, et c’est pourquoi il s’engage sur des mots qu’il ne peut pas réviser. Cela vaut la peine de le nommer maintenant, pour que ce comportement soit attendu plutôt que surprenant quand les agents conversationnels arriveront.
Ce que laisse le préentraînement
Le préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. laisse un modèle qui transforme n’importe quelle phrase en plongements contextuels contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. . Il en sait beaucoup sur la langue qu’il a lue et rien sur une tâche particulière, ce qui le rend précieux : un entraînement coûteux, puis de nombreux usages.
Deux façons de s’en servir
Ses plongements peuvent être pris tels quels et fournis à un modèle à vous, comme ELMo était utilisé. Ou le modèle entier peut être conservé et affiné (fine-tuning, aussi appelé réglage fin) : on y ajoute une petite couche de sortie, entraînée sur des exemples annotés pour une seule tâche, de sorte que ce que le modèle a appris de la langue lui profite (Devlin et al., 2019) (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML). L’analyse de sentiments, la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. et la réponse aux questions ont toutes été construites ainsi, et l’entraînement propre à la tâche est petit à côté du préentraînement.
Cette recette s’applique toujours à un modèle comme BERT. Pour les grands modèles génératifs, une bonne part de ce qui demandait autrefois un modèle affiné à part se fait maintenant en mettant des exemples dans la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. (Brown et al., 2020) (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
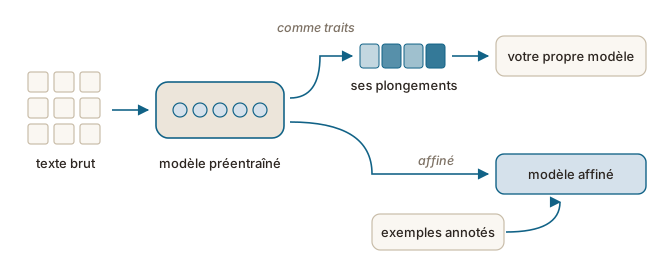
Deux voies à partir d’un seul modèle : ses plongements comme traits, ou le modèle lui-même affiné. Dire laquelle BERT a rendue standard, et que le préentraînement est la moitié coûteuse.