This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Language as numbersLe langage en nombres
Attention & transformersAttention et transformeurs
Language as numbersLe langage en nombres
Attention & transformersAttention et transformeurs
The bottleneckLe goulot d'étranglement
All words at onceTous les mots à la fois
AttentionL'attention
Encoders and decodersEncodeurs et décodeurs
Scale and the context windowL'échelle et la fenêtre contextuelle
The impact on machine translationL'incidence sur la traduction automatique
Context matters
Texts are full of context-dependent choices and interpretations, at every
scale:
the word that settles an ambiguity, thirty words earlier in the same sentence;
the latter, referring to something named three sentences ago;
a pronoun pointing back two paragraphs;
a term defined in the introduction and used throughout.
One pass, and no going back
Before the transformer, a model read a sentence the way it arrives: one word at
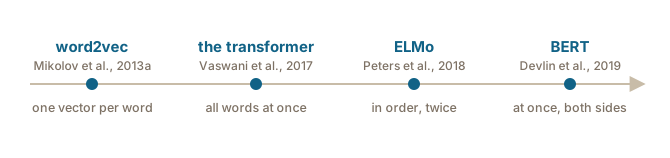
a time, updating a running summary as it went. ELMo was still built that way in
2018, with two passes over the sentence, each of them one word at a time
(Peters et al., 2018).
That sounds natural, because it is how you read too. You commit as you go, and
a later word sometimes breaks the reading you committed to: the horse raced
past the barn fell sends you back to the beginning. Sentences like that are
called garden-path sentences, tricking you into one reading at the beginning
and making you reconsider at the end. Without the ability to go backwards,
models would not be able to deal with this.
Processing one word at a time in order has a structural weakness as well.
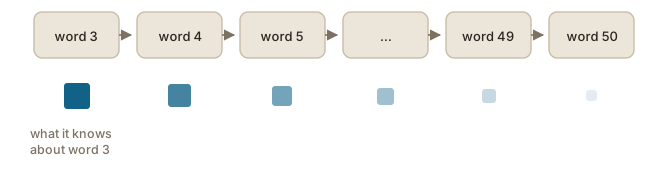
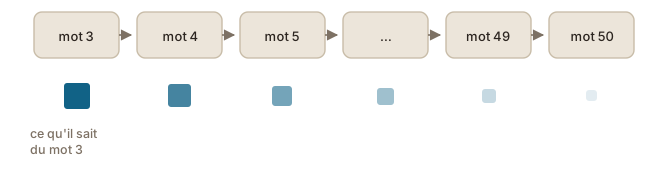
Everything the model knows about word 3 has to survive, inside that running
summary, through the processing of words 4, 5 and 6 to matter at word 50. Each step blurs it a little, like a game of broken
telephone.A party game: one player whispers a phrase to the next
along a line, each passing on what they think they heard, and the last says
aloud what reached them. Over a short span the message arrives; over
a long one what arrives is a paraphrase of a paraphrase.
Figure 1. Word 3 reaching word 50 through every step in between.
The bottleneck
What it cost a translator
sentence by sentence: the quality was respectable
anything that needed memory of the earlier text fell apart
consistent terminology included
The links a text reaches back over are the hook, and the sentence is the
scale to keep it at. Then the relay:
everything the model knows about word 3 has to survive the processing of
words 4, 5 and 6 to matter at word 50, and each step blurs it. The fix of
2017 did not improve the running summary, it removed it.
All words at once
Attention is all you need
The 2017 paper that changed the field has its thesis in its title: “Attention
Is All You Need” (Vaswani et al., 2017). The architecture it introduced, the
transformer, drops reading order entirely. All the words of the input are
processed at the same time, and each word can draw information directly from
any other, whatever the distance between them. The first word of a long sentence no
longer has to survive a relay to reach the last: the two are one connection
apart.
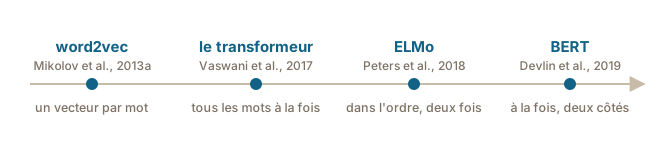
Figure 2. The order they arrived in. ELMo came after the transformer without using it; BERT is built on it, which is how it reads a whole sentence at once.
What about word order?
Dropping sequence creates an obvious problem. If nothing is processed “first”,
how does the model know that the dog follows Jean differs from Jean follows
the dog? The words alone no longer say.
The transformer’s answer is to make position part of each word’s
representation. Before processing starts, every word’s vector is combined with
a numerical encoding of where in the text it sits, like page numbers on a
manuscript that has been taken apart: the pages can then be handled in any
order without the original arrangement being lost.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. The sentence arrives in order, each word is given its position, and from then on the arrangement no longer keeps that order: only the positional encoding remembers it, while the words are processed all at once, each connected to every other.
All words at once
The title of the paper is the thesis: “Attention Is All You Need”. Then the
problem dropping sequence creates: if nothing is processed first, what tells
the model that the dog follows Jean differs from Jean follows the dog?
Page numbers on a manuscript taken apart.
Attention
But which context?
Reading in both directions settled one question, whether the word that decides
comes before or after (see also the Contextual embeddings chapter) (voir aussi le chapitre Plongements contextuels).
It leaves another. Once every word is connected to every other, not all of
those connections are worth the same, and the more context there is, the less
of it counts equally.
Reading the bank was steep, you connect bank with steep and settle on the
riverside sense without noticing you did it. The attention mechanism is the
transformer’s version of that reflex: for each word, attention weights say how
much every other word in the text should influence its representation.
Too tired, too wide
The classic demonstration comes from the transformer paper itself (Vaswani et
al., 2017; visualization by Vig, 2019). Compare:
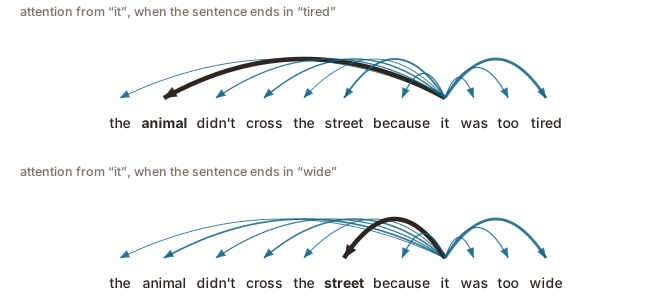
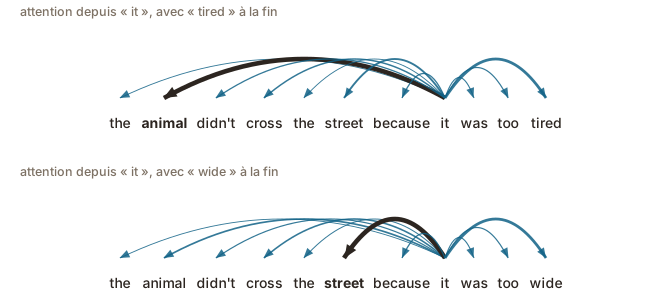
the animal didn’t cross the street because it was too tired
the animal didn’t cross the street because it was too wide
Changing a single word at the very end changes the meaning of the whole
sentence, by changing which word we link it to: a tired it is the animal, a
wide it is the street. Inside a trained transformer, the attention weights
from it visibly shift between the two sentences, toward animal in the first
and toward street in the second.
Figure 4. Attention from the pronoun to every word of the sentence, thicker where the weight is higher. One changed word at the end moves the heaviest arc from the animal to the street. Drawn after the visualization in Vig (2019).
Nobody programmed the fact that streets are wide and animals get tired. That
came out of patterns across millions of sentences: the distributional idea
again, now applied to relationships inside a sentence rather than to which
words resemble each other.
Learned once, worked out every time
Two different things are called weights here, and they are worth telling
apart.
The attention weights are worked out. They say how much each word of the
text at hand should draw on each other word. The model computes them from
those words, using the weights it learned, and computes them again for the
next text. Nothing about the model changes while it does.
So the arcs in the figure above were not stored anywhere and looked up. They
were computed for that sentence, and the other sentence gives other arcs.
This is the machinery the contextual-embeddings chapter left unexplained: the
vector for this occurrence of bank is assembled from the words its attention
selected, in the proportions it
learned (see also the Contextual embeddings chapter) (voir aussi le chapitre Plongements contextuels).
So what is self-attention?
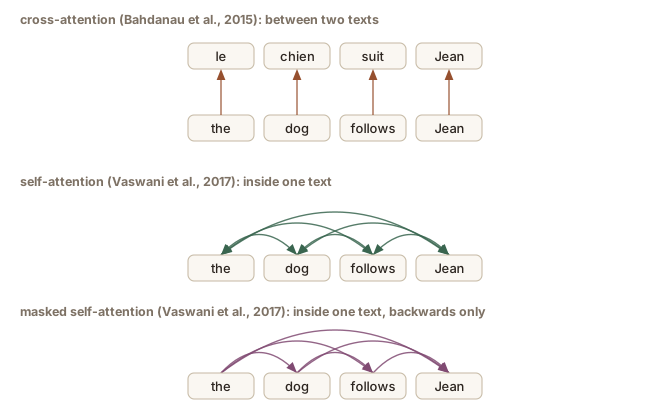
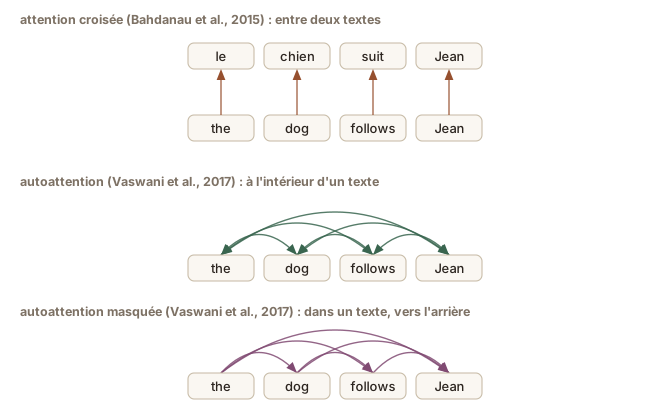
Attention always runs between two sets of words: the ones being given a
representation, and the ones they draw on. Self-attention is the case where
both sets are the same text. That happens everywhere above, each word
of the sentence weighted against the other words of that same sentence.
The other case runs between two different texts, a source and the translation
being written from
it (see also the Encoders and decoders page) (voir aussi la page Encodeurs et décodeurs).
That use came first: attention was built for translation (Bahdanau et al.,
2015), and the step taken in 2017 was to use it inside a single text as well
(Vaswani et al., 2017).
Figure 5. The same mechanism in the three configurations a translator is likely to come across, in the order they appeared. Each keeps its colour wherever it turns up again. Others exist and are left aside here.
the model’s weights are learned: everything it picked up from its
training text is in them, and they stop changing when training ends
the attention weights are worked out every time, from the words in
front of the model: how much each word draws on each other word, here
nobody programmed that streets are wide and animals get tired
Attention
Attention
Read the two sentences out and let the room feel it change owners before
showing the figure. This is also the answer the contextual-embeddings
chapter owed them: the vector for this occurrence of bank is assembled
from the words its attention selected, in the proportions it learned.
The encoder takes the source and turns it into contextual
representations, all words at the same time.
The decoder writes the target one word at a time, and at each word it
looks in two directions: back over what it has already written, and across at
the encoder’s representations of the source.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 6. Simplified schematic of an encoder-decoder mechanism, illustrated with a translation task.
Figure 6figure 6 follows
one sentence through both halves, le chien suit Jean becoming the dog
follows Jean, caught at the moment the decoder produces follows. Training is
over by then, so the figure shows one pass through a finished
model (see also the Attention page) (voir aussi la page L'attention).
Training a translation model in the first place is a subject of its
own (see also the What machine translation is chapter, in the Machine translation module) (voir aussi le chapitre Qu'est-ce que la traduction automatique, dans le module Traduction automatique).
Back, with masked self-attention. That same vector also draws on what the
decoder has already written, the and dog. The fourth slot is empty,
because the words after the one being produced do not exist yet, so attention
over the target runs backwards only.
Out of the decoder. The finished vector is mapped back to a word.
Direction belongs to the attention, not to the turning of words into vectors
and back.
Encoder, decoder, or both?
Both halves are made of the same attention layers, so a model can keep one or
keep both. The choice follows from the shape of the task: what goes in,
and what has to come out.
The line is not a wall. A decoder-only model translates perfectly well when
the source and its translation are given to it as one running text, which
happens whenever a translation is asked of a
chatbot (see also the Machine translation module) (voir aussi le module Traduction automatique).
Encoders and decoders
Encoders and decoders
Encoder, decoder, or both?
encoder only, when the output is not a text: a label, the names in a
document, how close two sentences are
decoder only, when the output continues the input: the chatbot
models, question and answer as one running text
both, when one sequence becomes a different one: translation,
speech recognition, summarization
The alignment figure is the hook for this room: each target word draws on
the source words it renders, learned from examples rather than declared. The
three colours are the three attentions, the same colours as the panel figure
on the previous page. Then the three architectures, from the shape of the
task rather than from the names.
Scale and the context window
Why “large” starts here
a sequential model processes words like one queue
a transformer opens every checkout at once, which is what graphics
processors are built for
training on text collections that were unthinkable in 2016 became routine
Why “large” starts here
The transformer improved quality, and the deeper change was economic. A
sequential model processes words like customers in a single queue: one at a
time, however fast each step is. A transformer opens every checkout lane at
once, which is exactly the workload graphics processors are built for.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 7. Left, each step feeds the next, so the words are worked through in order. Right, nothing waits: every word is worked on in the same step, and every word is connected to every other.
Training on text collections that were unthinkably large in 2016 became
routine within a few years, and model and data sizes grew by orders of
magnitude (Hoffmann et al., 2022). Every system in the LLM lifecycle module is
a transformer at heart (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML); without parallel
processing, “large” would have stayed out of reach.
The cost of attention
Attention weighs every pair of words, so doubling the length of a text roughly
quadruples the work. Somewhere, every model has to cap how much text it
processes at once, and that cap is the context window: the
reason a chatbot loses the thread of a long conversation, and the reason
“translate this 200-page document in one go” is not how any of these systems
works (see also the Counting in tokens page) (voir aussi la page Compter en jetons).
Scale and the context window
Scale and the context window
The cost of attention
attention weighs every pair, so doubling the length quadruples the work
every model caps what it takes at once, and that cap is the context window
why a chatbot loses the thread, and why “translate these 200 pages in one
go” is not how any of this works
Scale and the context window
Attention is not understanding
attention: an anthropomorphic word
high attention between two words: that link served prediction,
and nothing more
simple statistics, at immense scale, imitate real knowledge
does it amount to something more? A serious, open debate.
Close on the aside rather than on the mechanism: high attention between two
words means the training data made that connection useful for prediction,
and nothing more. Whether pattern matching at this scale amounts to
something more is the debate that opens at séance 3.
Read before you translate
When you translate, you need context before you can commit. You cannot start
rendering a sentence on its first word: you read ahead, a few words at least,
to see where it is going. Consider for instance the English-to-French
translation in Figure 8figure 8.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 8. Word by word, English on the left and French on the right. Three choices have to be made before the word that settles them arrives.
Nobody gave the model that map. It worked it out from millions of translated
sentence pairs, four and a half million for the English-German system of the
original paper (Vaswani et al., 2017).
attention settled the long range inside the sentence
translation systems went on working one sentence at a time for years
a term settled in one sentence had no bearing on the next
whole documents waited for long context windows
Build the runner example with the room before the figure: ask for the French
of I’m exhausted, said the runner, and let them find the two commitments
before she arrives.
Le contexte compte
Les textes sont pleins de choix et d’interprétations qui dépendent du contexte,
à toutes les échelles :
le mot qui lève une ambiguïté, trente mots plus tôt dans la même phrase ;
ce dernier, qui renvoie à quelque chose nommé trois phrases plus haut ;
un pronom qui renvoie deux paragraphes en arrière ;
un terme défini dans l’introduction et employé partout ensuite.
Un seul passage, sans retour
Avant le transformeur, un modèle lisait une phrase telle qu’elle arrive : un
mot à la fois, en mettant à jour un résumé courant à mesure. ELMo était encore
construit ainsi en 2018, avec deux passages sur la phrase, chacun un mot à la
fois (Peters et al., 2018).
Cela paraît naturel, parce que c’est aussi votre façon de lire. Vous vous
engagez à mesure, et un mot plus loin brise parfois la lecture à laquelle vous
vous étiez engagé : the horse raced past the barn fell vous renvoie au début.
On appelle ces phrases des phrases-pièges : elles vous entraînent vers une
première lecture, puis vous forcent à revenir sur elle à la fin. Sans la
possibilité de revenir en arrière, les modèles ne sauraient pas s’en tirer.
Traiter un mot à la fois, dans l’ordre, a aussi une faiblesse structurelle.
Tout ce que le modèle sait du mot 3 doit survivre, dans ce résumé courant, au
traitement des mots 4, 5 et 6 pour compter encore au mot 50. Chaque étape le
brouille un peu, comme au téléphone
arabe.Un jeu de société : un joueur chuchote une phrase au suivant le
long d’une file, chacun transmet ce qu’il croit avoir entendu, et le dernier
dit à voix haute ce qui lui est parvenu. Sur une courte distance, le
message arrive ; sur une longue, il n’arrive plus que la paraphrase d’une
paraphrase.
Figure 1. Le mot 3 atteignant le mot 50 en passant par toutes les étapes intermédiaires.
Le goulot d'étranglement
Ce que cela coûtait en traduction
phrase par phrase : la qualité était correcte
tout ce qui demandait la mémoire du texte antérieur s’effondrait
terminologie cohérente comprise
Les liens sur lesquels un texte revient sont l’accroche, et la phrase est
l’échelle à laquelle s’en tenir. Puis le relais : tout ce que le modèle sait
du mot 3 doit survivre au traitement des mots 4, 5 et 6 pour compter encore
au mot 50, et chaque étape le brouille. Le correctif de 2017 n’a pas
amélioré le résumé courant, il l’a supprimé.
Tous les mots à la fois
Attention is all you need
L’article de 2017 qui a changé le domaine annonce sa thèse dans son titre :
« Attention Is All You Need » (Vaswani et al., 2017). L’architecture qu’il
présente, le transformeur, abandonne complètement l’ordre de lecture. Tous les
mots de l’entrée sont traités en même temps, et chaque mot peut puiser de
l’information directement dans n’importe quel autre, quelle que soit la
distance. Le premier mot d’une longue phrase n’a plus à survivre à une course
de relais pour atteindre le dernier : les deux sont à une seule connexion l’un
de l’autre.
Figure 2. L'ordre dans lequel ils sont arrivés. ELMo vient après le transformeur sans s'en servir ; BERT est construit sur lui, et c'est ainsi qu'il lit une phrase entière d'un coup.
Et l’ordre des mots ?
Abandonner la séquence crée un problème évident. Si rien n’est traité « en
premier », comment le modèle sait-il que le chien suit Jean diffère de Jean
suit le chien ? Les mots seuls ne le disent plus.
La réponse du transformeur est de faire de la position une partie de la
représentation de chaque mot. Avant que le traitement commence, le vecteur de
chaque mot est combiné à un encodage numérique de sa place dans le texte, comme
des numéros de page sur un manuscrit qu’on a défait : les pages peuvent ensuite
être manipulées dans n’importe quel ordre sans que l’agencement d’origine soit
perdu.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. La phrase arrive dans l'ordre, chaque mot reçoit sa position, et à partir de là l'agencement ne conserve plus cet ordre : seul l'encodage positionnel s'en souvient, tandis que les mots sont traités tous à la fois, chacun relié à tous les autres.
Tous les mots à la fois
Le titre de l’article est la thèse : « Attention Is All You Need ». Puis le
problème que crée l’abandon de la séquence : si rien n’est traité en premier,
qu’est-ce qui dit au modèle que le chien suit Jean diffère de Jean suit le
chien ? Des numéros de page sur un manuscrit défait.
L'attention
Mais quel contexte ?
Lire dans les deux sens a réglé une question, celle de savoir si le mot décisif
vient avant ou après (see also the Contextual embeddings chapter) (voir aussi le chapitre Plongements contextuels).
Il en reste une autre. Dès que chaque mot est relié à tous les autres, toutes
ces liaisons ne valent pas la même chose, et plus il y a de contexte, moins toutes ses
parties comptent autant.
En lisant the bank was steep, vous rapprochez bank de steep et vous
retenez le sens du bord de rivière sans vous en apercevoir. Le mécanisme
d’attention est la version qu’en donne le transformeur : pour chaque mot, des
poids d’attention disent à quel point chacun des autres mots du texte doit
influencer sa représentation.
Trop fatigué, trop large
La démonstration classique vient de l’article même du transformeur (Vaswani et
al., 2017 ; visualisation de Vig, 2019). Comparez :
the animal didn’t cross the street because it was too tired
the animal didn’t cross the street because it was too wide
Changer un seul mot tout à la fin change le sens de la phrase entière, en
changeant le mot auquel on rattache it : un it fatigué est l’animal, un
it large est la rue. Dans un transformeur entraîné, les poids d’attention
depuis it se déplacent visiblement entre les deux phrases, vers animal dans
la première et vers street dans la seconde.
Figure 4. L'attention depuis le pronom vers chaque mot de la phrase, plus épaisse là où le poids est plus élevé. Un seul mot changé à la fin déplace l'arc le plus épais de l'animal vers la rue. D'après la visualisation de Vig (2019).
Personne n’a programmé le fait que les rues sont larges et que les animaux se
fatiguent. Cela est ressorti de motifs relevés dans des millions de phrases :
l’idée distributionnelle de nouveau, appliquée cette fois aux relations à
l’intérieur d’une phrase plutôt qu’à la ressemblance entre les mots.
Appris une fois, établi chaque fois
Deux choses différentes s’appellent ici des poids, et elles valent la peine
d’être distinguées.
Les poids d’attention sont établis. Ils disent à quel point chaque mot du
texte en cours doit puiser dans chacun des autres. Le modèle les calcule à
partir de ces mots, avec les poids qu’il a appris, et les calcule de nouveau
pour le texte suivant. Rien du modèle ne change pendant ce temps.
Les arcs de la figure ci-dessus n’étaient donc rangés nulle part avant d’être
consultés. Ils ont été calculés pour cette phrase, et l’autre phrase donne
d’autres arcs.
C’est le mécanisme que le chapitre sur les plongements contextuels laissait
inexpliqué : le vecteur de cette occurrence de bank est assemblé à partir des
mots que son attention a retenus, dans les proportions
apprises (see also the Contextual embeddings chapter) (voir aussi le chapitre Plongements contextuels).
Alors, qu’est-ce que l’autoattention ?
L’attention s’exerce toujours entre deux ensembles de mots : ceux à qui l’on donne
une représentation, et ceux dans lesquels ils puisent. L’autoattention est le
cas où les deux ensembles sont le même texte. C’est ce qui se passe partout
ci-dessus, chaque mot de la phrase pesé par rapport aux autres mots de cette
même phrase.
Dans l’autre cas, elle s’exerce entre deux textes différents, un texte de départ et la
traduction qu’on en
écrit (see also the Encoders and decoders page) (voir aussi la page Encodeurs et décodeurs).
Cet usage est venu le premier : l’attention a été conçue pour la traduction
(Bahdanau et al., 2015), et le pas franchi en 2017 a été de s’en servir aussi à
l’intérieur d’un seul texte (Vaswani et al., 2017).
Figure 5. Le même mécanisme dans les trois configurations qu'une traductrice ou un traducteur est susceptible de rencontrer, dans l'ordre de leur apparition. Chacune garde sa couleur partout où elle réapparaît. D'autres existent et sont laissées de côté ici.
les poids du modèle sont appris : tout ce qu’il a retenu de ses textes
d’entraînement s’y trouve, et ils cessent de changer quand l’entraînement
se termine
les poids d’attention sont établis chaque fois, à partir des mots
devant le modèle : à quel point chaque mot puise dans chacun des autres,
ici
personne n’a programmé que les rues sont larges et que les animaux se
fatiguent
L'attention
L'attention
Lire les deux phrases à voix haute et laisser le groupe sentir it changer
de propriétaire avant de montrer la figure. C’est aussi la réponse que le
chapitre sur les plongements contextuels leur devait : le vecteur de cette
occurrence de bank est assemblé à partir des mots que son attention a
retenus, dans les proportions apprises.
L’encodeur prend le texte de départ et le transforme en représentations
contextuelles, tous les mots en même temps.
Le décodeur écrit le texte d’arrivée un mot à la fois, et à chaque mot il
regarde dans deux directions : en arrière sur ce qu’il a déjà écrit, et de
l’autre côté vers les représentations du texte de départ produites par
l’encodeur.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 6. Schéma simplifié d'un mécanisme encodeur-décodeur, illustré par une tâche de traduction.
La Figure 6figure 6 suit
une phrase à travers les deux moitiés, le chien suit Jean devenant the dog
follows Jean, saisie au moment où le décodeur produit follows.
L’entraînement est terminé à ce stade : la figure montre donc un seul passage
dans un modèle
achevé (see also the Attention page) (voir aussi la page L'attention).
L’entraînement d’un modèle de traduction est un sujet à part
entière (see also the What machine translation is chapter, in the Machine translation module) (voir aussi le chapitre Qu'est-ce que la traduction automatique, dans le module Traduction automatique).
En arrière, avec l’autoattention masquée. Ce même vecteur puise aussi
dans ce que le décodeur a déjà écrit, the et dog. La quatrième place est
vide, parce que les mots qui suivent celui qu’on produit n’existent pas
encore : l’attention sur le texte d’arrivée ne va donc que vers l’arrière.
Hors du décodeur. Le vecteur terminé est ramené à un mot.
La direction appartient à l’attention, non au passage des mots aux vecteurs et
des vecteurs aux mots.
Encodeur, décodeur ou les deux ?
Les deux moitiés sont faites des mêmes couches d’attention : un modèle peut
donc n’en garder qu’une, ou garder les deux. Le choix découle de la forme de la
tâche : ce qui entre, et ce qui doit sortir.
La frontière n’est pas un mur. Un modèle à décodeur seul traduit très bien
quand le texte de départ et sa traduction lui sont donnés comme un seul texte
courant, ce qui arrive chaque fois qu’on demande une traduction à un agent
conversationnel (see also the Machine translation module) (voir aussi le module Traduction automatique).
Encodeurs et décodeurs
Encodeurs et décodeurs
Encodeur, décodeur ou les deux ?
l’encodeur seul, quand la sortie n’est pas un texte : une étiquette,
les noms propres d’un document, la proximité de deux phrases
le décodeur seul, quand la sortie prolonge l’entrée : les modèles
derrière les agents conversationnels, question et réponse en un seul texte
courant
les deux, quand une séquence devient une séquence différente :
traduction, reconnaissance de la parole, résumé automatique
La figure de l’alignement est l’accroche pour ce groupe : chaque mot
d’arrivée puise dans les mots de départ qu’il rend, appris sur des exemples
plutôt que déclarés. Les trois couleurs sont les trois attentions, les mêmes
que dans la figure à trois panneaux de la page précédente. Puis les trois
architectures, à partir de la forme de la tâche plutôt que des noms.
L'échelle et la fenêtre contextuelle
Pourquoi le « grand » commence ici
un modèle séquentiel traite les mots comme une seule file
un transformeur ouvre toutes les caisses en même temps, ce pour quoi
les processeurs graphiques sont faits
entraîner sur des ensembles de textes d’une taille inimaginable en 2016 est devenu
courant
Pourquoi le « grand » commence ici
Le transformeur a amélioré la qualité, et le changement le plus profond a été
économique. Un modèle séquentiel traite les mots comme des clients dans une
seule file : un à la fois, aussi rapide que soit chaque étape. Un transformeur
ouvre toutes les caisses en même temps, ce qui est exactement la charge de
travail pour laquelle les processeurs graphiques sont faits.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 7. À gauche, chaque étape alimente la suivante : les mots sont donc traités dans l'ordre. À droite, rien n'attend : tous les mots sont traités à la même étape, et chaque mot est relié à tous les autres.
Entraîner sur des ensembles de textes d’une taille inimaginable en 2016 est devenu courant
en quelques années, et la taille des modèles comme celle des données ont
augmenté de plusieurs ordres de grandeur (Hoffmann et al., 2022). Tous les
systèmes du module sur le cycle de vie des GML sont des transformeurs au
fond (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML) ; sans le traitement parallèle, le « grand »
serait resté hors de portée.
Le coût de l’attention
L’attention pèse chaque paire de mots : doubler la longueur d’un texte
quadruple donc à peu près le travail. Chaque modèle doit plafonner quelque part
la quantité de texte qu’il traite d’un coup, et ce plafond est la fenêtre
contextuelle : la raison pour laquelle un agent conversationnel perd le fil
d’une longue conversation, et la raison pour laquelle « traduis-moi ce document
de 200 pages d’un coup » n’est pas la façon dont ces systèmes
fonctionnent (see also the Counting in tokens page) (voir aussi la page Compter en jetons).
L'échelle et la fenêtre contextuelle
L'échelle et la fenêtre contextuelle
Le coût de l’attention
l’attention pèse chaque paire : doubler la longueur quadruple le
travail
chaque modèle plafonne ce qu’il prend d’un coup, et ce plafond est la
fenêtre contextuelle
pourquoi un agent conversationnel perd le fil, et pourquoi « traduis-moi
ces 200 pages d’un coup » n’est pas ainsi que cela fonctionne
L'échelle et la fenêtre contextuelle
L’attention n’est pas la compréhension
attention : un mot anthropomorphique
attention élevée entre deux mots : cette liaison sert la prédiction,
et rien de plus
des statistiques simples, à des échelles immenses, imitent une
véritable connaissance
équivaut-elle à quelque chose de plus ? Un débat sérieux et ouvert.
Fermer sur l’encadré plutôt que sur le mécanisme : une attention élevée entre
deux mots signifie que les données d’entraînement ont rendu cette liaison
utile à la prédiction, et rien de plus. Savoir si la reconnaissance de motifs
à cette échelle équivaut à quelque chose de plus est le débat qui s’ouvre à
la séance 3.
Lire avant de traduire
Quand vous traduisez, il vous faut du contexte avant de pouvoir vous engager.
Vous ne pouvez pas commencer à rendre une phrase dès son premier mot : vous
lisez plus loin, quelques mots au moins, pour voir où elle va. Prenez par
exemple la traduction de l’anglais vers le français de la
Figure 8figure 8.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 8. Mot à mot, l'anglais à gauche et le français à droite. Trois choix doivent être faits avant que le mot qui les règle arrive.
Personne n’a donné cette carte au modèle. Il l’a établie à partir de millions
de paires de phrases traduites, quatre millions et demi pour le système
anglais-allemand de l’article d’origine (Vaswani et al., 2017).
l’attention a réglé la longue portée à l’intérieur de la phrase
les systèmes de traduction ont continué à travailler une phrase à la
fois pendant des années
un terme réglé dans une phrase n’avait aucune portée sur la suivante
les documents entiers ont attendu les longues fenêtres contextuelles
Construire l’exemple de la coureuse avec le groupe avant la figure :
demander la traduction française de I’m exhausted, said the runner, et les
laisser trouver les engagements pris avant que she arrive.
The page behind this slideLa page derrière cette diapositive
1 / 2The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter