PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
A number for each wordUn nombre par mot
If words have to become numbers, the obvious first move is a list: a
dictionary with its entries numbered.
Every word now has a number, and the conversion is trivial in both
directions. But, as Figure 1figure 1 shows,
there are three specific issues, where such numbers miss some essential part
of what would make them useful.
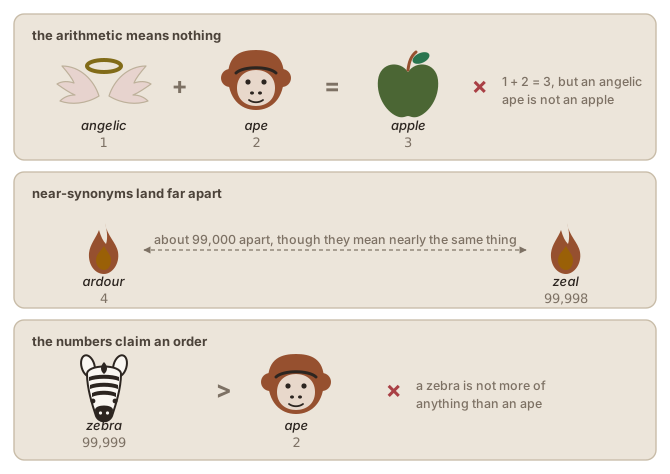
Figure 1. Three issues with one number per word: the arithmetic means nothing, near-synonyms land far apart, and the numbers claim an order the words do not have.
Arithmetic on these numbers is meaningless. One plus two is three, so an
angelic (1) ape (2) makes an apple (3)? Any calculation a system
performs on the codes manipulates alphabetical position, which has nothing
to do with what the words mean.
The numbers place related words no closer than unrelated ones. Ardour (4)
and zeal (99,998) are near-synonyms sitting about 99,000 apart, farther
from each other than either is from apple. A translation system needs
exactly the opposite: words with similar meanings should have similar
representations.
A single number per word smuggles in an ordering. 99,999 is bigger than 2,
but zebra is not more of anything than ape. A model fed these codes
risks attaching meaning to the size of the number, where the only thing
behind it is alphabetical order.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Si les mots doivent devenir des nombres, le premier réflexe est d’en faire une
liste : un dictionnaire dont les entrées sont numérotées.
Chaque mot a maintenant un nombre, et la conversion se fait sans effort dans
les deux sens. Mais, comme le montre la Figure 1figure 1,
trois problèmes précis apparaissent, où de tels nombres passent à côté de ce
qui les rendrait utiles.
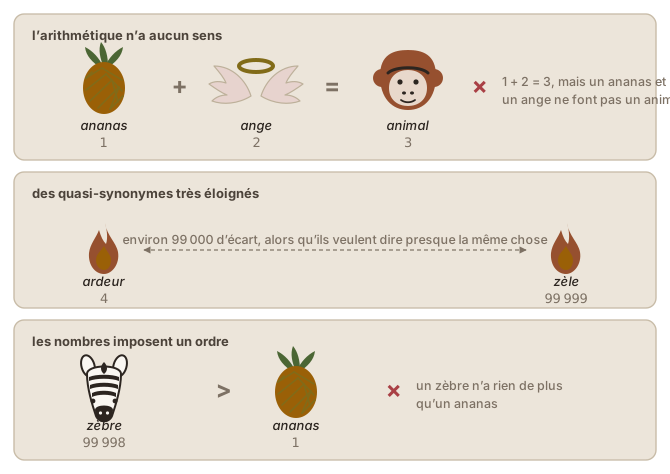
Figure 1. Trois problèmes d'un nombre par mot : l'arithmétique n'a aucun sens, des quasi-synonymes se retrouvent très éloignés, et les nombres imposent un ordre que les mots n'ont pas.
L’arithmétique sur ces nombres n’a aucun sens. Un plus deux font trois : un
ananas (1) et un ange (2) donneraient donc un animal (3) ? Tout calcul
effectué sur ces codes manipule une position alphabétique, qui n’a rien à
voir avec le sens des mots.
Les nombres ne rapprochent pas les mots apparentés plus que les mots sans
rapport. Ardeur (4) et zèle (99 999) sont des quasi-synonymes séparés par
environ 99 000, plus loin l’un de l’autre que chacun ne l’est d’animal. Un
système de traduction a besoin exactement de l’inverse : des mots de sens
proches devraient avoir des représentations proches.
Un seul nombre par mot introduit un ordre en douce. 99 998 est plus grand que
1, mais un zèbre n’a rien de plus qu’un ananas. Un modèle nourri de ces
codes risque de prêter un sens à la taille du nombre, alors que la seule chose
derrière elle est l’ordre alphabétique.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
VectorsLes vecteurs
The word vector sounds more technical than what it names.
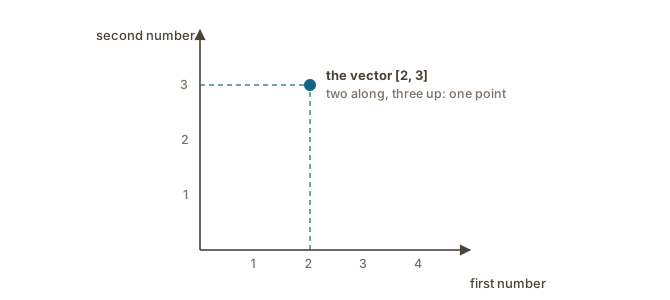
Read [2, 3] as directions on a map: two steps along the horizontal axis,
three along the vertical, and you have marked a point. A vector with three
numbers marks a point in three-dimensional space, and nothing stops a vector
from having three hundred numbers; the space can no longer be drawn or
imagined, but the mathematics works the same way.
Figure 2. A vector read as coordinates: the list [2, 3] marks one point in a two-dimensional space.
Points, unlike bare code numbers, have geometry. Two points can be close
together or far apart; a cluster of points forms a group; a direction in the
space can be followed. If each word is placed at a point, then closeness in
the space becomes available to represent closeness in meaning, which a single
number per word had no way to express.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Le mot vecteur a l’air plus technique que ce qu’il désigne.
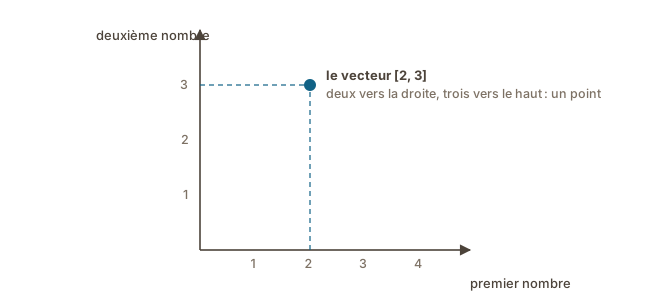
[2, 3] se lit comme des indications sur une carte : deux pas le long de l’axe
horizontal, trois le long de l’axe vertical, et un point est marqué. Un vecteur
de trois nombres marque un point dans un espace à trois dimensions, et rien
n’empêche un vecteur d’avoir trois cents nombres ; l’espace ne peut alors plus
être dessiné ni imaginé, mais les mathématiques fonctionnent de la même façon.
Figure 2. Un vecteur lu comme des coordonnées : la liste [2, 3] marque un point dans un espace à deux dimensions.
Les points, contrairement à de simples numéros de code, ont une géométrie. Deux
points peuvent être proches ou éloignés ; un ensemble de points forme un
groupe ; une direction peut être suivie dans l’espace. Si chaque mot est placé
en un point, la proximité dans l’espace devient disponible pour représenter la
proximité de sens, ce qu’un seul nombre par mot n’avait aucun moyen d’exprimer.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
One-hot vectorsLes vecteurs 1 parmi n
The first vector representation of words that the field actually used works
like a row of switches with one of them on. Each word in a 100,000-word
vocabulary gets its own position, and is represented as a vector of 100,000
numbers: zeros everywhere, except a single 1 at that word’s position.
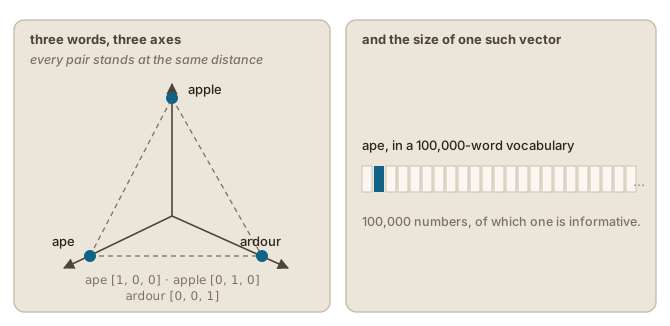
The false ordering is gone. No word’s vector is larger than another’s;
zebra is no longer “more” than ape. In the geometry of the space, each
word now owns its own axis, and every pair of words stands at exactly the
same distance, like the corners of a perfectly symmetric figure.
Figure 3. Each word owns an axis, so no word is larger than another and every pair stands at the same distance. Almost the whole vector is zeros.
Exactly the same distance is also the new problem. Ardour is now precisely
as different from zeal as from zebra: the representation contains no
similarity information at all, for anyone. It identifies words the way a
locker number identifies a student, saying nothing about them.
There is a practical objection too. These vectors are enormous, and almost
all of their content is zeros: 100,000 numbers per word, of which one is
informative.
The numbered list crammed every word onto one axis and invented differences;
the one-hot vector gives every word its own axis and erases all resemblance.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
La première représentation vectorielle des mots que le domaine ait réellement
utilisée fonctionne comme une rangée d’interrupteurs dont un seul est allumé.
Chaque mot d’un vocabulaire de 100 000 mots reçoit sa propre position et est
représenté par un vecteur de 100 000 nombres : des zéros partout, sauf un seul
1 à la position de ce mot.
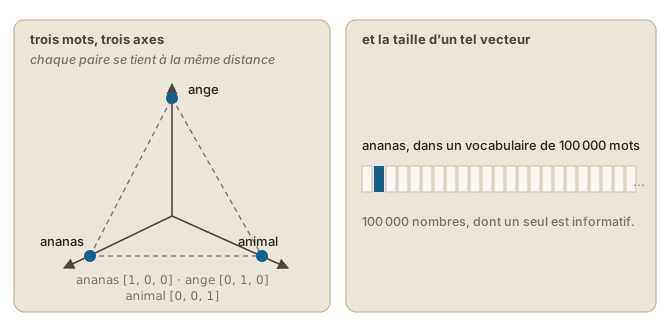
L’ordre trompeur a disparu. Le vecteur d’un mot n’est jamais plus grand que
celui d’un autre ; zèbre n’est plus « plus » qu’ananas. Dans la géométrie de
l’espace, chaque mot possède désormais son propre axe, et chaque paire de mots
se tient exactement à la même distance, comme les sommets d’une figure
parfaitement symétrique.
Figure 3. Chaque mot possède son axe, donc aucun mot n'est plus grand qu'un autre et chaque paire se tient à la même distance. Presque tout le vecteur est fait de zéros.
Cette distance identique est aussi le nouveau problème. Ardeur est maintenant
exactement aussi différent de zèle que de zèbre : la représentation ne
contient aucune information de similarité, pour personne. Elle identifie les
mots comme un numéro de casier identifie un étudiant, sans rien dire de lui.
Il y a aussi une objection pratique. Ces vecteurs sont énormes et leur contenu
est presque entièrement fait de zéros : 100 000 nombres par mot, dont un seul
est informatif.
La liste numérotée entassait tous les mots sur un seul axe et inventait des
différences ; le vecteur 1 parmi n donne à chaque mot son propre axe et efface
toute ressemblance. Ce qu’il faut se situe entre les deux : des vecteurs comptant
un nombre modeste de dimensions, partagées par tous les mots, où les valeurs
placent les mots de sens proches près les uns des autres.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/